
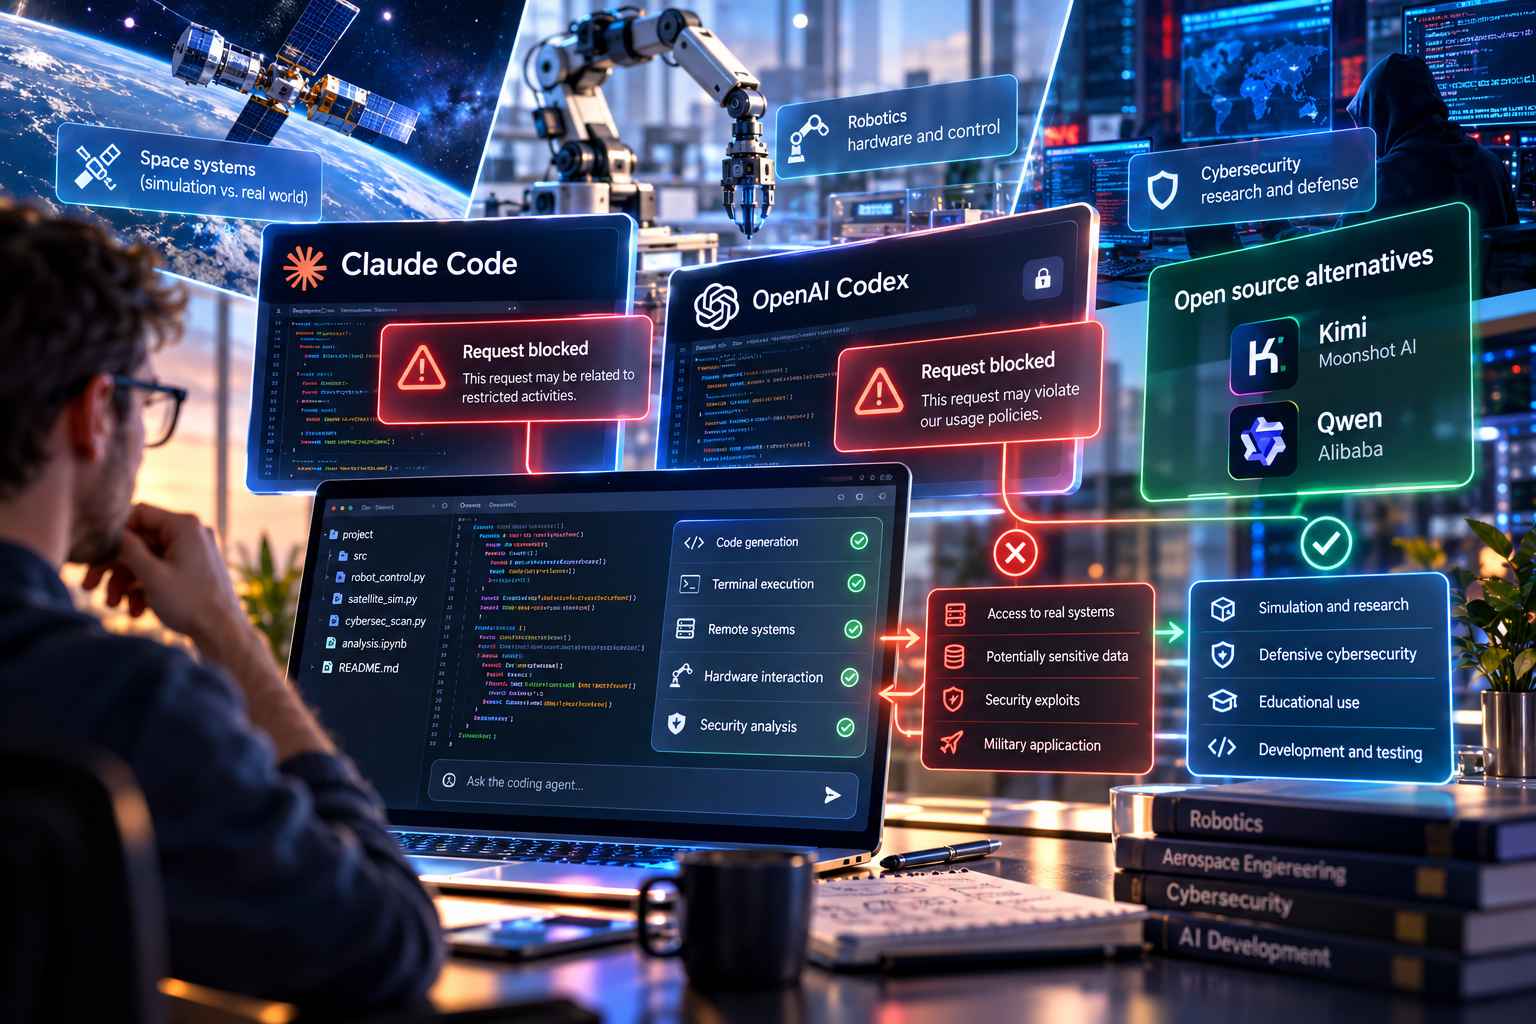
La diffusione di coding agent come Claude Code e Codex sta facendo emergere un problema legato ai sistemi di sicurezza integrati nei modelli: richieste tecnicamente legittime possono essere interpretate come attività pericolose quando contengono riferimenti a infrastrutture, dispositivi fisici, accesso remoto o cybersecurity. Il fenomeno assume un peso crescente perché questi strumenti sono ormai entrati stabilmente nei workflow di sviluppo: secondo la Developer Ecosystem Survey 2026 di JetBrains, condotta su oltre 15.000 professionisti, tra maggio e luglio il 90% degli sviluppatori utilizzava coding agent sul lavoro almeno una volta alla settimana e il 68% quotidianamente. Claude Code risultava utilizzato dal 39% degli sviluppatori professionali a livello globale, mentre Codex era passato dal 3% di adozione registrato a gennaio al 16% nel periodo maggio-luglio. Con agenti sempre più coinvolti direttamente nell’esecuzione di modifiche al codice, nell’uso del terminale e nell’interazione con sistemi esterni, un falso positivo non produce soltanto una risposta mancata ma può interrompere un’intera sequenza operativa.
Tra i casi segnalati compare quello di Alejandro Carrasco, studente di master in ingegneria aerospaziale al MIT, che utilizza agenti AI per controllare veicoli spaziali simulati e ha visto alcune richieste bloccate perché interpretate come potenzialmente collegate ad applicazioni militari o dati sensibili, senza che il modello distinguesse correttamente tra un satellite reale e uno simulato. Problemi analoghi sono stati descritti dallo sviluppatore di robotica Martin Kemka, che ha incontrato rifiuti durante normali attività come la realizzazione dell’interfaccia di un braccio robotico o il collegamento SSH a un altro computer, con un aumento della sensibilità dei filtri quando il software interagisce con hardware fisico o sistemi remoti. Nel campo della cybersecurity il problema è ancora più evidente: Rohan Balkondekar, impegnato nello sviluppo presso Xsolla e VibeGro, ha riferito che anche attività difensive come la revisione di codice open source e la ricerca di vulnerabilità possono attivare le protezioni, costringendo i team a interrompere il workflow o a trasferire il compito verso strumenti differenti.
OpenAI riconosce esplicitamente che questo tipo di interferenza può verificarsi. Con GPT-6 Astra, classificato dall’azienda al livello Critical per le capacità di cybersecurity, sono stati introdotti sistemi aggiuntivi che analizzano ragionamento e azioni degli agenti per individuare comportamenti non autorizzati e possono fermare automaticamente un’attività. OpenAI specifica però che questi controlli supplementari possono rallentare, sospendere o interrompere anche operazioni legittime, compresi lavori di cybersecurity difensiva o compiti non direttamente collegati alla sicurezza informatica. Quando un controllo interviene in ChatGPT o Codex può essere richiesta una revisione dell’azione da parte dell’utente, mentre tramite API l’esecuzione viene arrestata; l’azienda sta quindi continuando a calibrare i sistemi con l’obiettivo di ridurre le interruzioni non necessarie. Anthropic ha adottato un’impostazione analoga, riducendo progressivamente gli interventi sui compiti di individuazione delle vulnerabilità ma mantenendo restrizioni più severe sulle attività che possono essere utilizzate direttamente per comprometterle.
La conseguenza pratica è che alcuni sviluppatori stanno affiancando o sostituendo i modelli chiusi con alternative open source quando i controlli impediscono attività considerate legittime nel proprio contesto operativo. Elvis Saravia, cofondatore di DAIR.AI, ha riferito di aver cancellato il proprio abbonamento Anthropic dopo ripetuti rifiuti, mentre altri sviluppatori utilizzano modelli come Kimi di Moonshot AI o Qwen di Alibaba come alternativa quando un servizio proprietario interrompe il lavoro. La possibilità di eseguire i modelli localmente e adattarne configurazione e comportamento a un ambiente specifico rende queste soluzioni particolarmente interessanti per attività specialistiche, ma il problema centrale resta quello di distinguere in modo sufficientemente affidabile tra una richiesta potenzialmente dannosa e un’operazione tecnicamente simile eseguita per ricerca, sviluppo, simulazione o difesa. Con coding agent sempre più autonomi e coinvolti direttamente nell’esecuzione delle operazioni, la precisione di questo livello di controllo diventa quindi parte integrante delle prestazioni complessive dello strumento, insieme a qualità del codice, latenza e capacità di completare il task.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)