
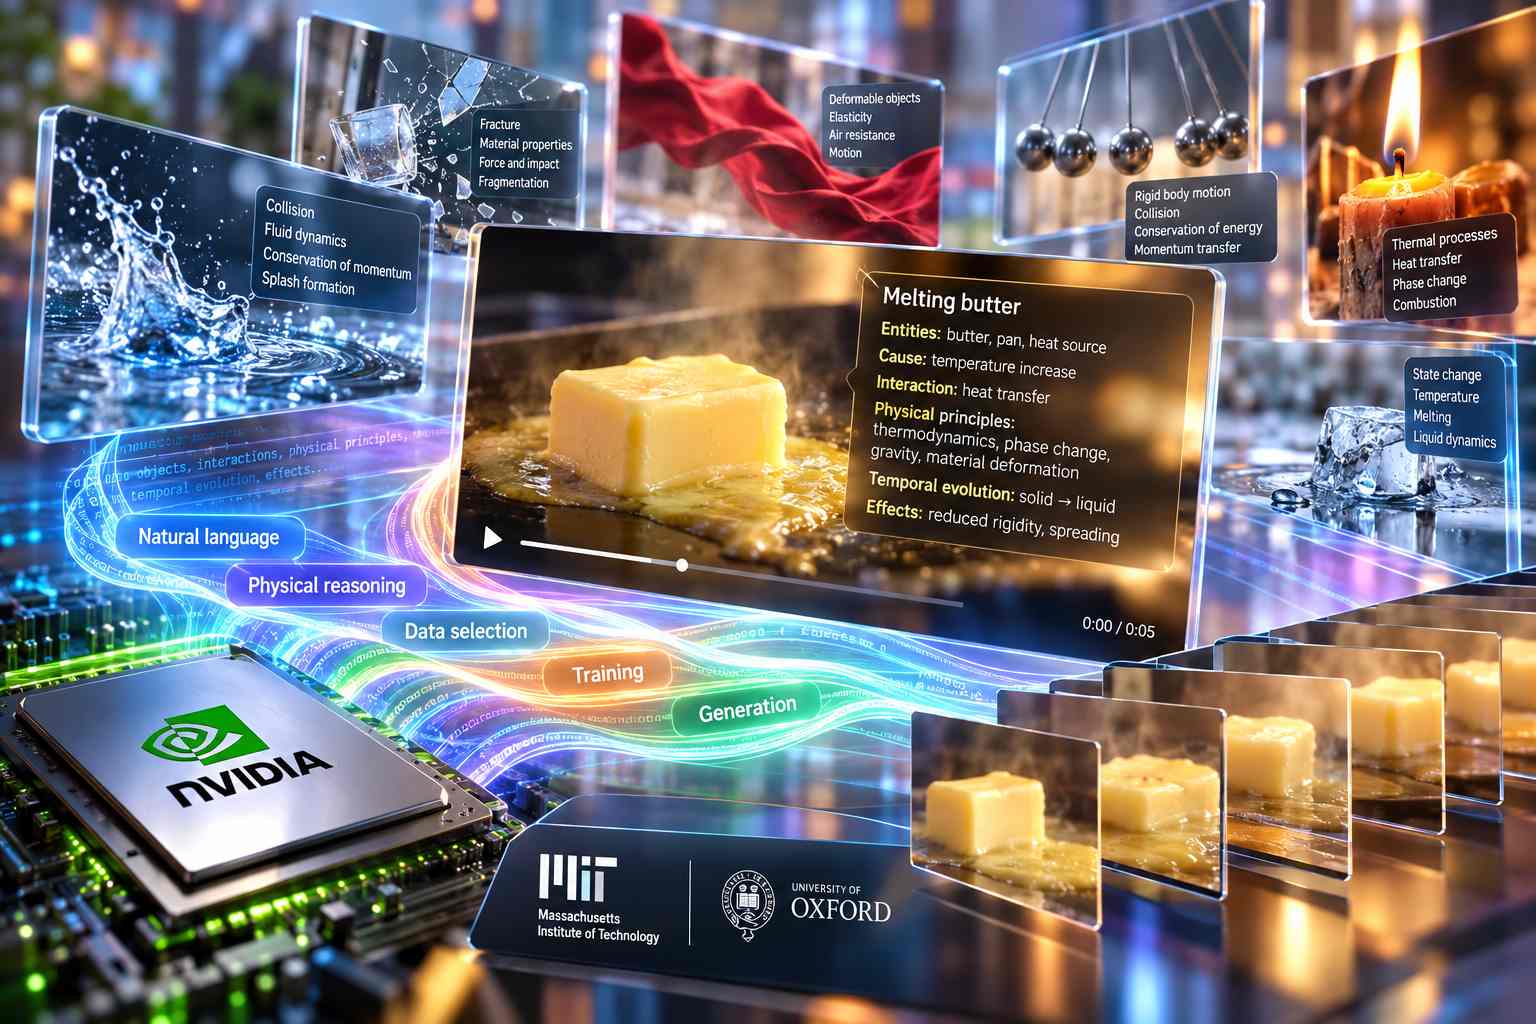
NVIDIA, insieme a ricercatori del MIT e dell’Università di Oxford, ha sviluppato Physis-Lang, un framework pensato per migliorare la comprensione della fisica nei modelli generativi video utilizzando il linguaggio naturale come rappresentazione esplicita dei processi fisici. Il problema affrontato è quello dei video visivamente convincenti ma fisicamente incoerenti, nei quali oggetti, materiali o movimenti possono violare principi elementari pur mantenendo un aspetto realistico. Invece di affidarsi soltanto a rappresentazioni numeriche, segnali visivi aggiuntivi o moduli di pianificazione, Physis-Lang descrive per ogni scena non solo ciò che accade, ma anche le entità coinvolte, la causa dell’evento, le interazioni, i principi fisici rilevanti, l’evoluzione temporale e gli effetti prodotti. Una descrizione come quella di un pezzo di burro che si scioglie viene quindi arricchita specificando che l’aumento della temperatura trasferisce calore, che il cambiamento di fase riduce la rigidità del materiale e che la gravità contribuisce alla sua deformazione e diffusione sulla superficie. Questa stessa rappresentazione testuale viene poi riutilizzata durante selezione dei dati, addestramento e generazione.
Il framework comprende un processo di auto-miglioramento delle istruzioni utilizzate per generare queste descrizioni fisiche. Un captioner rimane invariato, mentre un critic specializzato identifica affermazioni mancanti, non supportate o incomplete e un agente modifica progressivamente le linee guida di captioning sulla base degli errori rilevati. Per misurare la qualità delle descrizioni è stato creato PhysCapBench, composto da 246 video e 3.794 affermazioni fisiche verificate manualmente, con una media di circa 15,4 proprietà per video. Le caption vengono scomposte in singole affermazioni e valutate sia per precisione, verificando che ciascuna sia effettivamente supportata dalle immagini, sia per recall, controllando che i fenomeni fisici rilevanti siano stati coperti. Durante il processo evolutivo il punteggio F1 delle descrizioni è passato da 78,64 a 87,82 e, utilizzando soltanto caption più ricche in fase di inferenza senza modificare i pesi del modello, il punteggio su PhyGenBench è salito da 64,17 a 67,29.
Physis-Lang utilizza inoltre gli errori del modello per individuare direttamente quali tipi di fenomeni fisici mancano nei dati di addestramento. Le carenze vengono convertite in query testuali e impiegate per recuperare nuovi video visivamente diversificati che mostrano, ad esempio, deformazione dei tessuti, fratture, elasticità, collisioni, fenomeni termici, processi chimici e movimenti di corpi rigidi o deformabili. I nuovi contenuti vengono quindi ricaptionati con la rappresentazione fisica evoluta e utilizzati nel training. Nei test questa selezione guidata dal linguaggio ha prodotto miglioramenti fino a 8 punti percentuali in alcune categorie di VideoPhy-2, mentre l’applicazione complessiva del metodo ha migliorato tutti i backbone testati: +7,05 punti su Wan2.1 14B, +3,24 su Cosmos3-Edge 4B, +6,22 su Cosmos3-Nano 16B e +5,02 su Cosmos3-Super 64B. Il sistema utilizza anche negative prompt specifici per la scena, nei quali vengono descritte evoluzioni fisicamente implausibili da evitare durante la generazione.
I risultati più evidenti emergono sul benchmark pubblico Physics-IQ Verified dedicato alla generazione image-to-video. Physis-Lang applicato a Cosmos3-Super ha ottenuto 48,2 ± 1,4 punti e la versione basata su Cosmos3-Nano 43,3 ± 1,5, occupando rispettivamente il primo e il secondo posto tra i modelli image-to-video verificati al momento della pubblicazione; il precedente Cosmos3-Super raggiungeva 42,7 punti. Nei confronti riportati dai ricercatori, Cosmos3-Nano potenziato con Physis-Lang supera inoltre Veo 3.1 in tre dei quattro benchmark fisici utilizzati, pur non risultando superiore in ogni singola configurazione. Il risultato mostra soprattutto che una rappresentazione linguistica sufficientemente strutturata può diventare un elemento comune per descrivere, selezionare, insegnare e richiamare conoscenza fisica nei world model video, senza richiedere necessariamente un’architettura separata dedicata esclusivamente alla simulazione dei fenomeni fisici.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)