
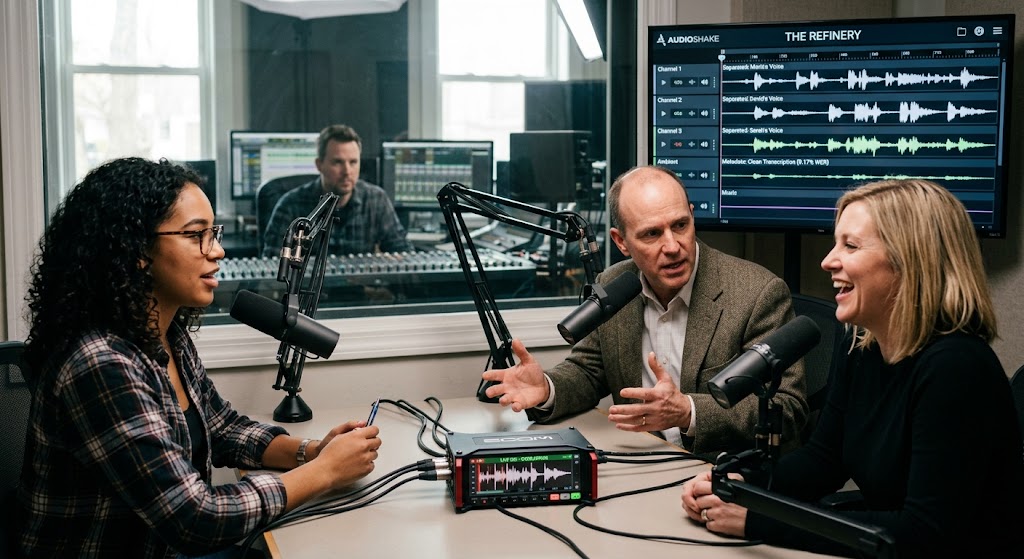
AudioShake ha presentato The Refinery, una piattaforma dedicata alla preparazione di dataset audio per l’addestramento dei sistemi di intelligenza artificiale vocale, capace di separare le voci di più interlocutori presenti nella stessa registrazione e di distinguere il parlato dalla musica e dai rumori ambientali. La tecnologia interviene su uno dei problemi più complessi nella realizzazione dei modelli conversazionali: trasformare registrazioni autentiche, caratterizzate da interruzioni, sovrapposizioni vocali e condizioni acustiche variabili, in dati strutturati utilizzabili per l’apprendimento automatico. In una conversazione reale, infatti, gli interlocutori non rispettano necessariamente turni di parola distinti, ma possono intervenire mentre un’altra persona sta ancora parlando, pronunciare brevi espressioni di assenso oppure interrompersi reciprocamente. Questi elementi costituiscono informazioni importanti per i modelli vocali, ma risultano difficili da isolare quando vengono acquisiti attraverso una singola traccia sonora nella quale tutte le sorgenti sono mescolate.
The Refinery utilizza tecniche di separazione acustica per ricavare tracce distinte a partire da registrazioni già esistenti, senza richiedere i file multitraccia originali o una nuova sessione di acquisizione. Il sistema identifica i contributi dei singoli interlocutori e permette di ricostruirne la distribuzione temporale mantenendo le sovrapposizioni presenti nella conversazione. Se due persone parlano contemporaneamente, l’elaborazione mira a produrre due segnali vocali distinti, conservando l’allineamento necessario per comprendere quando e per quanto tempo le rispettive voci si sovrappongono. La piattaforma separa inoltre le componenti musicali e i suoni ambientali, rendendo possibile organizzare il materiale in funzione delle specifiche esigenze del dataset. AudioShake precisa che il sistema non genera artificialmente nuove battute né ricostruisce un dialogo sintetico: i segnali separati derivano dalle frequenze e dalle informazioni acustiche contenute nella registrazione originale. L’obiettivo è recuperare le componenti effettivamente presenti nel segnale misto, evitando di sostituire le interazioni autentiche con conversazioni generate artificialmente.
L’elaborazione combina la separazione delle sorgenti sonore con la diarizzazione, due operazioni complementari ma tecnicamente differenti. La diarizzazione determina quali interlocutori siano attivi nei diversi intervalli temporali e consente di assegnare segmenti vocali a specifiche identità di parlante. La separazione acustica produce invece segnali sonori individuali, utilizzabili indipendentemente dalla registrazione originale. Identificare che due interlocutori stanno parlando contemporaneamente non significa necessariamente poter ascoltare o trascrivere in modo autonomo ciascuna voce: per ottenere questo risultato occorre intervenire direttamente sulla rappresentazione del segnale audio. La tecnologia Multi-Speaker Separation di AudioShake affronta entrambe le operazioni e distingue l’affidabilità dell’attribuzione di una traccia all’interlocutore corretto dalla qualità effettiva della separazione. Un segmento può infatti essere associato alla persona giusta, ma contenere ancora interferenze provenienti dalle altre sorgenti. L’azienda descrive il sistema come una soluzione basata sull’elaborazione acustica, anziché sull’impiego di un modello linguistico per dedurre il contenuto delle conversazioni.
Una componente centrale di The Refinery riguarda la valutazione automatica della qualità dei risultati. La piattaforma assegna punteggi di qualità e confidenza alle tracce elaborate, consentendo di classificare i segmenti in base alla loro utilizzabilità e alla necessità di ulteriori verifiche. Questa funzione permette di gestire archivi molto estesi senza richiedere l’ascolto manuale di ogni registrazione, indirizzando l’intervento umano verso le porzioni maggiormente problematiche. Un segmento nel quale una voce molto debole viene parzialmente coperta da un altro interlocutore può essere contrassegnato per un controllo specifico, mentre una registrazione caratterizzata da una separazione particolarmente chiara può essere destinata direttamente alle fasi successive di elaborazione. I punteggi possono inoltre essere utilizzati per distinguere problemi di identificazione degli interlocutori, contaminazione fra sorgenti e difficoltà che emergono durante l’eventuale trascrizione automatica. La qualità del dataset risultante dipende quindi non soltanto dalla disponibilità di tracce separate, ma anche dalla conservazione delle informazioni temporali, dall’accuratezza delle etichette e dall’affidabilità dei metadati associati.
Le capacità della tecnologia di separazione sono state illustrate attraverso una valutazione tecnica di Multi-Speaker 2.0 sul dataset LibriCSS, utilizzato per studiare il riconoscimento di conversazioni con parlato sovrapposto. AudioShake ha comunicato un concatenated minimum-permutation word error rate del 9,17%, contro il 37,75% registrato dal checkpoint MERL TF-Locoformer selezionato come riferimento. La metrica misura gli errori di riconoscimento delle parole considerando la possibile permutazione degli interlocutori, in modo da valutare la trascrizione senza penalizzare arbitrariamente l’ordine con cui vengono assegnate le identità vocali. Entrambi i sistemi sono stati valutati attraverso la medesima pipeline di trascrizione basata su Whisper large-v3. Il confronto richiede tuttavia una precisazione: il modello MERL utilizzato come riferimento è stato sottoposto a una valutazione al di fuori del dominio del proprio addestramento, pertanto i risultati non rappresentano un confronto definitivo fra architetture addestrate nelle stesse condizioni. AudioShake riconosce inoltre che la separazione diventa progressivamente più difficile quando aumenta il numero degli interlocutori e quando le sovrapposizioni vocali si prolungano nel tempo.
The Refinery trasferisce nel settore dei dati per l’intelligenza artificiale tecnologie che AudioShake ha sviluppato inizialmente per applicazioni musicali e audiovisive, dove la separazione delle sorgenti permette di recuperare voci, strumenti e altri elementi sonori da registrazioni finalizzate. L’azienda annovera tra i clienti dei propri servizi audio realtà come ESPN, Universal Music Group e Warner Bros. Studios, per applicazioni che comprendono localizzazione, missaggio, analisi ed elaborazione dei contenuti. Nel nuovo contesto operativo, le registrazioni vengono trasformate in materiale di addestramento strutturato, mantenendo la possibilità di utilizzare archivi già disponibili anziché produrre necessariamente nuove sessioni di registrazione. La preparazione dei dati può interessare conversazioni fra più interlocutori, interazioni spontanee e materiale che contiene condizioni acustiche difficili da riprodurre mediante dataset artificiali.
Secondo i dati comunicati dall’azienda, le tecnologie AudioShake hanno elaborato oltre 100 milioni di minuti di registrazioni, mentre versioni preliminari di The Refinery sono state impiegate privatamente nel corso dell’ultimo anno da laboratori impegnati nello sviluppo di modelli AI avanzati. Fra i clienti citati figurano Luel e Rime, insieme a laboratori e operatori del mercato dei dati non identificati pubblicamente. La piattaforma può essere utilizzata attraverso API, integrandosi nelle pipeline di preparazione dei dataset, oppure mediante distribuzione on-premises all’interno delle infrastrutture del cliente. Quest’ultima configurazione è rivolta alle organizzazioni che devono elaborare registrazioni proprietarie o sensibili senza trasferirle fuori dal proprio ambiente. AudioShake specifica inoltre che i clienti mantengono la proprietà dei dati originali e dei risultati prodotti dall’elaborazione, mentre l’impiego delle registrazioni resta subordinato alla disponibilità dei diritti necessari per il loro utilizzo. La separazione automatizzata rende così possibile impiegare conversazioni autentiche nell’addestramento dei modelli vocali, preservando caratteristiche come interruzioni e sovrapposizioni che una normale procedura di pulizia dell’audio rischierebbe di eliminare.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)