
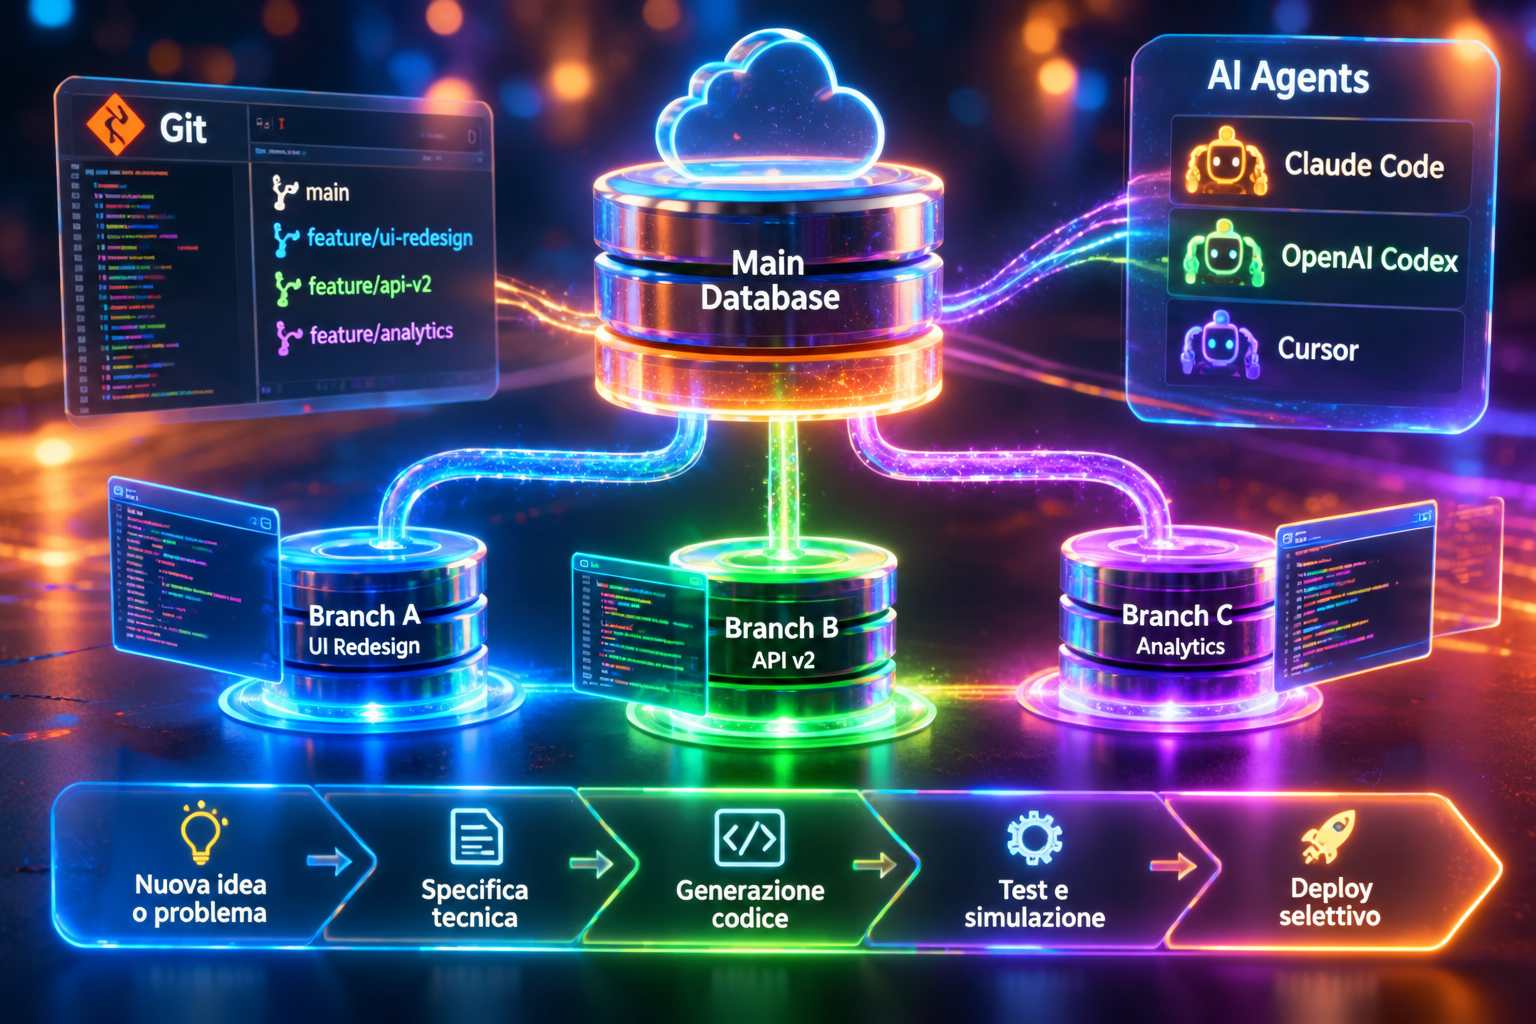
Databricks ha presentato un nuovo workflow di sviluppo software agentico basato sulle funzionalità di database branching di Lakebase, la propria infrastruttura PostgreSQL progettata per supportare applicazioni e sistemi di intelligenza artificiale. La soluzione permette di assegnare a ciascun agente di programmazione un ambiente database indipendente, creato rapidamente attraverso una procedura copy-on-write, così da consentire a più agenti di lavorare contemporaneamente sullo stesso progetto senza interferire reciprocamente con le modifiche apportate allo schema e ai dati. L’iniziativa nasce dalla crescente diffusione di agenti AI capaci di sviluppare funzionalità software, eseguire test, correggere errori e modificare autonomamente il codice. Quando più agenti intervengono in parallelo, la separazione dei file può essere gestita attraverso i normali meccanismi di versionamento Git, ma l’isolamento del database costituisce un problema differente. Due agenti che utilizzano contemporaneamente un unico database di sviluppo possono apportare modifiche incompatibili alle tabelle, eliminare informazioni necessarie ai test reciproci oppure introdurre strutture temporanee che alterano il comportamento delle applicazioni. Databricks propone quindi di estendere al livello dei dati il principio di isolamento già applicato ai repository software, utilizzando rami di database temporanei che possono essere creati e successivamente eliminati senza modificare la struttura utilizzata dagli altri agenti o dai servizi di produzione.
Il funzionamento si basa sulle caratteristiche architetturali di Lakebase Postgres, che permette di separare le risorse computazionali dalla conservazione permanente dei dati e di creare ramificazioni logiche indipendenti attraverso la tecnica copy-on-write. Quando viene generato un nuovo branch, il sistema non deve duplicare immediatamente l’intero contenuto del database di origine, poiché il ramo derivato può inizialmente condividere i blocchi di dati già presenti nel livello di archiviazione. Le informazioni aggiuntive vengono conservate separatamente soltanto quando il nuovo ambiente introduce modifiche rispetto allo stato iniziale. Questo meccanismo permette di creare database indipendenti in meno di un secondo, secondo quanto dichiarato da Databricks, anche quando la base dati originale è di dimensioni considerevoli. La velocità di creazione dipende quindi dalla gestione dei riferimenti e dei metadati, anziché dalla necessità di trasferire fisicamente tutti i dati verso una nuova istanza. Ogni branch può essere utilizzato per applicare modifiche allo schema, aggiornare record, inserire dati sperimentali ed eseguire test senza alterare direttamente lo stato degli altri rami. L’infrastruttura supporta inoltre la modalità scale-to-zero, attraverso la quale le risorse computazionali degli ambienti inattivi possono essere sospese, evitando di mantenere continuamente attiva un’istanza completa per ogni agente. Il consumo di archiviazione dipende invece dalle informazioni condivise e dalle modificazioni effettivamente introdotte.
L’integrazione con gli strumenti di sviluppo viene realizzata attraverso Git worktrees, una funzionalità che permette di utilizzare contemporaneamente più directory di lavoro associate a branch differenti dello stesso repository. In una configurazione tradizionale, gli sviluppatori lavorano spesso su un’unica directory locale e cambiano progressivamente il branch Git attivo. Gli agenti paralleli richiedono invece di mantenere contemporaneamente disponibili copie operative separate, perché ciascun agente deve poter leggere e modificare il proprio insieme di file senza essere influenzato dalle operazioni degli altri. I worktree risolvono questa esigenza a livello del filesystem, mentre Lakebase introduce il corrispondente isolamento per lo stato del database. Databricks ha illustrato una configurazione nella quale un agente Claude Code avvia un nuovo worktree associato a una funzionalità in sviluppo. Un hook Git eseguito dopo il checkout intercetta la creazione del ramo e richiede automaticamente a Lakebase un database derivato da quello di riferimento. L’agente riceve quindi sia una directory di lavoro indipendente sia una connessione PostgreSQL dedicata, attraverso la quale può effettuare le modifiche necessarie. Le istruzioni conservate nel repository, per esempio all’interno di file AGENTS.md o CLAUDE.md, possono guidare il comportamento dell’agente durante lo sviluppo, definendo quando creare i rami, come eseguire i test e quali procedure seguire prima di proporre l’integrazione del codice.
Un aspetto centrale del workflow riguarda la gestione delle modifiche allo schema del database. Nei progetti software, l’introduzione di una nuova funzionalità può richiedere l’aggiunta di tabelle, colonne, indici oppure relazioni tra differenti entità. Quando queste operazioni vengono effettuate su una base dati condivisa, un agente che sta eseguendo test su una versione precedente dell’applicazione potrebbe incontrare errori causati dalle modifiche introdotte da un altro processo. Il branching permette invece di applicare ogni migrazione soltanto all’ambiente assegnato all’agente interessato. Una caratteristica importante distingue però i rami di Lakebase dai branch Git: le modifiche apportate ai dati non vengono reintegrate automaticamente nel ramo principale attraverso una procedura di merge. Databricks precisa infatti che la riconciliazione di due database evoluti indipendentemente può diventare impraticabile, soprattutto quando entrambi hanno subito modifiche ai record e alle strutture. La promozione delle modifiche avviene quindi attraverso il codice applicativo e i file di migrazione, che descrivono in maniera riproducibile le trasformazioni da applicare allo schema. Sono supportati strumenti come Drizzle, Flyway, Liquibase e Alembic, mentre nella dimostrazione tecnica viene utilizzato Drizzle. Questa distinzione evita di confondere la conservazione temporanea dei dati di test con il processo di distribuzione delle modifiche strutturali destinate agli ambienti definitivi.
Databricks ha esteso il medesimo principio anche alle pull request attraverso un workflow automatizzato basato su GitHub Actions. Quando uno sviluppatore o un agente propone l’integrazione di una nuova funzionalità nel branch principale del repository, la pipeline di continuous integration può creare automaticamente un database Lakebase temporaneo associato alla richiesta. Il ramo viene derivato dal database di riferimento e utilizzato per applicare le migrazioni previste dalla nuova versione del software. Successivamente, i test automatici vengono eseguiti contro questo ambiente indipendente, mentre una versione preliminare dell’applicazione può essere distribuita per consentire ai revisori di verificarne il funzionamento. Il workflow comprende anche la generazione di uno schema diff, un confronto strutturato che mostra quali tabelle, colonne o indici siano stati aggiunti, modificati o eliminati dalla proposta. Il risultato può essere pubblicato automaticamente come commento alla pull request, affiancando alla revisione delle modifiche software un controllo esplicito sull’evoluzione del database. Una volta completata la revisione e approvata la richiesta, il codice e i file di migrazione vengono integrati nella versione principale, mentre il database temporaneo viene eliminato. La medesima procedura può essere attivata anche quando la proposta viene chiusa senza essere accettata, evitando di conservare inutilmente ambienti di test.
L’esempio operativo sviluppato da Databricks utilizza Databricks Apps per distribuire le versioni preliminari delle applicazioni, ma l’architettura non richiede che il software venga necessariamente ospitato sulla stessa piattaforma. I database Lakebase possono infatti essere collegati ad applicazioni distribuite attraverso servizi come Vercel, Netlify, Cloudflare e altre infrastrutture compatibili con PostgreSQL. La separazione tra database temporaneo e ambiente applicativo permette quindi di adattare il workflow a differenti stack tecnologici, mantenendo un meccanismo comune di isolamento dei dati. La configurazione dimostrativa utilizza un unico workspace Databricks per semplicità, ma l’azienda precisa che nelle implementazioni aziendali è frequente utilizzare workspace distinti per sviluppo, staging e produzione. Questa distinzione è importante per definire confini di sicurezza, autorizzazioni e procedure di distribuzione. La possibilità tecnica di creare un branch direttamente da un database di produzione non implica infatti che sia sempre opportuno fornire agli agenti copie logiche contenenti informazioni sensibili reali. Databricks propone anche l’utilizzo di database preliminarmente popolati con dati di prova oppure di informazioni derivate dalla produzione attraverso procedure di mascheramento controllate mediante Unity Catalog, così da ridurre l’esposizione di dati personali e contenuti riservati.
Le funzionalità di branching possono essere utilizzate anche nella riproduzione dei malfunzionamenti. Un problema software potrebbe emergere soltanto in presenza di una specifica combinazione di dati e struttura del database, difficile da ricostruire attraverso semplici dataset sintetici. Lakebase permette di creare un ramo isolato partendo dallo stato di una base dati in un momento precedente, per esempio immediatamente prima della comparsa di un errore, e di utilizzare tale ambiente per analizzarne le cause. Gli sviluppatori o gli agenti AI possono applicare modifiche, riprodurre il comportamento problematico e verificare le correzioni senza alterare direttamente l’ambiente operativo. La stessa metodologia può essere applicata alle migrazioni strutturali particolarmente delicate, creando prima un database temporaneo sul quale eseguire l’aggiornamento e valutare il comportamento delle applicazioni. Se la modifica introduce errori, il ramo può essere eliminato senza dover ripristinare il database principale. Se la procedura viene validata, i file di migrazione possono essere utilizzati per applicare la trasformazione nell’ambiente definitivo. Questi utilizzi costituiscono estensioni possibili dell’architettura e non sono tutti implementati direttamente nel repository dimostrativo pubblicato da Databricks, che si concentra soprattutto sull’integrazione tra coding agents, worktrees e pipeline di pull request.
L’isolamento delle credenziali e delle autorizzazioni rappresenta un ulteriore aspetto della progettazione. I branch di Lakebase possono conservare separatamente le configurazioni delle identità e dei ruoli PostgreSQL, impedendo che una modifica alle autorizzazioni effettuata in un ramo produca automaticamente effetti su quelli utilizzati dagli altri processi. Questo comportamento è importante quando un agente deve sperimentare procedure che comprendono creazione di nuovi ruoli, modifica dei privilegi oppure verifica dell’accesso alle tabelle. Senza isolamento, tali operazioni potrebbero modificare le condizioni operative degli altri agenti o invalidare le verifiche di sicurezza condotte in parallelo. La disponibilità di un database indipendente non elimina comunque la necessità di gestire adeguatamente le credenziali utilizzate per crearlo, i permessi concessi all’agente e le informazioni eventualmente contenute nei dati iniziali. La sicurezza del sistema dipende quindi sia dalle capacità di separazione offerte da Lakebase sia dalle policy di accesso implementate dall’organizzazione. Il branching costituisce un meccanismo per limitare l’interferenza tra processi, non una garanzia universale contro qualsiasi utilizzo improprio delle informazioni.
La metodologia viene descritta da Databricks come un’estensione del Software Development Life Cycle verso una configurazione agentica, nella quale il lavoro di programmazione può essere distribuito tra più sistemi autonomi mantenendo procedure di controllo e validazione comparabili a quelle utilizzate dai gruppi di sviluppo tradizionali. L’ambiente temporaneo assegnato a ciascun agente consente di eseguire modifiche e test senza competere per un unico database condiviso, mentre le pipeline associate alle pull request verificano le migrazioni in condizioni vicine a quelle della produzione. La procedura permette inoltre di eliminare gli ambienti non più necessari e sospendere le risorse computazionali inutilizzate, contenendo l’impatto economico dell’esecuzione parallela. Databricks non ha comunicato nell’annuncio un benchmark quantitativo generale relativo al miglioramento della produttività degli sviluppatori oppure alla riduzione dei difetti introdotti dagli agenti. Le caratteristiche dichiarate riguardano principalmente la rapidità di creazione dei database, l’isolamento degli ambienti e le modalità di integrazione con gli strumenti di sviluppo. Il nuovo workflow viene quindi proposto come una soluzione infrastrutturale per coordinare attività software parallele, preservando una separazione chiara tra elaborazione autonoma degli agenti, verifica delle modifiche e distribuzione delle versioni approvate.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)