
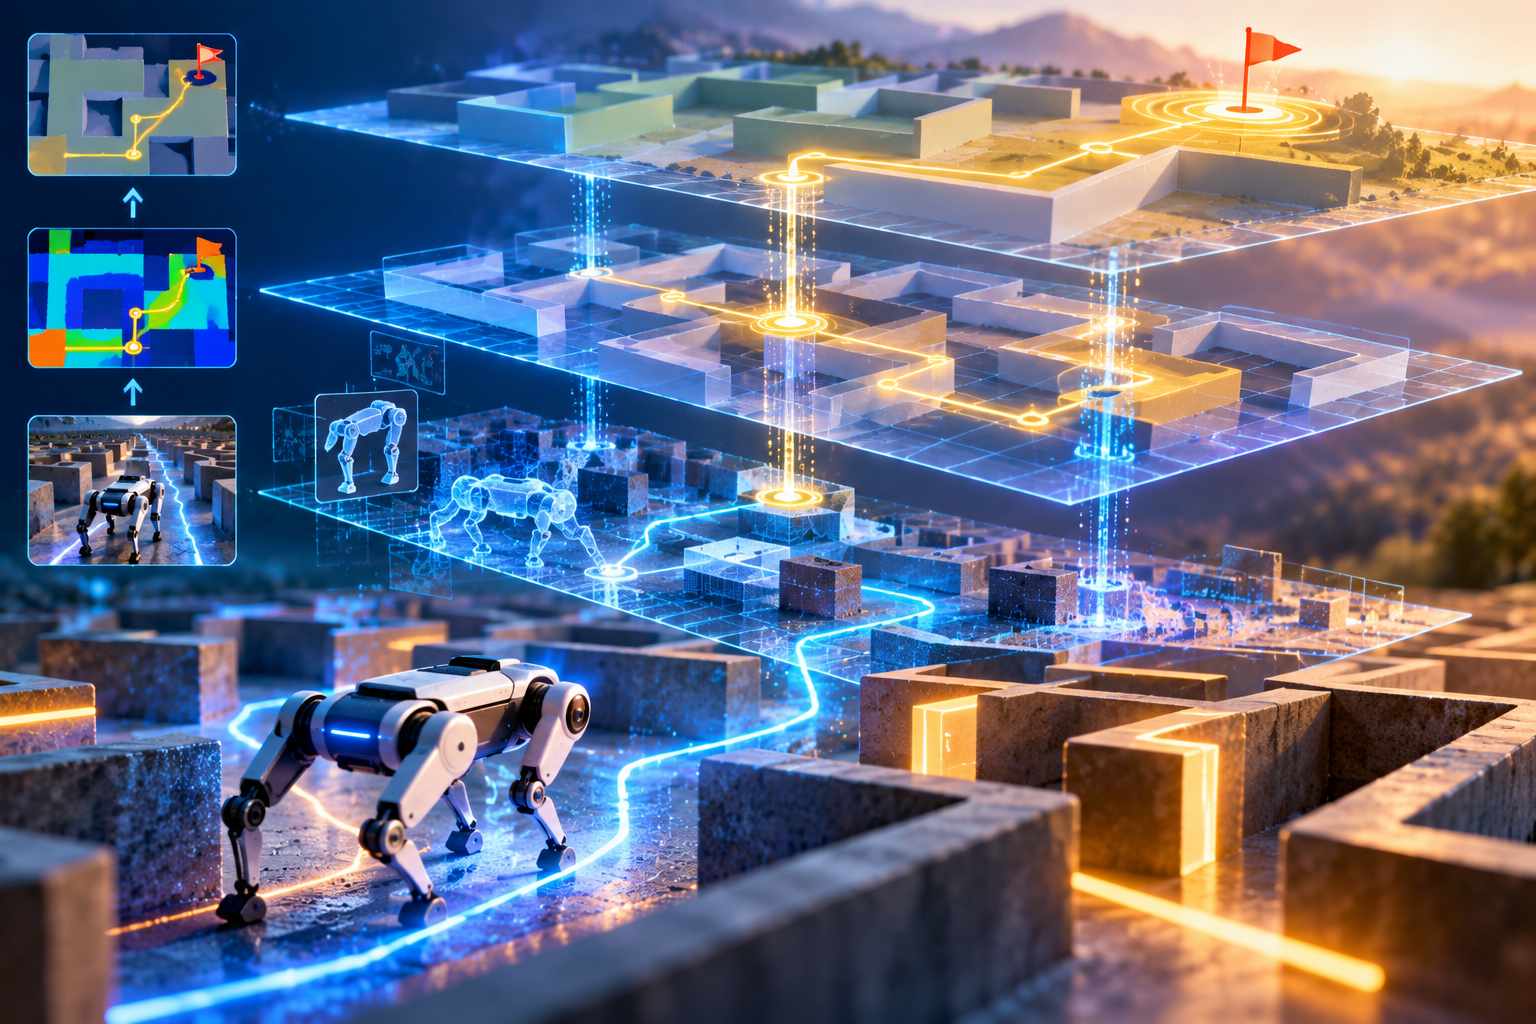
Un gruppo di ricercatori di Advanced Machine Intelligence (AMI), New York University, INRIA Paris e Brown University ha sviluppato H-JEPA, un’architettura di intelligenza artificiale progettata per apprendere modelli del mondo capaci di pianificare azioni su differenti scale temporali e livelli di astrazione. Il progetto, denominato H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning, è firmato da Wancong Zhang, Basile Terver, Michael Rabbat, Yann LeCun e Randall Balestriero e introduce una struttura gerarchica nella famiglia delle Joint-Embedding Predictive Architectures. L’obiettivo è superare i limiti dei modelli predittivi che devono utilizzare un’unica rappresentazione dell’ambiente sia per controllare movimenti immediati sia per organizzare sequenze di azioni necessarie a raggiungere obiettivi distanti. Nei test presentati dai ricercatori, l’adozione di rappresentazioni distinte per ciascun livello ha consentito di migliorare il successo della pianificazione in ambienti simulati, riducendo contemporaneamente il carico computazionale richiesto. Nel benchmark Visual AntMaze, una configurazione a tre livelli ha portato il tasso di successo dal 18% al 73% rispetto alla configurazione di riferimento riportata dal gruppo di ricerca.
Le architetture JEPA apprendono le dinamiche dell’ambiente attraverso rappresentazioni latenti delle osservazioni, senza dover ricostruire esplicitamente ogni dettaglio visivo della scena. Anziché generare i pixel delle immagini future, il sistema codifica le osservazioni in uno spazio di caratteristiche e cerca di prevedere come queste cambieranno in conseguenza delle azioni eseguite. Nei modelli JEPA condizionati dalle azioni, la previsione dello stato futuro dipende quindi sia dalla rappresentazione dello stato corrente sia dai comandi applicati all’ambiente. Questa impostazione permette di simulare differenti traiettorie operative e di confrontare gli stati previsti con un obiettivo prestabilito. Tuttavia, quando le sequenze diventano lunghe, il sistema deve prevedere numerose transizioni consecutive, accumulando errori e aumentando il numero di operazioni necessarie. Inoltre, una rappresentazione sufficientemente dettagliata da descrivere il movimento delle articolazioni di un robot non è necessariamente adatta a individuare il percorso migliore attraverso un edificio o un labirinto. H-JEPA separa questi compiti distribuendoli su livelli predittivi diversi, ciascuno dotato di un proprio spazio latente e di un orizzonte temporale specifico.
L’architettura comprende, per ogni livello gerarchico, un codificatore degli stati, un codificatore delle azioni e un predittore delle transizioni. Il primo livello riceve le osservazioni visive e apprende come il loro contenuto latente evolva in risposta alle azioni elementari. I livelli superiori elaborano invece le rappresentazioni prodotte da quelli inferiori e prevedono transizioni distribuite su intervalli temporali progressivamente più lunghi. L’intera gerarchia viene addestrata congiuntamente su traiettorie costituite da osservazioni e azioni, permettendo ai gradienti associati agli obiettivi predittivi superiori di contribuire anche all’apprendimento dei codificatori sottostanti. Per evitare il collasso delle rappresentazioni, ossia la condizione in cui il modello assegna rappresentazioni sostanzialmente identiche a osservazioni differenti, viene utilizzato il meccanismo di regolarizzazione SIGReg. Gli intervalli temporali associati ai diversi livelli vengono definiti in fase di progettazione, mentre le informazioni conservate nelle singole rappresentazioni emergono dall’addestramento. Il risultato è una gerarchia che può mantenere, ai livelli superiori, le caratteristiche dell’ambiente che evolvono lentamente, eliminando progressivamente dettagli dinamici non necessari alla pianificazione di lungo periodo.
Il funzionamento è particolarmente evidente negli esperimenti con Visual AntMaze, un ambiente nel quale un agente robotico quadrupede deve attraversare un labirinto. Per prevedere le conseguenze immediate dei movimenti, i livelli inferiori devono conservare informazioni sulla configurazione del corpo e sulla posizione delle zampe. Per determinare invece il percorso verso una destinazione lontana, queste informazioni diventano secondarie rispetto alla posizione complessiva del robot e alla struttura dei corridoi. Le analisi effettuate sulle rappresentazioni apprese mostrano che la posizione dell’agente rimane recuperabile anche dai livelli superiori, mentre i dettagli relativi alla postura diventano progressivamente meno accessibili. Un comportamento analogo emerge nell’ambiente FourRoom Distractors, dove gli elementi mobili indipendenti dall’agente vengono attenuati nelle rappresentazioni più astratte. I ricercatori hanno inoltre osservato che le distanze calcolate negli spazi latenti superiori producono segnali di avanzamento verso l’obiettivo più regolari e coerenti con la geometria dei corridoi, evitando che differenze nella postura del robot alterino eccessivamente la valutazione della vicinanza alla destinazione.
La pianificazione viene eseguita dall’alto verso il basso. Il sistema codifica la situazione corrente e l’obiettivo nei differenti spazi latenti, quindi utilizza il pianificatore superiore per individuare una sequenza di transizioni astratte in direzione dello stato desiderato. Gli stati intermedi previsti diventano sotto-obiettivi per il livello immediatamente inferiore, che deve determinare come raggiungerli attraverso azioni più dettagliate. Il processo prosegue fino al livello più basso, responsabile della generazione delle azioni primitive eseguibili nell’ambiente. Dopo aver eseguito una porzione della sequenza pianificata, il modello acquisisce una nuova osservazione e ripete la pianificazione, aggiornando le previsioni in funzione delle differenze tra l’evoluzione attesa e quella effettivamente osservata. Questa procedura consente di combinare la pianificazione a lungo termine con la correzione continua della traiettoria, senza imporre a un unico modello predittivo la simulazione dettagliata di ogni passaggio dell’intero percorso.
La valutazione sperimentale comprende quattro ambienti simulati, FourRoom Distractors, Visual AntMaze, Push-T e OGBench Cube, utilizzati rispettivamente per studiare differenti problemi di navigazione e manipolazione. H-JEPA è stato confrontato con LeWM, un modello JEPA privo di gerarchia, e con HWM, un modello gerarchico che utilizza uno spazio latente condiviso. Nei test FourRoom, AntMaze e Cube, l’introduzione di una gerarchia fino a tre livelli ha generalmente migliorato il rapporto tra probabilità di successo e risorse computazionali impiegate dal pianificatore. In AntMaze, le prestazioni della configurazione a tre livelli hanno raggiunto valori prossimi al doppio di quelli ottenuti da HWM nelle condizioni di confronto riportate. Nell’ambiente Push-T, invece, la configurazione a due livelli ha eguagliato o superato LeWM nei budget computazionali analizzati, mentre gerarchie più profonde hanno prodotto risultati meno favorevoli. Secondo i ricercatori, la durata relativamente breve degli episodi di manipolazione riduce la quantità di dati disponibili per apprendere correttamente transizioni su orizzonti temporali superiori, limitando il vantaggio dell’ulteriore astrazione.
La sperimentazione è stata estesa al dataset DROID, che raccoglie traiettorie video di manipolazione realizzate da robot fisici in ambienti caratterizzati da oggetti, illuminazione e sfondi differenti. In questo caso, l’apprendimento puramente predittivo tendeva a conservare le informazioni relative agli elementi statici della scena, perdendo invece parte dei dettagli necessari a rappresentare il movimento del robot. Per correggere il problema, i ricercatori hanno introdotto un obiettivo di inverse dynamics, attraverso il quale il modello deve prevedere l’azione responsabile della transizione tra due stati osservati. L’aggiunta di questa supervisione ha favorito la conservazione delle informazioni rilevanti per il controllo e ha permesso al secondo livello gerarchico di migliorare ulteriormente la fedeltà della pianificazione rispetto ai modelli di riferimento. La valutazione è stata effettuata offline mediante una metrica di fedeltà basata sulla distanza di Fréchet, confrontando l’intera traiettoria tridimensionale dell’effettore terminale con quella dell’esperto: il punteggio del 100% corrisponde alla traiettoria di riferimento, mentre quello dello 0% rappresenta il caso di un braccio immobile. Non si tratta quindi della dimostrazione di una percentuale equivalente di successo autonomo su robot fisici in ciclo chiuso, ma di una misura della qualità delle traiettorie pianificate a partire da registrazioni reali.
I risultati mostrano che l’apprendimento di rappresentazioni gerarchiche distinte può migliorare la pianificazione quando l’ambiente presenta dinamiche sufficientemente separate sul piano temporale. La stessa sperimentazione evidenzia però che l’aggiunta indiscriminata di livelli non garantisce benefici e che l’efficacia dipende dalle caratteristiche delle traiettorie utilizzate durante l’addestramento. Gli sviluppi previsti comprendono il collegamento delle rappresentazioni superiori al linguaggio naturale, affinché gli obiettivi possano essere espressi attraverso istruzioni testuali anziché esclusivamente mediante osservazioni visive di destinazione. Il progetto mette già a disposizione la documentazione tecnica e il codice di ricerca, mentre il passaggio a sistemi robotici pienamente operativi richiederà ulteriori verifiche sulle prestazioni in ambienti fisici non controllati.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)