
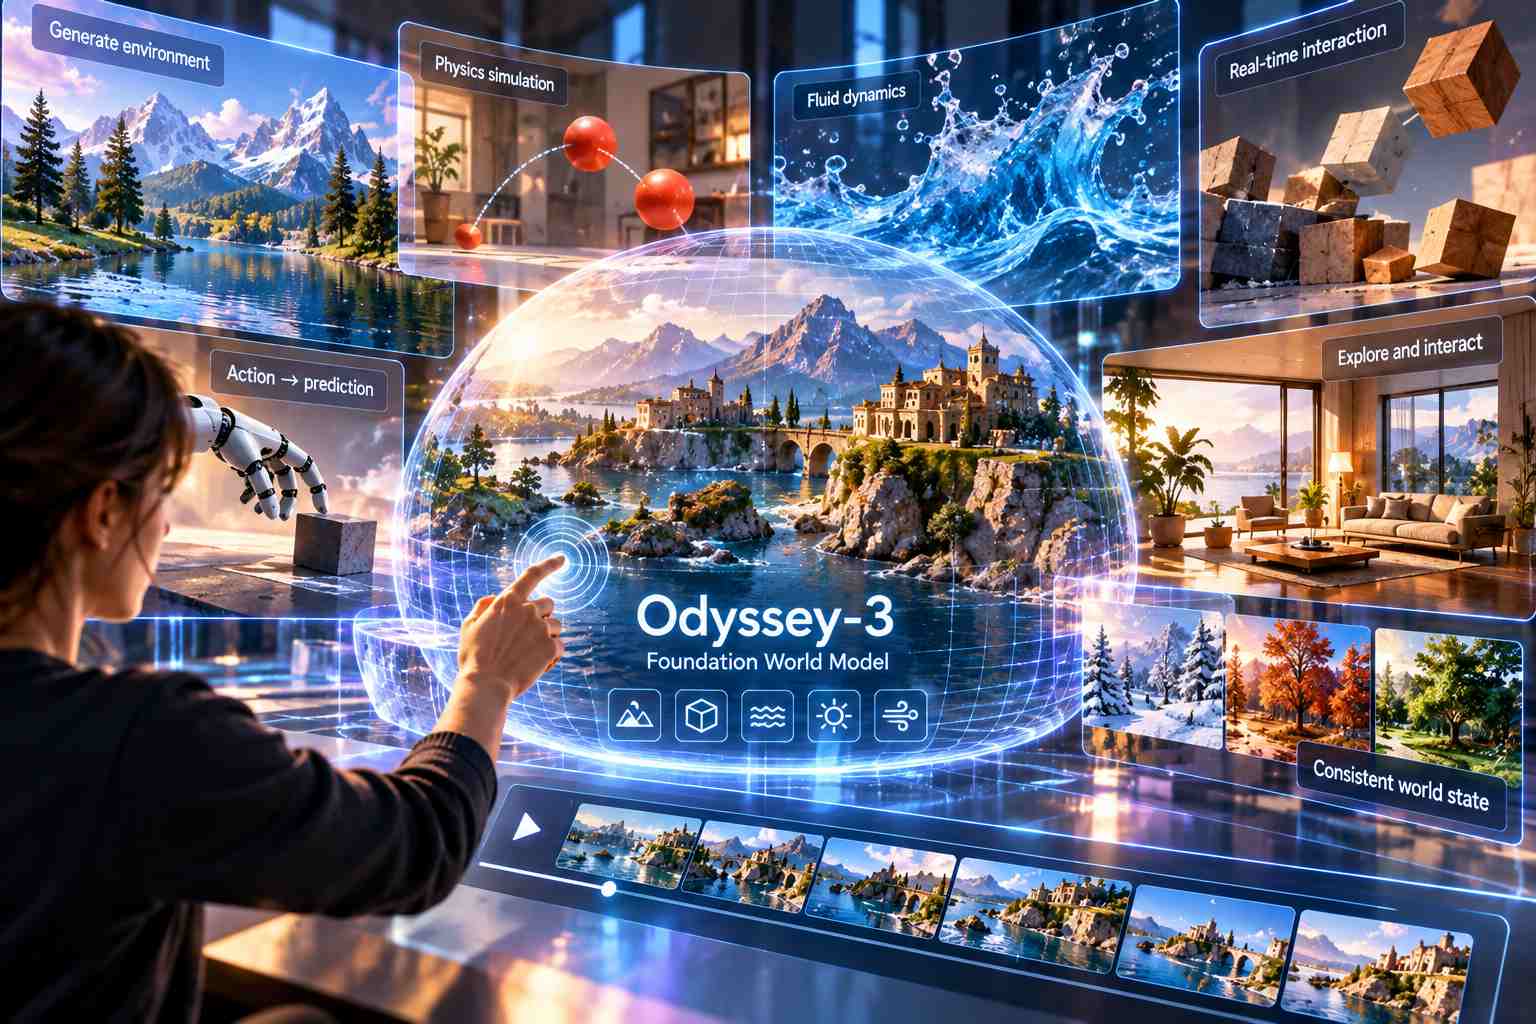
Odyssey ha presentato l’8 ottobre 2026 Odyssey-3, una nuova generazione di foundation world model progettata per simulare ambienti dinamici, prevedere il comportamento fisico degli oggetti e rispondere in tempo reale alle azioni compiute da utenti o sistemi autonomi. Il modello rappresenta l’evoluzione delle tecnologie sviluppate dall’azienda per apprendere le relazioni tra oggetti, movimenti, eventi e conseguenze delle azioni attraverso grandi quantità di osservazioni visive. Odyssey-3 è basato su un’architettura autoregressiva di tipo diffusion transformer, che combina la generazione di rappresentazioni visive con la previsione dei cambiamenti successivi di un ambiente. A differenza di un sistema destinato esclusivamente alla produzione di filmati, il modello mantiene una relazione tra le informazioni precedentemente osservate, le nuove istruzioni ricevute e gli eventi che si verificano durante la simulazione. Questo permette di creare un ambiente attraverso un prompt, esplorarlo modificando la posizione del punto di osservazione e introdurre azioni alle quali il sistema deve reagire generando una prosecuzione coerente della scena. Il lancio è accompagnato dalla disponibilità di una research preview interattiva e dalla pubblicazione di nuovi risultati quantitativi sulla capacità di rappresentare fenomeni fisici. In particolare, Odyssey-3 Pro ha raggiunto un punteggio di 66,1 nel benchmark Physics-IQ Verified, nella modalità video-to-video, risultato che l’azienda indica come il più elevato riportato al momento della valutazione.
La tecnologia si basa sull’apprendimento di un sistema dinamico, nel quale lo stato successivo dell’ambiente viene previsto a partire dalle osservazioni precedenti e dalle azioni disponibili. Un normale modello di generazione video può produrre una sequenza visivamente credibile senza conservare necessariamente una rappresentazione affidabile delle relazioni fisiche tra i suoi elementi. Un world model destinato all’interazione deve invece affrontare anche il problema della continuità del comportamento: un oggetto spostato dovrebbe mantenere una relazione coerente con le posizioni precedenti, una collisione dovrebbe produrre conseguenze compatibili con il movimento dei corpi e una variazione del punto di osservazione non dovrebbe modificare arbitrariamente la struttura della scena. Odyssey-3 affronta questa esigenza utilizzando un Transformer di diffusione video capace di generare sequenze condizionate da informazioni temporali e controlli associati alle azioni. L’estensione autoregressiva viene ottenuta attraverso procedure di addestramento che comprendono teacher forcing e causal masking, utilizzate per insegnare al modello a continuare una sequenza sulla base delle informazioni già disponibili, senza dipendere da osservazioni future che non sarebbero conosciute durante l’esecuzione reale. Il comportamento viene ulteriormente ottimizzato mediante una fase di post-training che combina distribution matching e distillazione avversaria, producendo una variante capace di eseguire la generazione con un numero ridotto di passaggi. Questo procedimento consente di avvicinare la velocità di elaborazione ai requisiti dell’interazione in tempo reale, senza richiedere necessariamente l’esecuzione completa della procedura generativa più onerosa a ogni aggiornamento dell’ambiente.
L’addestramento utilizza diverse tipologie di informazioni visive e operative, selezionate per collegare le osservazioni alle azioni che le hanno prodotte. Tra le sorgenti figurano video disponibili su Internet associati ad annotazioni temporali degli eventi, registrazioni di sessioni di gioco accompagnate da input di tastiera e mouse sincronizzati e simulazioni di interazioni tra corpi rigidi corredate da descrizioni e metadati. Le annotazioni degli eventi vengono sottoposte a verifiche strutturali, in modo da utilizzare rappresentazioni coerenti delle azioni osservate. La disponibilità di sequenze nelle quali è possibile conoscere sia ciò che accade sia il comando che ha determinato il cambiamento permette al modello di apprendere relazioni più direttamente utilizzabili per l’interazione. Una registrazione di gioco accompagnata dagli input temporali, per esempio, contiene informazioni differenti da un semplice filmato: il sistema può collegare un movimento del personaggio a un comando specifico e utilizzare questa relazione per prevedere come evolverà una situazione quando verrà ricevuta un’azione analoga. Le simulazioni di corpi rigidi introducono invece osservazioni associate a interazioni fisiche esplicitamente rappresentate. Odyssey utilizza queste sorgenti per costruire un modello generale del comportamento degli ambienti, successivamente adattabile a dispositivi e compiti specifici attraverso componenti addestrate sulle corrispondenze tra osservazioni e azioni.
La valutazione delle capacità fisiche è stata condotta attraverso Physics-IQ Verified, un benchmark sviluppato da Anates Labs e Google DeepMind che misura la capacità dei modelli video di prevedere il comportamento di sistemi fisici reali. La procedura utilizza filmati di esperimenti osservati e richiede al modello di generare la continuazione della sequenza, confrontando successivamente la previsione con ciò che si è verificato effettivamente. Le categorie considerate comprendono fluidodinamica, ottica, meccanica dei solidi, magnetismo e termodinamica. Il risultato di Odyssey-3 Pro nella modalità video-to-video raggiunge 66,1 punti utilizzando una procedura best-of-eight, nella quale vengono prodotte otto generazioni e viene selezionato il risultato migliore. Si tratta di una condizione sperimentale importante, poiché il punteggio non rappresenta semplicemente la qualità media di una singola generazione e la produzione di più campioni richiede risorse computazionali aggiuntive. La versione Pro raggiunge inoltre 54,7 punti nella modalità image-to-video, che richiede di prevedere l’evoluzione di una situazione a partire da informazioni iniziali differenti. Odyssey ha confrontato i risultati con quelli di modelli appartenenti agli ecosistemi FLUX e NVIDIA Cosmos, dichiarando una posizione particolarmente favorevole nel rapporto tra accuratezza fisica e costo computazionale. Le valutazioni economiche utilizzano ipotesi relative al costo orario delle GPU e alle procedure di generazione, pertanto devono essere interpretate in relazione alle condizioni dichiarate e non come un prezzo uniforme applicabile a ogni implementazione.
Il confronto attraverso WorldMark riguarda invece caratteristiche differenti dalla correttezza fisica. Il benchmark misura proprietà quali la capacità di seguire istruzioni di controllo, la qualità visiva e la conservazione delle informazioni sull’ambiente generato. Odyssey ha utilizzato le descrizioni previste dal benchmark e la media di tredici metriche per confrontare il proprio modello con sistemi concorrenti in quattro categorie distinte. Nella generazione stilizzata in prima persona Odyssey-3 ha ottenuto 77,2 punti, contro i 77,0 di LingBot-World e i 76,7 di AlayaWorld. Nella categoria relativa agli ambienti realistici in terza persona ha raggiunto 79,0 punti, superando i 76,9 di HY-World 1.5, mentre nella rappresentazione stilizzata in terza persona ha ottenuto 76,3 punti, contro i 75,1 dello stesso concorrente. Il modello si è classificato invece al terzo posto nella categoria relativa agli ambienti realistici in prima persona, con 80,6 punti, dietro a Lyra 2.0, che ha registrato 84,4, e ad AlayaWorld, che ha raggiunto 83,0. Questi risultati documentano una buona capacità di generazione e controllo nei contesti esaminati, ma non indicano una superiorità uniforme in ogni tipologia di ambiente. Odyssey precisa inoltre che la valutazione delle proprietà generali di un mondo simulato non sostituisce la verifica delle capacità richieste da una macchina reale, il cui funzionamento può dipendere da condizioni fisiche e di sicurezza non completamente rappresentate nei benchmark visivi.
La ricerca comprende esperimenti destinati ad adattare le rappresentazioni apprese da Odyssey-3 al controllo di bracci robotici. L’approccio consiste nel mantenere una base generale di conoscenza del comportamento degli ambienti e addestrare successivamente un action decoder oppure una policy, utilizzando osservazioni accompagnate dalle azioni compiute dal robot. Queste componenti traducono le rappresentazioni del world model in comandi compatibili con il dispositivo fisico. Odyssey dichiara di aver ottenuto risultati su compiti di manipolazione utilizzando alcune decine di ore di dimostrazioni robotiche, osservando anche comportamenti di recupero non rappresentati esplicitamente negli esempi di addestramento. Tra le situazioni documentate figurano la correzione dell’orientamento di una pinza dopo un tentativo di presa non riuscito e il recupero di un oggetto caduto in una posizione insolita. Le dimostrazioni comprendono operazioni come versare cereali in una ciotola e chiudere una scatola con elementi meccanici. La capacità di recuperare da una situazione imprevista è rilevante perché un sistema basato esclusivamente sulla riproduzione di sequenze dimostrate può incontrare difficoltà quando l’ambiente si discosta dagli esempi osservati. I risultati rimangono tuttavia riferiti alle attività e alle configurazioni sperimentali dichiarate e non costituiscono una dimostrazione di affidabilità generale nella manipolazione di qualsiasi oggetto.
Odyssey ha esteso gli esperimenti anche ai robot umanoidi attraverso una collaborazione tecnica con Flexion, che ha costruito policy di controllo basate sulle rappresentazioni del modello. Nei test effettuati, tali policy hanno superato le prestazioni dei sistemi Vision-Language-Action utilizzati come riferimento in presenza di variazioni ambientali, mantenendo la capacità di completare compiti anche quando i cambiamenti dell’illuminazione causavano il fallimento dei modelli confrontati. Le attività dimostrative comprendono l’apertura di un contenitore, l’estrazione di un oggetto e la disposizione di stoviglie in posizioni specifiche. L’adattamento alla guida autonoma è stato invece sperimentato su strade reali in India, utilizzando soltanto venti ore di dati di guida per addestrare una policy, mantenendo congelati i pesi del backbone Odyssey-3. In questa configurazione, il sistema utilizza le rappresentazioni visive del modello per prevedere punti di traiettoria futuri e controllare il veicolo attraverso un processo a ciclo chiuso. La ricerca comprende anche una prova preliminare di generazione multisensore, nella quale un checkpoint del modello è stato adattato a produrre simultaneamente sequenze provenienti da tre telecamere frontali di un dataset di guida autonoma, dopo cento passaggi di addestramento. Questi esperimenti dimostrano modalità di adattamento della medesima base neurale a corpi, dispositivi di acquisizione e attività differenti, ma non equivalgono all’annuncio di un sistema di guida o robotica certificato per impiego commerciale senza supervisione.
La research preview di Odyssey-3 rende disponibile un ambiente nel quale gli utenti possono generare scenari attraverso istruzioni e interagire con essi in prima oppure in terza persona. È possibile modificare indipendentemente la posizione della telecamera, navigare nell’ambiente e introdurre eventi durante la simulazione, osservando come il modello aggiorna le proprie previsioni. La variante distillata a pochi passaggi consente di mantenere un’interazione sufficientemente rapida per l’esplorazione in tempo reale, mentre le configurazioni più onerose vengono utilizzate per valutazioni e applicazioni che richiedono maggiore accuratezza. Odyssey propone inoltre l’utilizzo del modello come ambiente per addestrare altri agenti di intelligenza artificiale. In una dimostrazione, un agente riceve un obiettivo in linguaggio naturale e deve completarlo interagendo con un mondo generato dal sistema, utilizzando le osservazioni prodotte per decidere progressivamente le azioni successive. Questo approccio permette di costruire procedure di addestramento in ambienti la cui evoluzione viene appresa da dati visivi, anziché descritta interamente mediante regole fisiche programmate a mano. La disponibilità pubblica riguarda attualmente l’ambiente sperimentale di Odyssey-3, mentre gli sviluppatori interessati a integrare il modello in applicazioni robotiche, veicoli autonomi, droni o sistemi di Physical AI possono richiedere l’accesso alle relative API. Il lancio collega quindi la generazione di ambienti interattivi alla modellazione dei fenomeni fisici e all’adattamento delle rappresentazioni neurali a dispositivi reali, attraverso una base architetturale utilizzabile in differenti procedure sperimentali.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)