
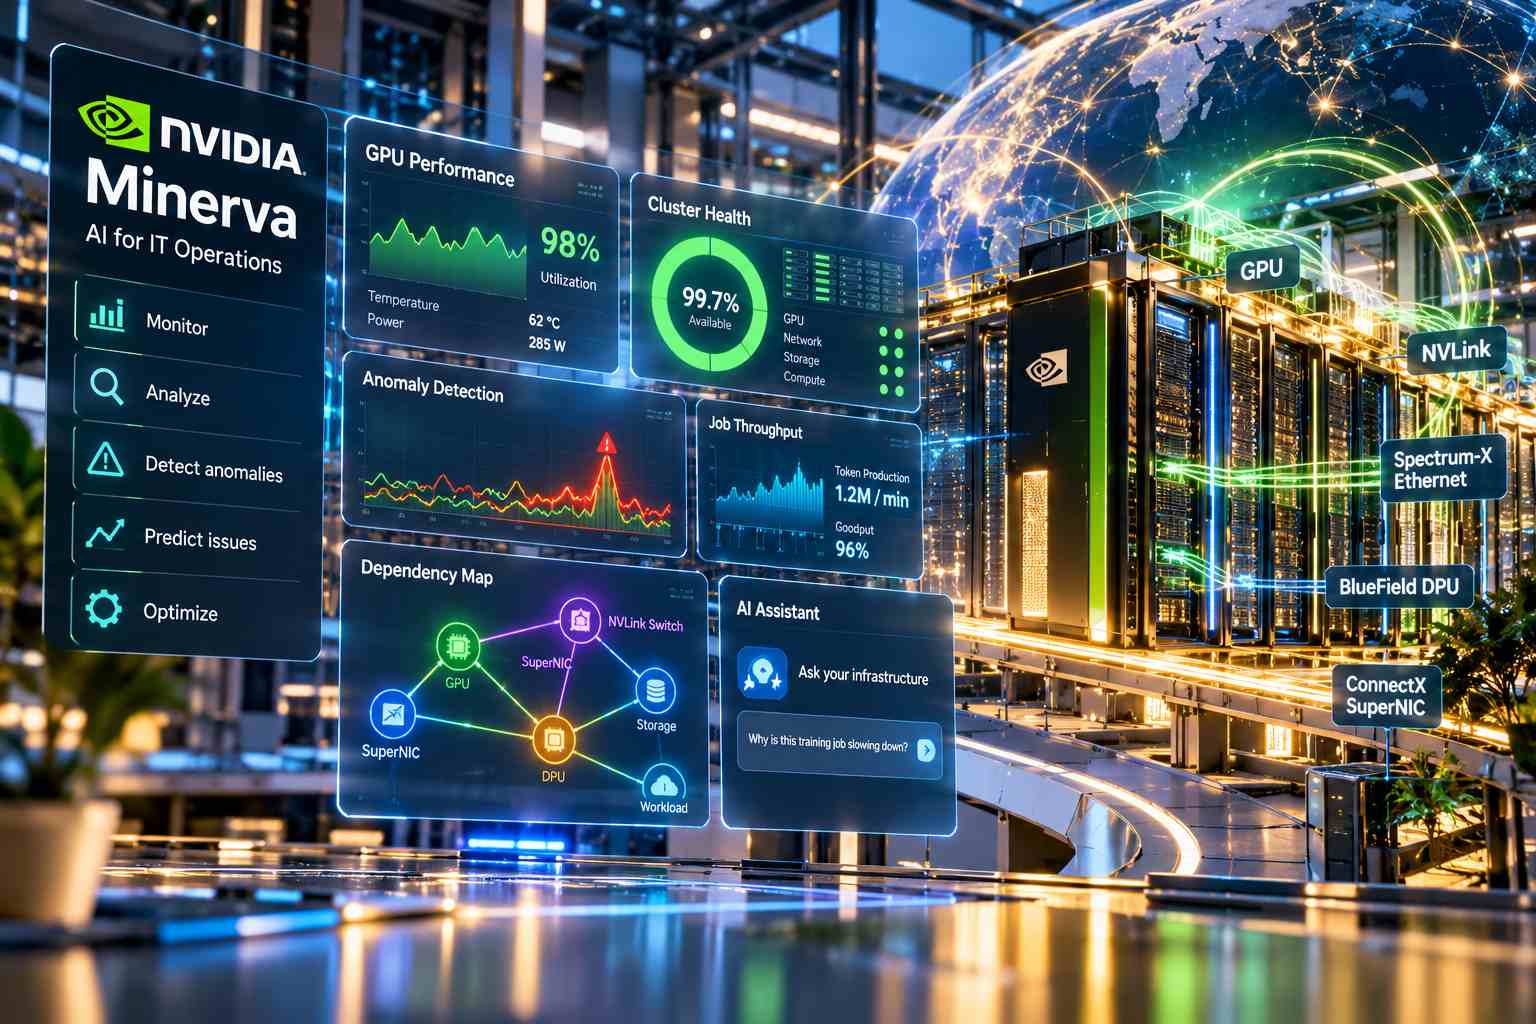
NVIDIA ha introdotto Minerva, una piattaforma di Artificial Intelligence for IT Operations progettata per monitorare, analizzare e ottimizzare il funzionamento delle infrastrutture AI Factory utilizzate nell’addestramento e nell’inferenza dei modelli di intelligenza artificiale. Il sistema integra la telemetria proveniente dalle risorse hardware e dai carichi di lavoro AI, applicando modelli di apprendimento automatico specificamente sviluppati per individuare anomalie, anticipare possibili guasti e ridurre i tempi necessari alla risoluzione degli incidenti. Le AI Factory comprendono grandi quantità di acceleratori GPU, reti ad alta velocità, sistemi di archiviazione e software di orchestrazione che devono operare in maniera coordinata per sostenere elaborazioni distribuite. In ambienti di queste dimensioni, anche il degrado prestazionale di un singolo componente, come una GPU che lavora a temperature superiori alla norma oppure un’unità NVMe che manifesta rallentamenti, può compromettere l’esecuzione di un intero processo di addestramento. Minerva è progettata per individuare precocemente questi segnali, collegandoli alle risorse e ai workload coinvolti prima che si trasformino in interruzioni estese.
La piattaforma utilizza un grafo dinamico della conoscenza che rappresenta le relazioni tra GPU, adattatori di rete SuperNIC, switch, collegamenti fisici e attività computazionali. I dati provenienti dall’infrastruttura vengono correlati con le informazioni relative ai processi di addestramento e inferenza, consentendo agli operatori di ricostruire il percorso delle dipendenze tra un job rallentato e il componente hardware che ne compromette le prestazioni. La rappresentazione supera la separazione tradizionale tra strumenti di monitoraggio dedicati a reti, calcolo, storage e applicazioni, offrendo una visione integrata degli elementi che contribuiscono al funzionamento del cluster. NVIDIA indica che Minerva può analizzare miliardi di punti dati ogni ora attraverso tecniche di apprendimento supervisionato e non supervisionato, costruendo modelli del comportamento normale dell’infrastruttura e identificando variazioni che potrebbero anticipare anomalie o guasti. La correlazione tiene conto della topologia effettiva del sistema e permette di ricondurre numerosi allarmi apparentemente indipendenti a un singolo incidente accompagnato da una probabile causa originaria.
L’ambito di osservabilità comprende le GPU NVIDIA, gli adattatori ConnectX SuperNIC, le unità BlueField DPU, gli switch NVLink utilizzati nelle reti scale-up, le infrastrutture Ethernet Spectrum-X per il traffico East-West e North-South, le comunicazioni NCCL e i sistemi di scheduling dei workload. Questa ampiezza consente di esaminare contemporaneamente i componenti fisici e i processi software che utilizzano le risorse. Minerva misura il rendimento operativo delle AI Factory attraverso indicatori quali ore GPU effettivamente utilizzabili, goodput, disponibilità del cluster e produzione di token. L’obiettivo è collegare lo stato di salute dei dispositivi alla quantità di lavoro utile prodotta dall’infrastruttura, distinguendo la semplice disponibilità nominale delle risorse dalla loro capacità effettiva di contribuire alle elaborazioni.
Minerva integra un assistente AI nativo che permette agli operatori di interrogare l’infrastruttura in linguaggio naturale e ottenere risposte basate sulla telemetria corrente. L’assistente, identificato da Bitdeer AI con il nome Sherlock, utilizza un’architettura multiagente per supportare le attività di diagnosi e troubleshooting. Attraverso un server Model Context Protocol, gli operatori possono inoltre collegare strumenti agentici esterni, mantenendo il riferimento ai dati aggiornati del cluster. Le interazioni permettono di esaminare lo stato delle risorse, individuare possibili cause dei malfunzionamenti e ricevere indicazioni sugli interventi correttivi. Le operazioni di ripristino possono essere eseguite manualmente dal personale tecnico oppure collegate ad automazioni attraverso API infrastrutturali e sistemi esterni. La piattaforma può essere distribuita autonomamente ed è integrata con NVIDIA DSX OS, consentendo l’inserimento delle funzionalità AIOps nelle infrastrutture AI Factory già predisposte per l’ecosistema NVIDIA.
I risultati comunicati attraverso le sperimentazioni interne NVIDIA comprendono una riduzione significativa dei tempi necessari alla gestione degli incidenti. In un caso relativo a un guasto di alimentazione di un dispositivo NVMe, Minerva ha ridotto il tempo medio di ripristino da un’interruzione di più giorni a circa sei ore. In un’altra prova ha ricondotto 81 eventi di allarme a una sola segnalazione operativa, permettendo di preservare 54 ore di disponibilità del cluster. I test hanno inoltre evidenziato miglioramenti nel tempo medio tra le interruzioni, grazie all’identificazione preventiva dei problemi, e una riduzione del tempo medio di riparazione attraverso l’analisi automatizzata delle cause principali. Tali risultati sono riferiti alle prove interne comunicate nell’ambito del lancio e non costituiscono garanzie quantitative generalizzabili a ogni infrastruttura.
Tra le organizzazioni coinvolte nell’adozione figurano IREN e Bitdeer AI, che utilizzano Minerva per migliorare la supervisione delle proprie infrastrutture di calcolo. IREN ha evidenziato l’utilità di una visione operativa unificata delle reti, delle GPU e dei job, mentre Bitdeer AI ha integrato la piattaforma nelle proprie attività di gestione delle AI Factory con l’obiettivo di identificare il degrado prestazionale prima che comprometta l’esecuzione dei workload. La soluzione è progettata per adattarsi a installazioni di dimensioni differenti, dai cluster relativamente contenuti fino a infrastrutture comprendenti centinaia di migliaia di GPU. Anche Lenovo ha incluso Minerva tra le tecnologie di riferimento per la disponibilità e le prestazioni delle proprie soluzioni Hybrid AI Factory basate su NVIDIA, affiancandola alle collaborazioni con IBM e NVIDIA per lo sviluppo di infrastrutture Sovereign AI Factory. L’integrazione tra telemetria hardware, rappresentazione delle dipendenze, diagnostica predittiva e automazione delle operazioni costituisce il nucleo tecnico della piattaforma, con l’obiettivo di aumentare la continuità del calcolo e la produttività effettiva delle risorse GPU.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)