
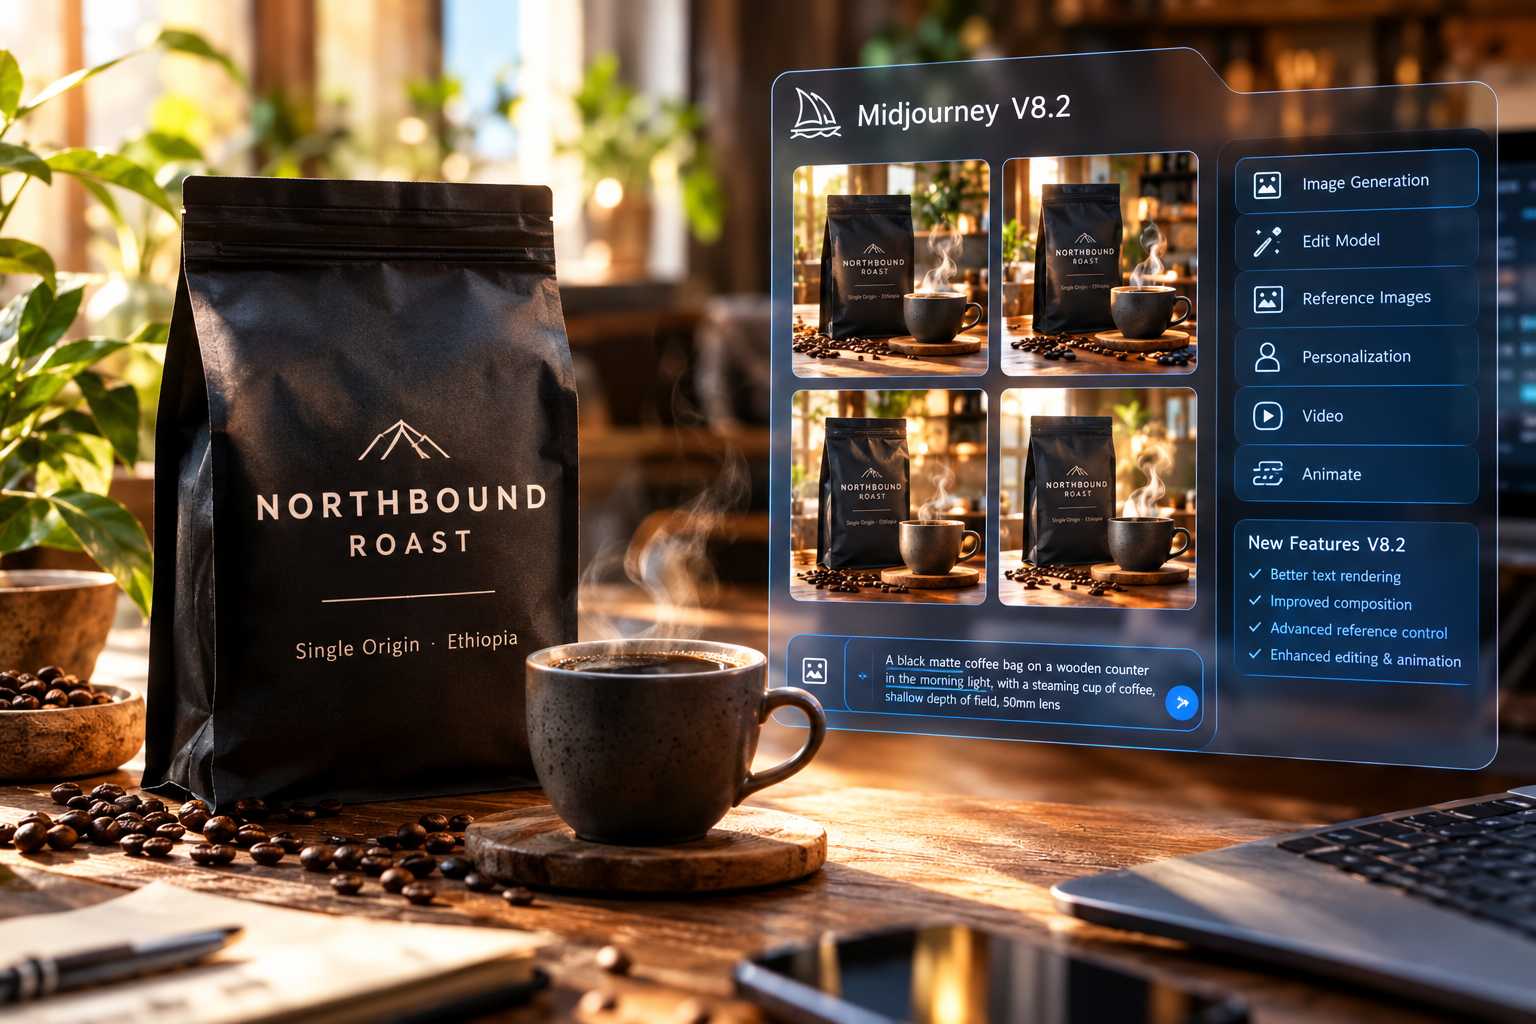
Midjourney ha ampliato le proprie funzionalità di generazione visiva attraverso la versione V8.2 del modello per immagini, diventata predefinita nel luglio 2026, introducendo miglioramenti nella qualità compositiva, nella gestione dei riferimenti visivi, nella riproduzione di brevi contenuti testuali e nell’integrazione con gli strumenti di editing e animazione. La piattaforma, sviluppata dal laboratorio indipendente fondato a San Francisco da David Holz, permette di generare immagini a partire da descrizioni in linguaggio naturale, normalmente organizzate in gruppi di quattro risultati, per poi modificarne singole parti, ottenere variazioni, cambiare l’inquadratura e produrre animazioni. L’interfaccia web consente di gestire l’intero processo senza ricorrere obbligatoriamente a Discord, che rimane comunque supportato. L’evoluzione recente comprende la versione V7 dell’aprile 2025, che aveva introdotto Draft Mode e Omni Reference, e V8.1 dell’aprile 2026, con generazione nativa a 2K e tempi di produzione sensibilmente ridotti, indicati come circa quattro volte inferiori rispetto alle versioni precedenti per le attività standard. Con V8.2 sono stati ulteriormente sviluppati gli strumenti di personalizzazione estetica e la gestione dei riferimenti, mentre il nuovo Edit Model sostituisce le precedenti funzioni Omni Reference, Character Reference e Retexture attraverso un unico sistema capace di elaborare fino a quattro immagini di riferimento e istruzioni testuali. Nell’ottobre 2026 è iniziata inoltre la sperimentazione di Thinking Mode, una funzione ancora in fase alpha progettata per riesaminare le immagini generate, confrontarle con le richieste iniziali e tentare una nuova elaborazione quando vengono rilevati errori relativi a oggetti, anatomia, disposizione degli elementi o contenuti testuali.
Le prove pratiche condotte con Midjourney V8.2 hanno evidenziato un miglioramento nella rappresentazione delle scritte brevi all’interno di fotografie sintetiche. Un primo esperimento ha utilizzato un prompt dedicato a una confezione di caffè nero opaco, collocata su un bancone di legno illuminato dalla luce del mattino, con una tazza fumante, profondità di campo ridotta e inquadratura fotografica equivalente a un obiettivo da 50 millimetri. La confezione doveva riportare il marchio NORTHBOUND ROAST e la dicitura secondaria Single Origin · Ethiopia. Il modello ha prodotto quattro immagini in circa 20 secondi, riproducendo correttamente entrambe le scritte in tutti i risultati, senza errori ortografici, caratteri aggiuntivi o deformazioni evidenti delle lettere. Anche gli altri elementi richiesti, compresi il materiale della confezione, il vapore, l’illuminazione e la composizione, risultavano coerenti con il prompt, senza anomalie significative nei contorni degli oggetti. Si tratta tuttavia di una verifica circoscritta a due brevi righe di testo, che non permette di estendere automaticamente il risultato a impaginazioni complesse, infografiche, menu o documenti caratterizzati da una densità testuale elevata. Per la generazione ad alta definizione è disponibile la modalità nativa da 2.048 pixel, attivabile attraverso il parametro –hd, con un consumo indicativo di 1,3 minuti di elaborazione GPU per generazione, rispetto a circa 0,8 minuti in modalità standard. Il parametro –raw permette invece di ridurre l’impronta stilistica predefinita del modello per ottenere risultati più aderenti alla descrizione, particolarmente utili nella fotografia di prodotto e nelle composizioni realistiche.
Un secondo insieme di prove ha riguardato la conservazione dell’identità grafica di un personaggio attraverso scene differenti. Il soggetto iniziale era una piccola volpe rossa illustrata ad acquerello, con impermeabile giallo e stivali verdi, successivamente riprodotta mentre leggeva sotto un fungo durante un temporale, attraversava in bicicletta un parco autunnale e dormiva in una camera con l’impermeabile appeso a un gancio. Le immagini iniziali sono state prodotte in circa 15 secondi e una di esse è stata utilizzata come riferimento nel nuovo Edit Model per tutte le successive generazioni. Il sistema ha mantenuto con buona coerenza la forma del muso, i dettagli delle orecchie e della coda, i colori degli indumenti e lo stile ad acquerello, anche nella scena laterale della bicicletta. È però emerso un limite nella comprensione di alcuni rapporti spaziali e funzionali tra gli oggetti: nella scena notturna l’impermeabile veniva rappresentato appeso in maniera innaturale, con il cappuccio rivolto nella direzione sbagliata. Il tentativo di correzione mediante Thinking Mode non ha risolto il problema e ha prodotto una versione nella quale il gancio attraversava il cappuccio. Anche una successiva modifica localizzata attraverso Editor e Smart Select, accompagnata da un’istruzione specifica sulla posizione del colletto e del cappuccio, ha mantenuto l’errore, riducendo inoltre la precisione dei dettagli. Questi risultati mostrano che gli strumenti di riferimento possono assicurare un’elevata continuità visiva tra immagini successive senza garantire necessariamente la correttezza geometrica o funzionale di tutti gli elementi rappresentati.
La componente video permette di trasformare immagini generate o caricate dall’utente in sequenze animate inizialmente lunghe cinque secondi, estendibili con incrementi di quattro secondi fino a una durata massima di 21 secondi. Sono disponibili controlli per l’intensità del movimento, la ripetizione ciclica e la definizione di un fotogramma finale, con risoluzioni di 480p in modalità standard e 720p in alta definizione. Non è invece prevista una generazione video completamente autonoma da prompt testuale, né una componente audio integrata. Per verificare la qualità dell’animazione è stata utilizzata l’immagine della confezione di caffè, chiedendo al sistema di produrre un lento movimento della telecamera verso il prodotto, oscillazioni della luce naturale e vapore in movimento. Quattro clip HD con movimento ridotto sono stati generati in circa due minuti, consumando 26 minuti della quota Fast GPU. Le animazioni presentavano movimenti generalmente fluidi e mantenevano leggibile la scritta principale della confezione, ma deformavano sistematicamente il testo secondario più piccolo. L’estensione della sequenza ha richiesto ulteriori 25 minuti Fast e prodotto quattro nuove varianti, nelle quali il testo rimaneva alterato e il movimento della telecamera rendeva progressivamente meno realistico il vapore, trasformandolo in forme visivamente troppo compatte. Nessun filmato includeva audio. Complessivamente, la produzione della sequenza e delle sue estensioni ha consumato circa 51 minuti Fast, contro i circa 15 minuti utilizzati per gli esperimenti sulle immagini statiche, evidenziando una differenza significativa nel costo computazionale delle due modalità.
La piattaforma integra anche riferimenti stilistici tramite il parametro –sref, moodboard e strumenti di Personalization che consentono di costruire preferenze visive attraverso valutazioni o raccolte di immagini. Sono disponibili funzioni di inpainting e outpainting per modificare aree selezionate o ampliare l’inquadratura, con la particolarità che gli interventi su immagini HD possono riportare il risultato alla risoluzione standard fino a una nuova operazione di upscaling. Cartelle condivise permettono inoltre di organizzare il lavoro tra più collaboratori. Midjourney non prevede un piano gratuito o una prova senza abbonamento; il piano Basic include circa 3,3 ore mensili di elaborazione Fast GPU, mentre Standard, proposto a 30 dollari mensili, comprende 15 ore Fast e generazioni illimitate in modalità Relax. Il piano Pro da 60 dollari mensili introduce la modalità Stealth, necessaria per mantenere private le immagini che altrimenti sono pubbliche per impostazione predefinita. L’utilizzo commerciale è previsto nei piani a pagamento, con requisiti specifici per le aziende che superano un milione di dollari di fatturato annuo, alle quali sono richiesti Pro o Mega. Nell’ambito delle alternative disponibili, ImagineArt e GetIMG offrono accesso a più modelli per immagini e video, mentre ChatGPT Images 2.0 si distingue nei flussi di modifica conversazionale e nei contenuti con istruzioni dettagliate o quantità elevate di testo. La tecnologia Midjourney è stata inoltre oggetto di un accordo di licenza con Meta nell’agosto 2025 e di controversie sul diritto d’autore avviate da Disney, Universal e Warner Bros. Discovery. I risultati disponibili confermano pertanto capacità consolidate nella composizione visiva e nella continuità stilistica delle immagini, mentre la generazione video rimane limitata dalla deformazione delle scritte minute, dall’assenza di audio e dall’elevato consumo delle risorse computazionali previste dagli abbonamenti.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)