
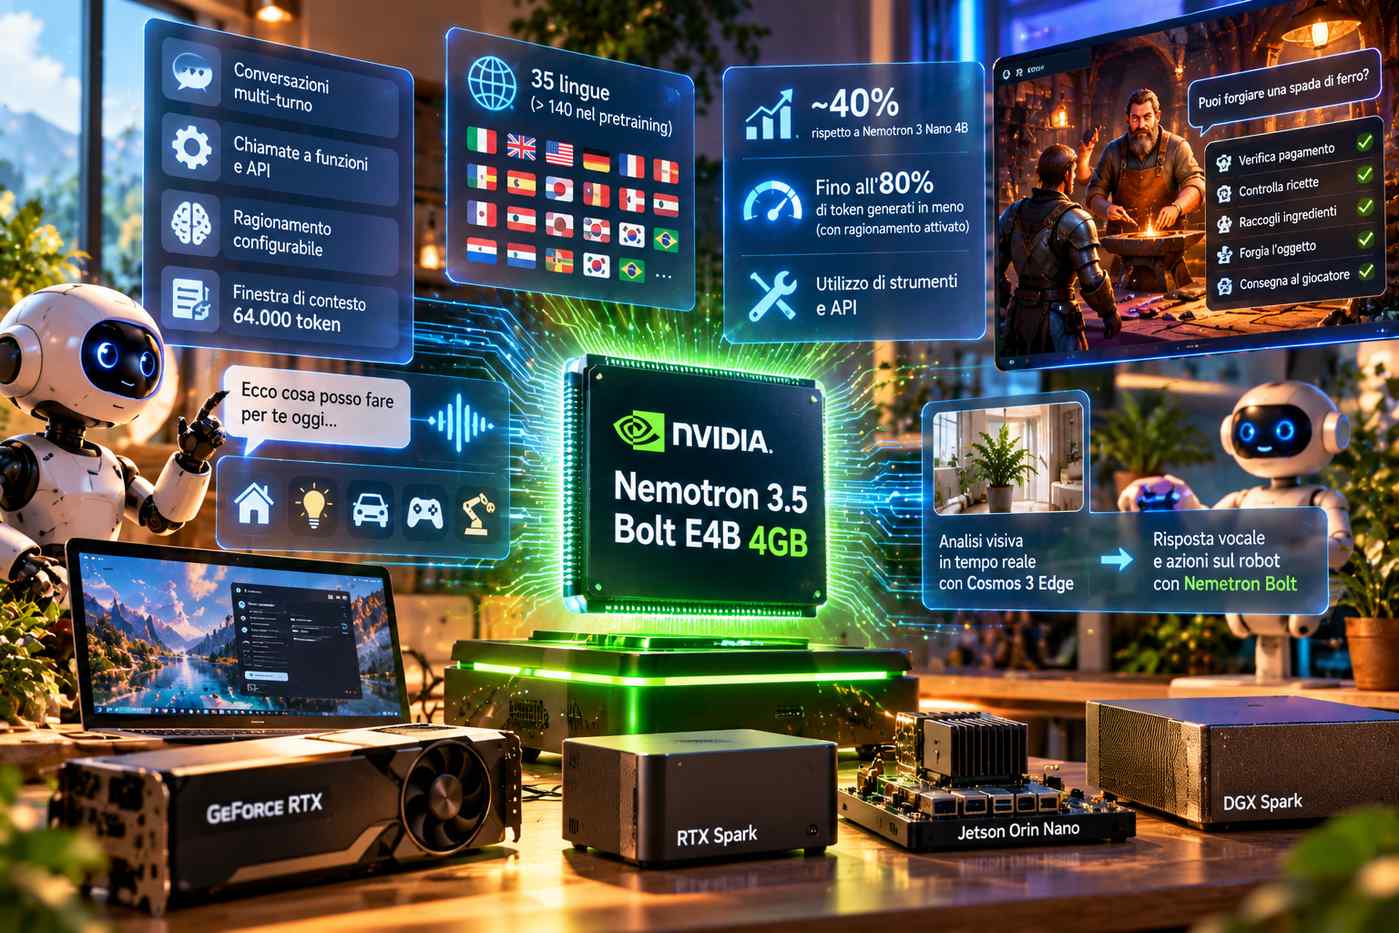
NVIDIA ha rilasciato Nemotron 3.5 Bolt E4B 4GB, un modello linguistico aperto progettato per applicazioni conversazionali e agentiche eseguite direttamente su dispositivi locali, sistemi embedded e piattaforme robotiche. Disponibile dal 23 ottobre 2026, il modello deriva da Gemma 4 E4B ed è stato ulteriormente addestrato attraverso le metodologie di post-training della famiglia Nemotron, con particolare attenzione all’efficienza nell’utilizzo della memoria, alla velocità di generazione e alla capacità di interagire con strumenti esterni durante conversazioni articolate. L’architettura è destinata a piattaforme NVIDIA GeForce RTX, Jetson, RTX Spark e DGX Spark, con configurazioni in grado di contenere l’impronta di memoria del modello intorno ai 4 GB nei carichi di lavoro previsti. La soluzione supporta conversazioni multi-turno, chiamate a funzioni e API, ragionamento configurabile e una finestra di contesto di 64.000 token, utilizzabile per mantenere istruzioni, cronologia della conversazione, definizioni degli strumenti e informazioni provenienti dall’ambiente operativo. Il supporto linguistico comprende 35 lingue, mentre il modello di base deriva da un preaddestramento multilingue su oltre 140 lingue.
Il sistema è stato sviluppato per applicazioni nelle quali un agente deve combinare dialogo naturale e azioni operative, rispettando vincoli di memoria, consumo computazionale e latenza. NVIDIA individua fra le principali destinazioni gli assistenti vocali integrati in computer e dispositivi, i sistemi di controllo domestico, le interfacce dei veicoli, i personaggi interattivi dei videogiochi e le applicazioni industriali basate su robotica e Internet of Things. Un esempio riguarda il robot Reachy Mini, eseguito su Jetson Orin Nano da 8 GB, nel quale Cosmos 3 Edge fornisce informazioni visive in tempo reale e Nemotron Bolt utilizza tali informazioni per produrre risposte vocali e richiamare gli script che controllano le animazioni del robot. Un’altra dimostrazione coinvolge un personaggio non giocante con il ruolo di fabbro all’interno di un videogioco: il modello verifica il pagamento, consulta strumenti per identificare le ricette di produzione, raccoglie gli ingredienti, realizza l’oggetto richiesto e lo trasferisce al giocatore. In entrambi i casi il modello non è destinato esclusivamente alla generazione di testo, ma alla gestione coordinata di conversazioni, strumenti e stati applicativi.
Secondo le valutazioni pubblicate da NVIDIA, Nemotron 3.5 Bolt E4B registra un miglioramento medio di circa il 40% rispetto al precedente Nemotron 3 Nano 4B nei benchmark selezionati per gli agenti conversazionali, oltre a risultati medi superiori di circa il 10% rispetto agli altri modelli confrontati. La riduzione dei token generati può arrivare all’80% nei confronti effettuati con il ragionamento attivato, contribuendo a contenere i tempi di elaborazione. Su MultiChallenge, dedicato alla coerenza delle istruzioni attraverso più turni, il modello raggiunge 53,1 punti rispetto ai 35,3 del predecessore; su RoleMRC, che misura il rispetto dell’identità e del comportamento assegnati a un personaggio, ottiene 80,6 contro 47,0. Nei test di selezione e utilizzo degli strumenti raggiunge 68,5 su BFCL-v3 e 68,8 su ToolSandbox, mentre su When2Call-MT, che verifica la scelta fra utilizzare uno strumento, chiedere chiarimenti o astenersi, ottiene 63,4. Per il rispetto della gerarchia delle istruzioni raggiunge 84,8 su IHEval, contro 51,3 del modello precedente, e per la produzione di output strutturati registra 80,4 su StructEval-T.
Le misurazioni relative alla memoria e alle prestazioni di inferenza mostrano differenze significative a seconda dell’hardware utilizzato. Con quantizzazione Q4_K_M, una GeForce RTX 5070 da 12 GB registra circa 3,5 GB di memoria occupata, un tempo al primo token di 548 millisecondi e una velocità di 133,4 token al secondo nella configurazione con 3.000 token in ingresso e 50 in uscita. Su RTX Spark la stessa configurazione utilizza circa 3,1 GB e raggiunge 67 token al secondo. Su Jetson Orin Nano da 8 GB l’occupazione sale a circa 4,2 GB, con un tempo al primo token di 5.785 millisecondi e una velocità di 15,5 token al secondo. I risultati sono stati ottenuti con batch unitario, eseguendo llama.cpp con backend CUDA e utilizzando AIPerf per la misurazione. I valori variano in funzione della lunghezza del contesto, delle caratteristiche della macchina e delle impostazioni di esecuzione.
Il post-training è stato effettuato utilizzando reinforcement learning con ricompense verificabili, RLVR, e reinforcement learning da feedback umano, RLHF, attraverso NeMo-RL e NeMo-Gym. I dataset impiegati comprendono attività di utilizzo degli strumenti, rispetto delle istruzioni, gerarchia dei comandi, formattazione degli output e gestione delle conversazioni. NVIDIA ha mantenuto un rapporto di due campioni senza ragionamento esplicito per ogni campione con ragionamento, applicando penalizzazioni sulla lunghezza delle risposte per limitarne la verbosità. Il checkpoint selezionato è stato successivamente quantizzato da BF16 a Q4_K_M mediante llama.cpp, con una procedura di calibrazione basata su circa un milione di token. Il rilascio comprende inoltre DFlash, un modello ausiliario per la generazione speculativa che propone più token in parallelo e consente, secondo i test presentati, un incremento del throughput fino al 21% rispetto al precedente meccanismo MTP di Gemma 4 E4B. Sono disponibili checkpoint, configurazioni e ricette di addestramento, oltre all’integrazione con Hugging Face, Ollama, LM Studio, Unsloth e Jetson AI Lab.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)