
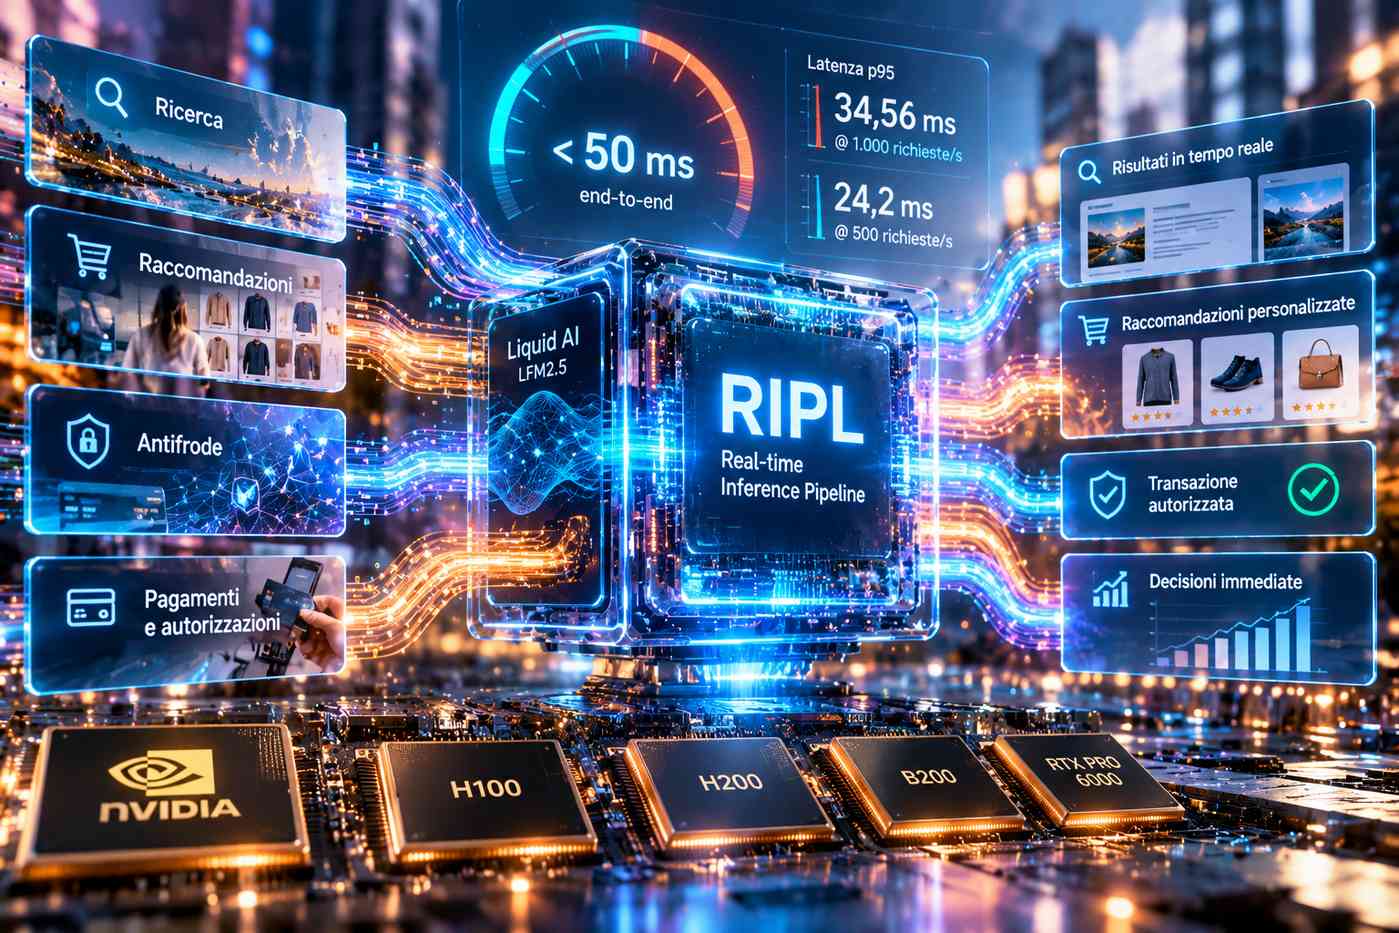
Liquid AI ha introdotto RIPL, acronimo di Real-time Inference Pipeline, un motore di inferenza progettato per eseguire i Liquid Foundation Models all’interno di applicazioni caratterizzate da vincoli di latenza particolarmente rigorosi. La soluzione è destinata a elaborare richieste in tempo reale, con l’obiettivo di completare l’intero ciclo di generazione della risposta in meno di 50 millisecondi nelle configurazioni previste, mantenendo prestazioni stabili anche durante la ricezione continua di traffico elevato. La piattaforma è sviluppata per processi nei quali la risposta del modello deve essere disponibile prima che una transazione o un’interazione possa proseguire, come il posizionamento dei risultati di ricerca, i sistemi di raccomandazione, le decisioni antifrode e le autorizzazioni dei pagamenti. Queste applicazioni hanno tradizionalmente impiegato modelli predittivi relativamente compatti, tra cui gradient-boosted trees e sistemi basati su embedding, perché i normali sistemi di serving dei modelli linguistici sono generalmente ottimizzati per richieste più lunghe, elaborazione in batch o flussi agentici che tollerano tempi di risposta nell’ordine dei secondi.
RIPL è stato progettato per integrare i modelli della famiglia LFM2.5 direttamente nei percorsi operativi delle applicazioni, riducendo il tempo necessario per ottenere una risposta completa e non soltanto quello richiesto per generare il primo token. La distinzione è importante perché, nelle applicazioni transazionali, la disponibilità del primo frammento di testo non è sufficiente per completare una decisione automatizzata: il sistema deve attendere l’output necessario per elaborare la richiesta. Liquid AI utilizza pertanto misurazioni end-to-end e valori di latenza al 95° percentile, indicati come p95, per descrivere il comportamento del motore in condizioni di carico. Nei confronti pubblicati, LFM2.5-1.2B eseguito su RIPL registra latenze p95 inferiori da 14,4 a 28,4 volte rispetto a Qwen3.5-0.8B eseguito su vLLM, nei due scenari operativi presi in considerazione. Per il modello LFM2.5-2.6B, il vantaggio dichiarato rispetto a Qwen3.5-2B varia da 5,6 a 7,7 volte. Si tratta di confronti fra combinazioni differenti di modelli e motori di inferenza, non di una misurazione isolata del solo contributo del software RIPL.
Una delle configurazioni presentate riguarda LFM2.5-1.2B eseguito su una GPU NVIDIA B200, con richieste composte da 32 token in ingresso e 32 token in uscita. A una frequenza di 1.000 richieste al secondo viene riportata una latenza p95 end-to-end di 34,56 millisecondi, mentre LFM2.5-2.6B raggiunge 76,44 millisecondi nello stesso scenario. Questi risultati mostrano che l’obiettivo inferiore a 50 millisecondi dipende dal modello, dalle dimensioni delle richieste e dal carico applicativo. Un’ulteriore misurazione riferita a 500 richieste al secondo indica una latenza p95 di 24,2 millisecondi. La piattaforma è quindi orientata a servizi che richiedono contemporaneamente throughput elevato e tempi di risposta prevedibili, piuttosto che alla sola accelerazione delle singole richieste in condizioni di traffico ridotto.
Liquid AI ha indicato Shopify tra le aziende che impiegano i suoi Foundation Models in ambienti produttivi per processi commerciali sensibili alla latenza. Fra gli impieghi citati figura il miglioramento della ricerca nei servizi di commercio elettronico, dove i modelli LFM possono raggiungere tempi di inferenza inferiori a 20 millisecondi su carichi reali. Secondo i dati comunicati, modelli con circa il 50% di parametri in meno rispetto alle alternative considerate ottengono risultati qualitativi superiori, accompagnati da velocità di inferenza da due a dieci volte maggiori. La riduzione del tempo di elaborazione consente di utilizzare modelli generativi specializzati in parti dell’applicazione che richiedono decisioni immediate, senza necessariamente introdurre le latenze caratteristiche dei sistemi linguistici generalisti.
RIPL è disponibile per implementazioni aziendali dei Liquid Foundation Models su acceleratori NVIDIA, compresi H100, H200, B200 e RTX PRO 6000. La distribuzione annunciata riguarda quindi l’esecuzione dei modelli LFM su infrastrutture GPU supportate, con configurazioni orientate alle esigenze di applicazioni commerciali e industriali. Le informazioni pubblicate descrivono prestazioni, categorie applicative e piattaforme hardware compatibili, ma non specificano un listino commerciale generale né una disponibilità self-service universale. I benchmark riportati costituiscono misurazioni comunicate da Liquid AI e devono essere interpretati in relazione alle precise configurazioni di modello, motore di esecuzione, dimensione degli input e frequenza delle richieste utilizzate nei test.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)