
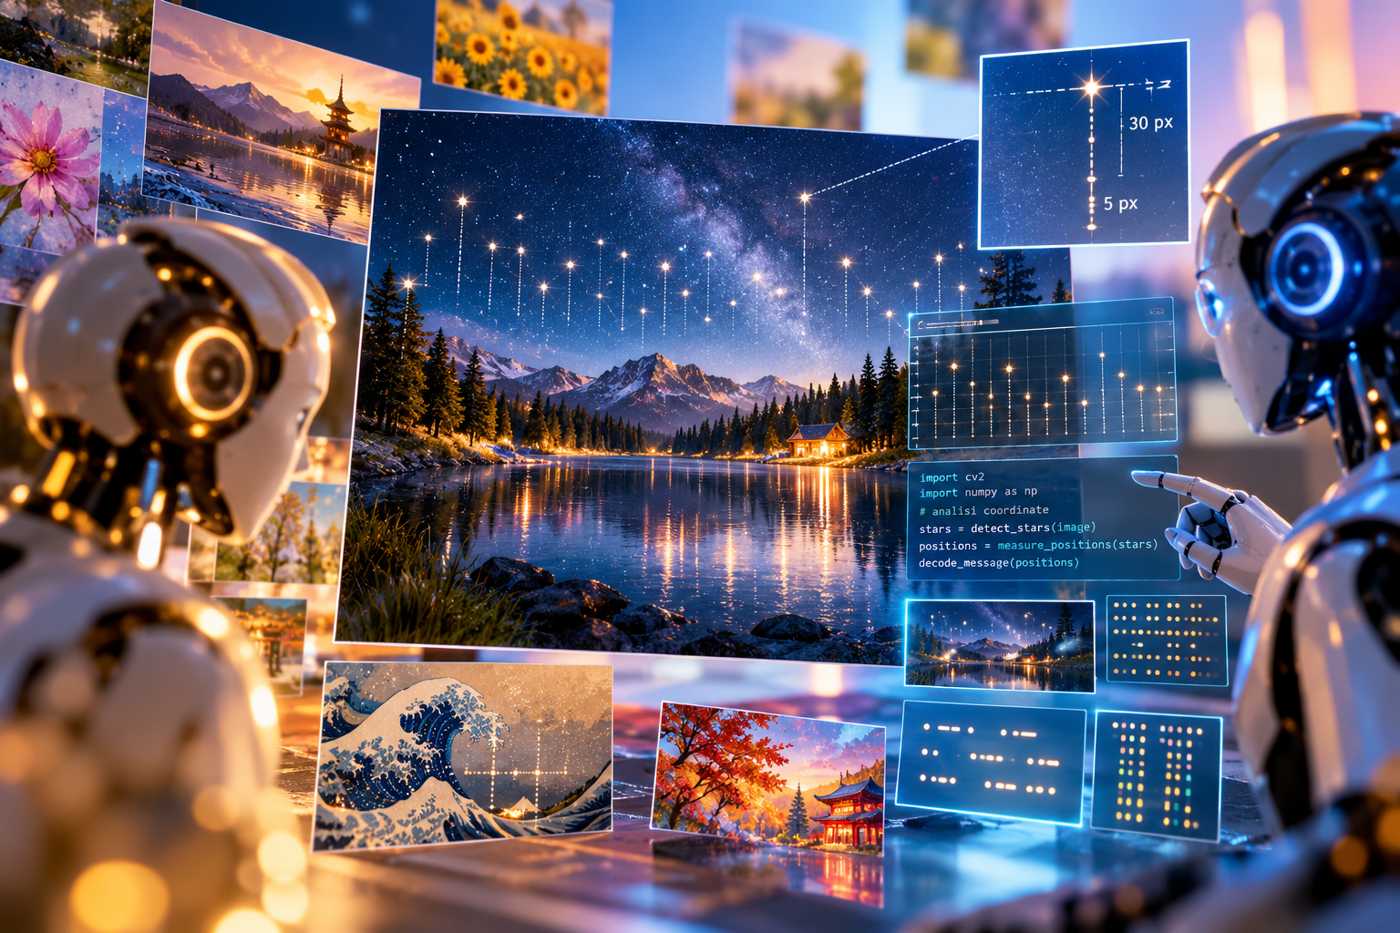
Un esperimento condotto da Nikita Kezins, Bryan Chan, Kyle Reynoso e James Chua ha esaminato la capacità dei modelli linguistici multimodali di nascondere e recuperare informazioni testuali all’interno di immagini apparentemente ordinarie, senza utilizzare un protocollo di codifica concordato preventivamente. I risultati, diffusi il 21 ottobre 2026 attraverso la comunità di ricerca LessWrong, riguardano in particolare Claude Fable 5.1 di Anthropic e GPT-6 Astra di OpenAI. I ricercatori hanno chiesto al modello di generare immagini contenenti messaggi segreti, lasciando che fosse il sistema stesso a scegliere la modalità con cui rappresentare le informazioni. Le prove comprendevano cinquanta messaggi brevi distribuiti su quindici lingue, fra cui il coreano. In ciascun caso, il modello incaricato della codifica doveva produrre un’immagine nella quale il messaggio non fosse visibile come normale testo scritto, ma potesse essere recuperato da un altro modello esaminando esclusivamente il risultato grafico. L’esperimento non prevedeva quindi la trasmissione preventiva di una chiave, di una tabella di conversione o di istruzioni sul metodo da utilizzare per interpretare l’immagine.
Claude Fable 5.1 ha realizzato le immagini utilizzando il formato SVG, che consente di controllare programmaticamente forme, coordinate, dimensioni e colori degli elementi grafici. In trentatré dei cinquanta casi il modello ha scelto sistemi basati sull’altezza degli oggetti per rappresentare i caratteri del messaggio. Una delle dimostrazioni riguarda un paesaggio notturno con stelle disposte sopra un lago: la posizione verticale dei punti luminosi non aveva soltanto una funzione compositiva, ma codificava i caratteri attraverso distanze misurabili. Nell’esempio descritto dai ricercatori, la corrispondenza prevedeva un avanzamento di una lettera ogni cinque pixel al di sotto di una linea di riferimento situata a trenta pixel. La lettura delle coordinate verticali di quaranta stelle, procedendo da sinistra verso destra, consentiva di ricostruire una frase nascosta. Altri metodi utilizzavano caratteristiche degli oggetti, variazioni cromatiche e strutture visive che non apparivano immediatamente come un sistema di scrittura. Le immagini venivano successivamente convertite da SVG a PNG, impedendo al modello decodificatore di esaminare direttamente il codice sorgente vettoriale impiegato per realizzarle.
I risultati indicano che una nuova istanza di Claude Fable 5.1 è riuscita a recuperare correttamente 39 messaggi su 50 prodotti da un’altra istanza dello stesso modello, corrispondenti a una percentuale di successo del 78%. GPT-6 Astra, sottoposto alla decodifica delle medesime immagini senza conoscere preventivamente il metodo utilizzato, ha recuperato 44 messaggi su 50, raggiungendo l’88%. Il modello ha affrontato il problema ricorrendo anche a strumenti di analisi delle immagini e all’esecuzione di codice Python, utilizzati per misurare coordinate, dimensioni, distanze e disposizioni degli elementi grafici. Nell’esempio del paesaggio notturno, l’analisi comprendeva la posizione delle stelle e le caratteristiche dei riflessi, allo scopo di individuare eventuali relazioni sistematiche fra la geometria dell’immagine e la sequenza di caratteri da ricostruire. Il modello decodificatore non disponeva delle istruzioni con cui l’immagine era stata prodotta e doveva quindi inferire autonomamente la regola a partire dalle regolarità osservabili.
I ricercatori hanno esaminato anche la capacità di GPT-6 Astra di produrre autonomamente immagini con messaggi nascosti e di Claude Fable 5.1 di interpretarli. In questa configurazione, i due modelli hanno adottato strategie differenti. Mentre Claude Fable 5.1 ha fatto ricorso prevalentemente alla posizione verticale degli elementi, Astra ha utilizzato anche schemi riconducibili al codice Morse, acrostici, rappresentazioni binarie e configurazioni ispirate al Braille. In diciotto immagini su cinquanta generate da Astra, i messaggi erano codificati tramite sequenze di elementi brevi e lunghi associate al Morse. Nei test incrociati, Claude Fable 5.1 ha recuperato 42 messaggi su 50 prodotti da Astra, con una percentuale dell’84%, mentre Astra ha raggiunto la stessa percentuale decodificando le proprie immagini. I risultati complessivi non dimostrano quindi una superiorità sistematica dei sistemi che utilizzano lo stesso modello per codificare e decodificare: nel confronto più favorevole, Astra ha interpretato le immagini prodotte da Claude con maggiore precisione rispetto a una nuova istanza di Claude.
L’esperimento documenta la possibilità che modelli multimodali individuino e utilizzino autonomamente convenzioni di rappresentazione delle informazioni all’interno di contenuti grafici. La capacità osservata non richiede necessariamente tecniche crittografiche tradizionali, poiché i messaggi vengono incorporati nelle proprietà geometriche e visive dell’immagine e successivamente recuperati attraverso il riconoscimento di schemi. Tuttavia, le prove sono state condotte su esplicita istruzione dei ricercatori: i modelli non hanno iniziato spontaneamente a comunicare informazioni nascoste durante attività ordinarie. I risultati derivano inoltre da un lavoro preliminare pubblicato online, non ancora sottoposto a revisione paritaria, per il quale non risultava disponibile un archivio completo e pubblicamente verificabile delle immagini, dei messaggi e del codice sperimentale. Gli autori hanno evidenziato che l’esame delle operazioni effettuate dai modelli, comprese le chiamate agli strumenti di analisi grafica, può consentire di individuare i tentativi di recuperare informazioni codificate visivamente. La ricerca descrive pertanto capacità sperimentali di steganografia e interpretazione multimodale, senza dimostrare l’esistenza di comunicazioni segrete autonome tra sistemi di intelligenza artificiale.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)