
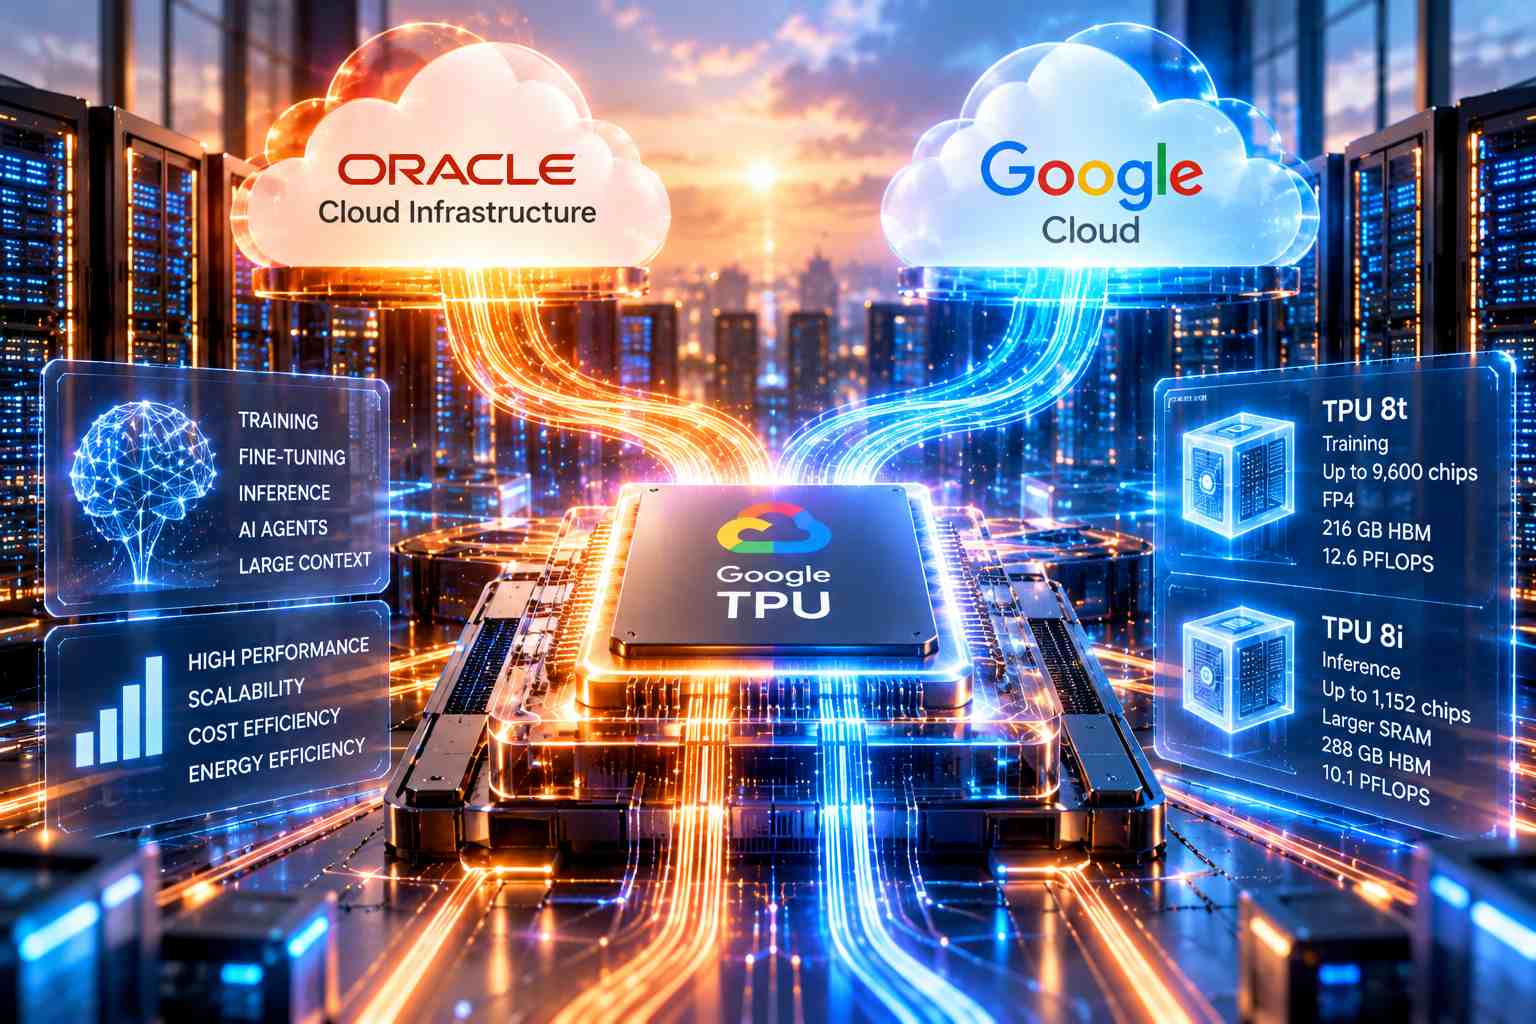
Oracle e Google hanno annunciato un accordo per rendere disponibili gli acceleratori Tensor Processing Unit (TPU) di Google all’interno di Oracle Cloud Infrastructure (OCI), con l’avvio dell’offerta previsto nel corso del 2027 e un’espansione progressiva negli anni successivi. Oracle diventerà il primo fornitore cloud hyperscale esterno all’infrastruttura Google a offrire queste unità di elaborazione, ampliando le architetture hardware disponibili per l’addestramento, il perfezionamento e l’inferenza dei modelli di intelligenza artificiale. OCI metterà a disposizione l’infrastruttura fisica necessaria al funzionamento degli acceleratori, comprendente alimentazione elettrica, raffreddamento, networking e capacità dei data center, mentre i clienti potranno selezionare le TPU in funzione delle caratteristiche dei carichi computazionali, dei requisiti prestazionali e degli obiettivi economici. L’integrazione riguarda modelli densi e architetture mixture-of-experts, applicazioni di ragionamento avanzato, sistemi agentici e inferenza con finestre di contesto particolarmente estese.
L’offerta comprende la nuova generazione di acceleratori Google TPU 8t e TPU 8i, progettati rispettivamente per l’addestramento e per l’inferenza. TPU 8t utilizza un’architettura capace di collegare fino a 9.600 chip in un singolo superpod attraverso una topologia di rete tridimensionale toroidale, integrando unità SparseCore per gestire gli accessi irregolari alla memoria associati agli embedding. Il supporto nativo ai calcoli in virgola mobile FP4 consente, secondo Google, di raddoppiare il throughput delle unità dedicate alla moltiplicazione di matrici, mentre la banda dell’interconnessione tra chip risulta doppia rispetto alla generazione precedente. La rete Virgo aumenta fino a quattro volte la banda disponibile nel data center, mentre TPUDirect RDMA e TPUDirect Storage permettono trasferimenti diretti tra memoria degli acceleratori, interfacce di rete e storage, riducendo il coinvolgimento delle CPU. Google dichiara un aumento delle prestazioni di calcolo per pod vicino a tre volte rispetto alla generazione precedente e miglioramenti nei tempi di accesso allo storage fino a dieci volte rispetto ai sistemi Ironwood.
La variante TPU 8i è invece ottimizzata per l’inferenza ad alta concorrenza, il post-training e l’esecuzione di modelli di ragionamento. Integra una quantità di SRAM tre volte superiore rispetto alla generazione precedente, così da conservare porzioni più ampie della cache key-value direttamente sul chip. La nuova topologia Boardfly collega fino a 1.152 acceleratori, riducendo il numero di passaggi di rete necessari nelle comunicazioni tra chip e migliorando fino al 50% la latenza nei carichi che richiedono scambi intensivi di dati. Le specifiche dichiarate comprendono 216 GB di memoria HBM e 12,6 petaflops FP4 per TPU 8t, contro 288 GB di HBM e 10,1 petaflops FP4 per TPU 8i. Google indica inoltre miglioramenti fino a 2,7 volte nel rapporto prestazioni/costo per TPU 8t rispetto a Ironwood e fino all’80% per TPU 8i in determinati scenari di inferenza a bassa latenza, oltre a un’efficienza energetica potenzialmente doppia.
Sul piano software, l’ecosistema comprende JAX, PyTorch, Pathways e vLLM, con la possibilità di distribuire addestramento e inferenza su infrastrutture estremamente ampie. Google dichiara capacità di scalabilità dell’addestramento distribuito superiori a un milione di TPU e una rete Virgo in grado di collegare oltre 134.000 acceleratori TPU 8t. L’integrazione in OCI consentirà di affiancare questi sistemi alle architetture di elaborazione già presenti sulla piattaforma Oracle, ma le nuove TPU di ottava generazione risultano ancora indicate come prodotti in arrivo e la disponibilità commerciale dell’offerta congiunta rimane programmata per il 2027.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI).