
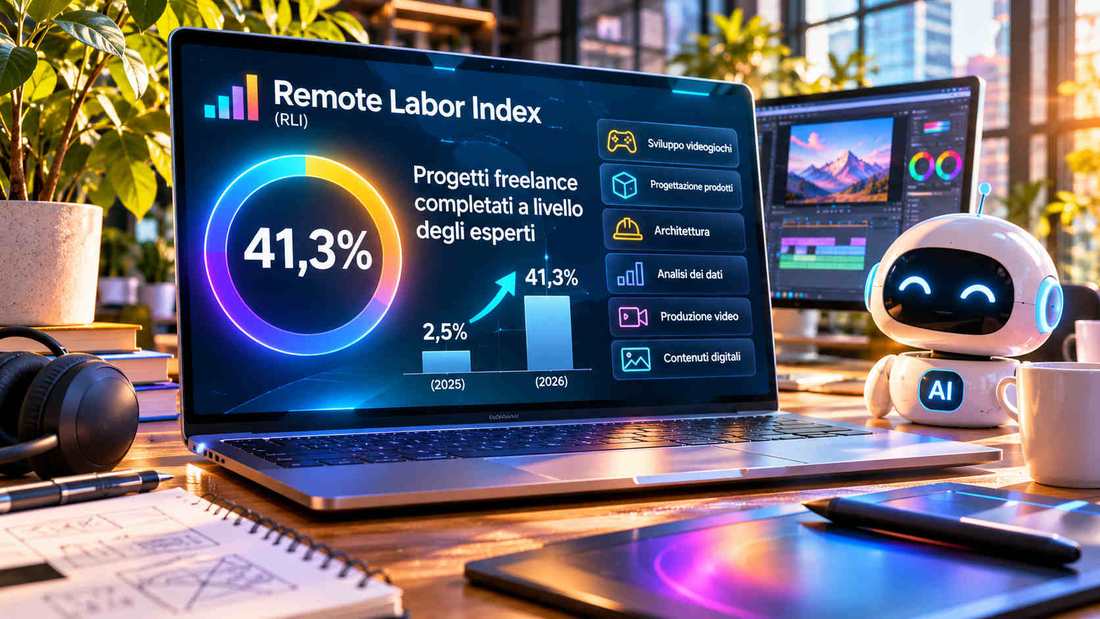
Il Remote Labor Index (RLI), un sistema di valutazione sviluppato dal Center for AI Safety e da Scale AI, ha registrato un incremento significativo delle capacità degli agenti di intelligenza artificiale nello svolgimento di attività professionali normalmente affidate a lavoratori freelance. Nell’aggiornamento pubblicato nel novembre 2026, Claude Fable 5.2 ha raggiunto un tasso di completamento del 41,3%, indicando che il modello è riuscito a produrre risultati giudicati equivalenti o superiori a quelli di professionisti umani in poco più di quattro progetti valutati su dieci. Il dato rappresenta un miglioramento rispetto al 2,5% raggiunto da Manus nella prima versione del benchmark, pubblicata nel 2025. La metodologia utilizzata non si limita a misurare conoscenze teoriche, capacità di ragionamento o accuratezza nella risposta a domande isolate, ma esamina la possibilità di completare interi incarichi professionali, dalla comprensione dei requisiti iniziali fino alla consegna di un risultato utilizzabile. Le attività appartengono a settori differenti, tra cui sviluppo di videogiochi, progettazione di prodotti, architettura, analisi dei dati, produzione video e realizzazione di contenuti digitali.
Il benchmark è stato costruito utilizzando 240 progetti effettivamente completati da professionisti, dei quali 230 vengono mantenuti riservati per le valutazioni e dieci sono disponibili come esempi pubblici. L’insieme degli incarichi comprende oltre 6.000 ore di lavoro umano e un valore economico complessivo superiore a 140.000 dollari. Alcuni progetti richiedono oltre cento ore di attività professionale e presentano un compenso superiore a 10.000 dollari, introducendo livelli di complessità sensibilmente maggiori rispetto ai tradizionali test basati su compiti brevi. Agli agenti AI vengono forniti i materiali e gli strumenti necessari per eseguire ogni incarico, ma il costo computazionale ammesso per ciascun progetto è limitato a 30 dollari. I risultati vengono confrontati con i prodotti consegnati dai professionisti originali e sottoposti alla valutazione di tre esaminatori, incaricati di stabilire se il materiale generato dall’AI raggiunga una qualità sufficiente per essere accettato da un cliente reale. La valutazione comprende quindi il rispetto delle specifiche, la qualità del prodotto finale e l’effettiva completezza dell’incarico, non soltanto la correttezza di singole risposte.
Nel confronto tra i sistemi più recenti, Claude Fable 5.2 ha ottenuto il risultato più elevato con il 41,3%, seguito da Claude Opus 5.5 al 21,3% e GPT-6 Astra al 20,8%. Il precedente Claude Fable 5.1 aveva raggiunto il 17,9%, mostrando quindi un incremento superiore al doppio nella generazione successiva. Le attività completate con maggiore successo comprendono la produzione di effetti sonori, la generazione di immagini, la redazione di report e la ricerca di dati. Le valutazioni hanno tuttavia evidenziato ancora numerosi casi nei quali gli agenti non riescono a terminare il lavoro, producono risultati di qualità insufficiente oppure non rispettano il formato richiesto per la consegna. Quest’ultimo aspetto è particolarmente importante nei processi professionali, nei quali la conformità del file, la struttura delle informazioni e il rispetto dei requisiti tecnici possono determinare l’accettazione del progetto indipendentemente dalla qualità generale del contenuto.
Il valore del 41,3% deve essere interpretato in relazione alla metodologia del Remote Labor Index e non rappresenta una stima della percentuale di posti di lavoro freelance destinati a essere sostituiti dall’automazione. Il benchmark misura infatti la quota di progetti selezionati per i quali un agente riesce a produrre un risultato valutato positivamente, all’interno di condizioni sperimentali che prevedono materiali già predisposti, strumenti accessibili e criteri di accettazione definiti. Non comprende necessariamente tutte le attività che accompagnano un incarico professionale reale, come la negoziazione con il cliente, la raccolta progressiva dei requisiti, la collaborazione tra gruppi di lavoro, le revisioni contrattuali e la gestione di richieste impreviste. Il progresso misurato riguarda comunque una capacità diversa da quella tradizionalmente osservata nei benchmark linguistici: l’esecuzione autonoma di procedure articolate che devono produrre un risultato economicamente utilizzabile. Il confronto tra i risultati del 2025 e quelli del 2026 evidenzia un miglioramento della capacità degli agenti di completare attività professionali, pur mantenendo una differenza sostanziale tra successo nei progetti valutati e affidabilità richiesta per un impiego continuativo nei processi lavorativi.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)