
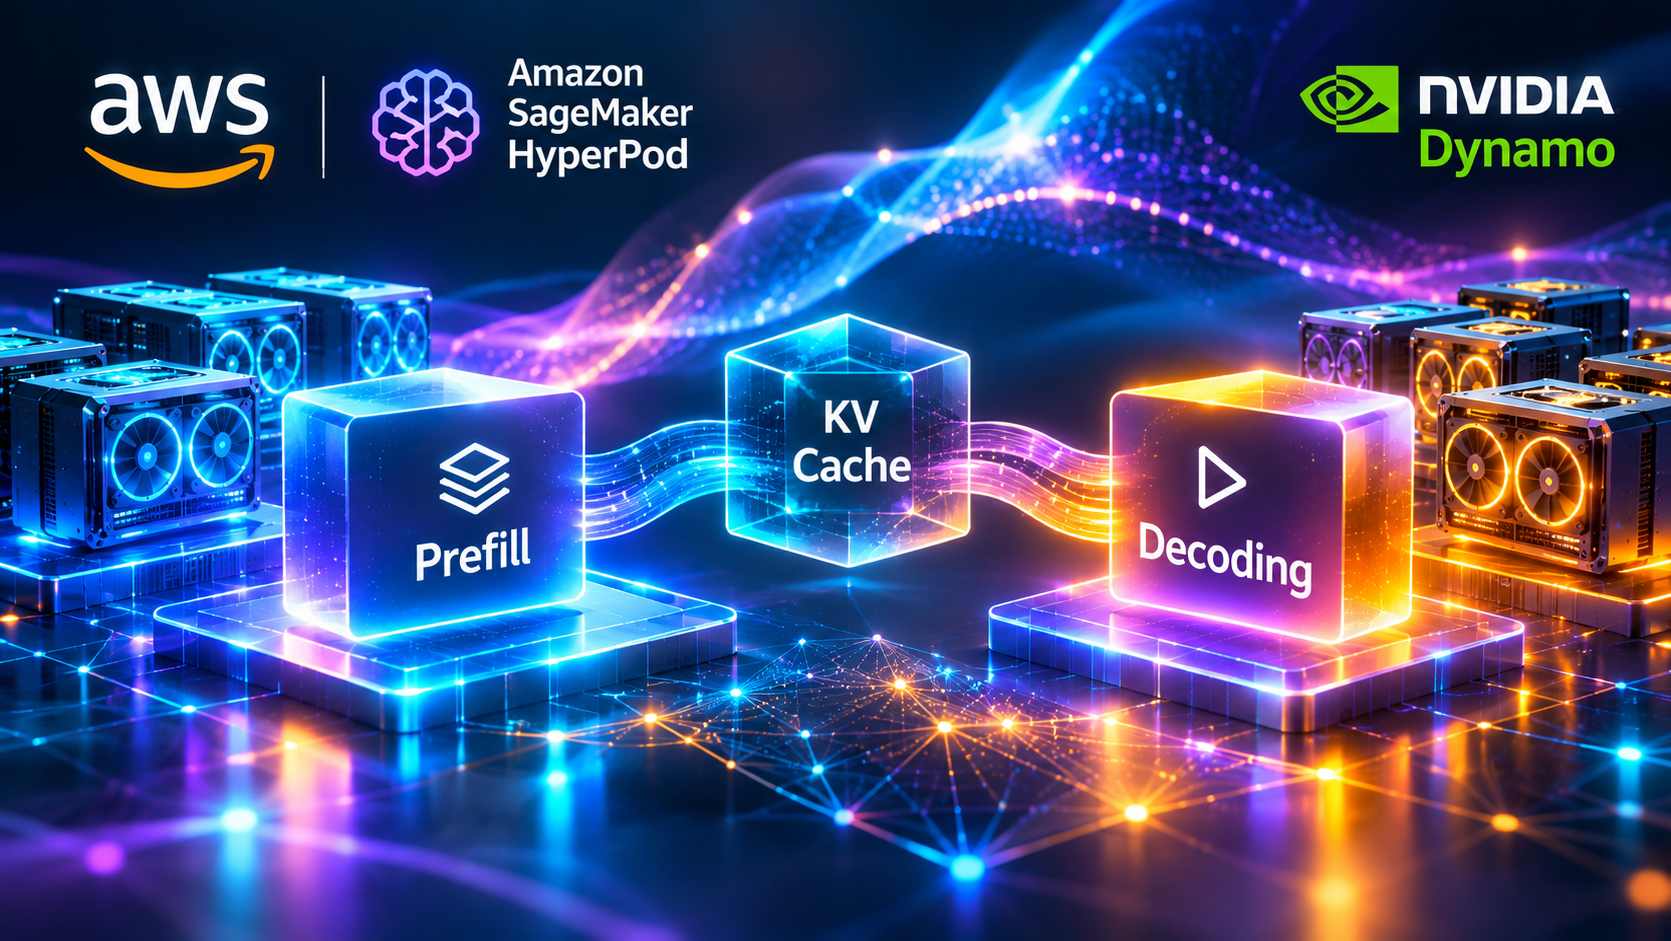
Amazon Web Services ha annunciato l’integrazione di NVIDIA Dynamo in Amazon SageMaker HyperPod Inference, introducendo il supporto gestito per l’esecuzione distribuita dei modelli linguistici di grandi dimensioni. Il framework open source sviluppato da NVIDIA consente di organizzare le risorse computazionali destinate all’inferenza attraverso configurazioni nelle quali le diverse fasi di elaborazione delle richieste vengono distribuite su gruppi indipendenti di acceleratori grafici. L’integrazione interviene sulla gestione della memoria delle GPU, sulla distribuzione dei carichi di lavoro e sul coordinamento dei processi che partecipano all’esecuzione dei modelli. AWS cita il caso di GLM-5.3, i cui pesi rappresentati in formato FP8 superano da soli i 640 GB di memoria grafica disponibili su un’istanza ml.p5.48xlarge, ai quali occorre aggiungere la memoria destinata alla cache e all’ambiente software di inferenza.
Le configurazioni supportate comprendono l’inferenza aggregata e quella disaggregata. Nella prima modalità il medesimo gruppo di acceleratori provvede sia all’elaborazione iniziale del prompt, denominata prefill, sia alla generazione progressiva dei token, denominata decoding. Nella seconda modalità queste operazioni sono assegnate a gruppi distinti di worker che possono essere dimensionati indipendentemente, ciascuno dei quali deve comunque caricare i pesi del modello nella loro interezza, eventualmente distribuendoli su più GPU. I dati intermedi conservati nella KV cache vengono trasferiti mediante la rete Elastic Fabric Adapter (EFA). NVIDIA Dynamo integra inoltre un sistema di instradamento che considera la disponibilità delle elaborazioni precedenti e il carico operativo dei worker per determinare la destinazione delle richieste. Il framework supporta vLLM, SGLang e TensorRT-LLM.
AWS ha confrontato le due modalità di esecuzione utilizzando Qwen3-235B-A22B-FP8, TensorRT-LLM e 16 GPU NVIDIA H200 distribuite su due istanze p5en.48xlarge. Le richieste generate mediante AIPerf comprendevano 4.000 token in ingresso e 200 token in uscita. Considerando esclusivamente le configurazioni caratterizzate da un tempo al primo token inferiore a un secondo al novantesimo percentile e una velocità mediana di almeno 50 token al secondo per utente, l’inferenza disaggregata ha raggiunto 207 token in uscita al secondo per GPU con 80 richieste concorrenti, mentre quella aggregata ha raggiunto 101 token al secondo con 32 richieste concorrenti. Il rapporto di 2,05 volte riguarda pertanto i migliori risultati misurati nel rispetto delle condizioni di latenza indicate, senza rappresentare un incremento generalizzabile a qualsiasi carico di lavoro.
Una seconda sperimentazione ha utilizzato Qwen3.5-397B-A17B-FP8 e vLLM, confrontando una configurazione dotata di otto H200 nella stessa istanza con una configurazione distribuita su due istanze, equipaggiate con quattro GPU ciascuna. A parità di modello, parallelismo e caratteristiche delle richieste, il sistema distribuito ha raggiunto 126,4 token in uscita al secondo per GPU, equivalenti al 99,1% delle prestazioni misurate sulla singola istanza, con 32 richieste concorrenti e un’elevata percentuale di riutilizzo dei prefissi. La prova è stata predisposta per misurare l’impatto della comunicazione tra nodi su un modello che può essere ospitato anche su una singola istanza.
HyperPod provvede al monitoraggio delle GPU, dei nodi e della rete EFA e alla sostituzione dei nodi non funzionanti. L’operatore di inferenza predispone i pesi provenienti da Amazon S3 o FSx e genera le risorse Kubernetes necessarie per la distribuzione. Grove e KAI Scheduler coordinano i gruppi di pod che devono essere avviati congiuntamente, mentre Kubernetes Event-driven Autoscaling (KEDA) supporta il dimensionamento dinamico delle risorse. Le organizzazioni possono utilizzare un manifesto DynamoGraphDeployment personalizzato oppure delegare la configurazione al servizio attraverso InferenceEndpointConfig e la specifica dynamoSpec. La configurazione gestita espone endpoint compatibili con il formato OpenAI e utilizza vLLM come motore di inferenza predefinito.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)