
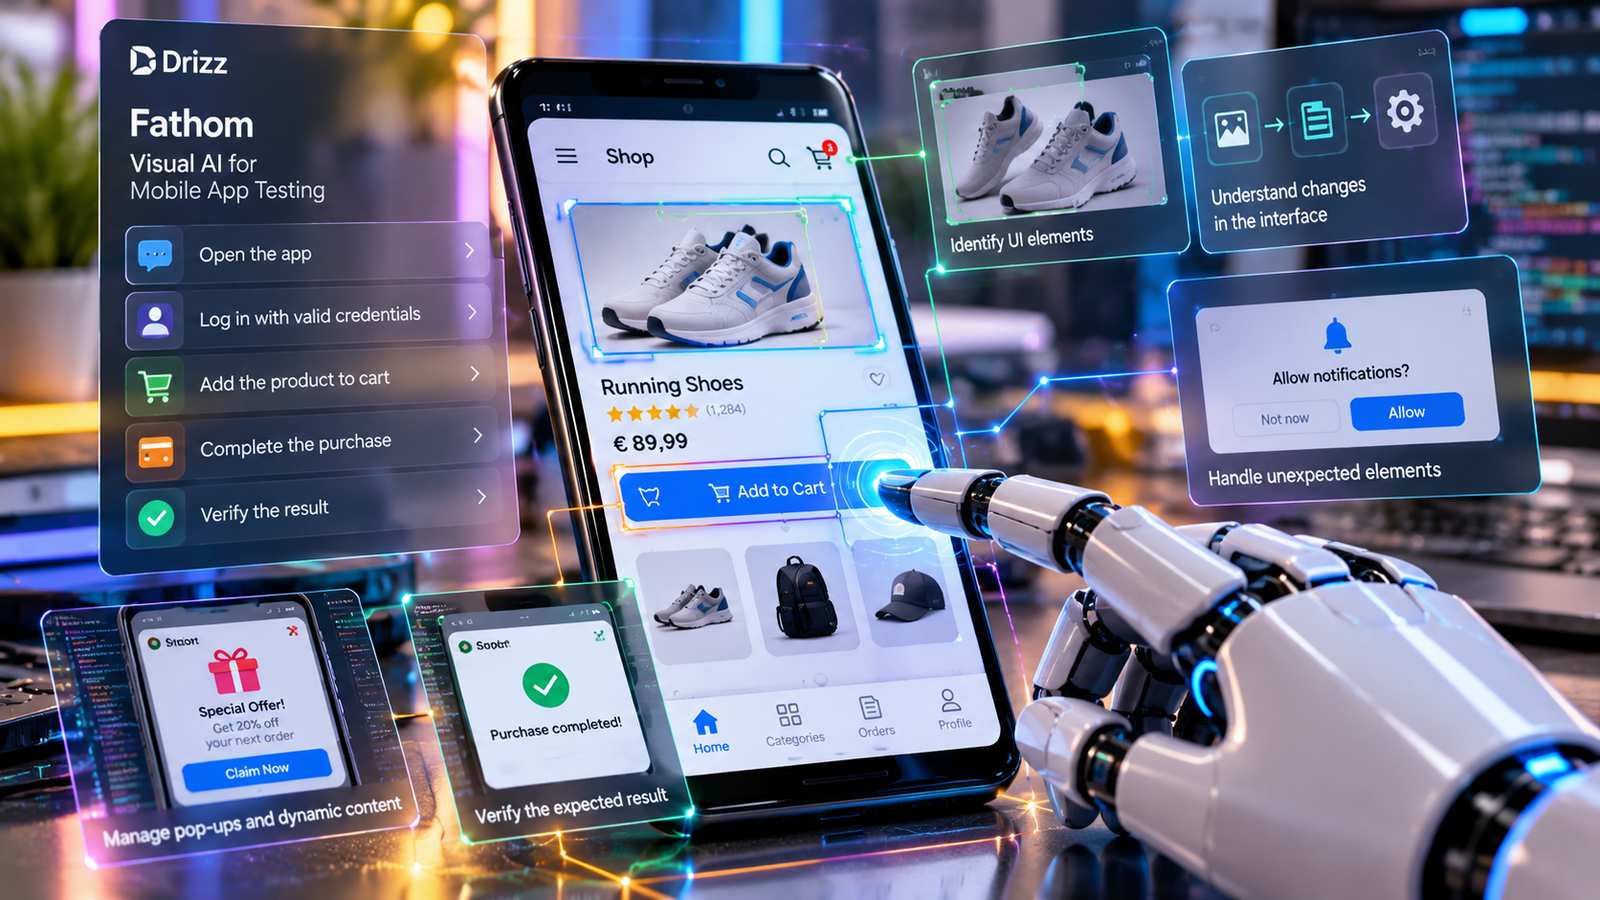
Drizz, startup con sede a Bengaluru fondata da Asad Abrar, Yash Varyani e Partha Sarathi Mohanty, sta sviluppando una piattaforma di automazione dei test delle applicazioni mobili basata sull’interpretazione visiva delle interfacce. Il sistema, denominato Fathom, utilizza modelli di intelligenza artificiale capaci di osservare lo schermo di un dispositivo, riconoscere elementi grafici e interagire con l’applicazione attraverso istruzioni espresse in linguaggio naturale. La tecnologia è stata concepita per superare alcune limitazioni delle tradizionali procedure di test automatizzato, che identificano pulsanti, campi e altri componenti tramite selettori e identificativi definiti nel codice. Quando un’interfaccia viene modificata, i test basati su tali riferimenti possono interrompersi anche se il funzionamento dell’applicazione rimane invariato, imponendo attività di manutenzione degli script.
Fathom affronta il problema analizzando ciò che compare sullo schermo e associando gli elementi visibili alle azioni da compiere. Se un pulsante testuale viene sostituito da un’icona con la stessa funzione, l’agente dovrebbe essere in grado di riconoscerne il significato e proseguire senza richiedere una modifica preventiva dello script. Lo stesso principio viene applicato agli elementi imprevisti, come finestre promozionali, richieste di autorizzazione e notifiche che compaiono durante un processo di acquisto o registrazione. La piattaforma punta quindi a verificare il risultato dell’operazione richiesta anziché imporre una sequenza rigidamente predeterminata di interazioni. Drizz dichiara di aver ridotto, nei propri test interni, l’instabilità delle procedure automatizzate da valori compresi tra il 15% e il 50% a circa il 3%, precisando però che i risultati cambiano in funzione dell’applicazione e del cliente.
La società ha sottoposto Fathom a una valutazione su Android utilizzando sei configurazioni di modelli avanzati e 20 attività distribuite in due ambienti sperimentali. Ogni combinazione tra modello e attività è stata eseguita cinque volte. Nel primo ambiente, basato su un’immagine Android standard e su attività meno complesse, sono state completate correttamente 217 delle 300 esecuzioni valutate, corrispondenti al 72,3%. Nel secondo ambiente, basato su un’immagine Android con privilegi root e su attività più difficili, sono risultate corrette 86 esecuzioni su 300, pari al 28,7%. La seconda configurazione permetteva inoltre di controllare direttamente lo stato del database dell’applicazione, anziché limitarsi a verificare il risultato visibile sullo schermo. I due valori non costituiscono quindi una comparazione diretta delle prestazioni, poiché sono stati ottenuti su attività e sistemi differenti.
Le valutazioni hanno mostrato forti variazioni tra modelli e ambienti. GPT-5.6 Luna ha ottenuto il 64% nel primo insieme di prove e il 4% nel secondo, mentre Gemini 3.5 Flash è passato dal 54% al 34%, risultando superiore alle configurazioni GPT nella seconda suite. Cinque delle dieci attività del test più difficile hanno prodotto risultati nulli con tutte e sei le configurazioni. Drizz ha dichiarato di averne verificato preventivamente il funzionamento sui dispositivi, ma non ha pubblicato un’analisi esaustiva che permetta di attribuire con certezza tali insuccessi alle capacità degli agenti. La prima immagine Android utilizzata è stata inoltre ritirata, impedendo la ripetizione delle medesime prove. I risultati rappresentano dunque una valutazione dell’intero sistema formato da modello, infrastruttura Fathom e ambiente Android, non una misura isolata delle capacità dei singoli modelli o delle prestazioni presso i clienti. Evidenziano soprattutto quanto la riuscita dei test visivi dipenda dalla complessità delle operazioni, dalla configurazione del dispositivo e dai criteri utilizzati per verificare il risultato.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI).