
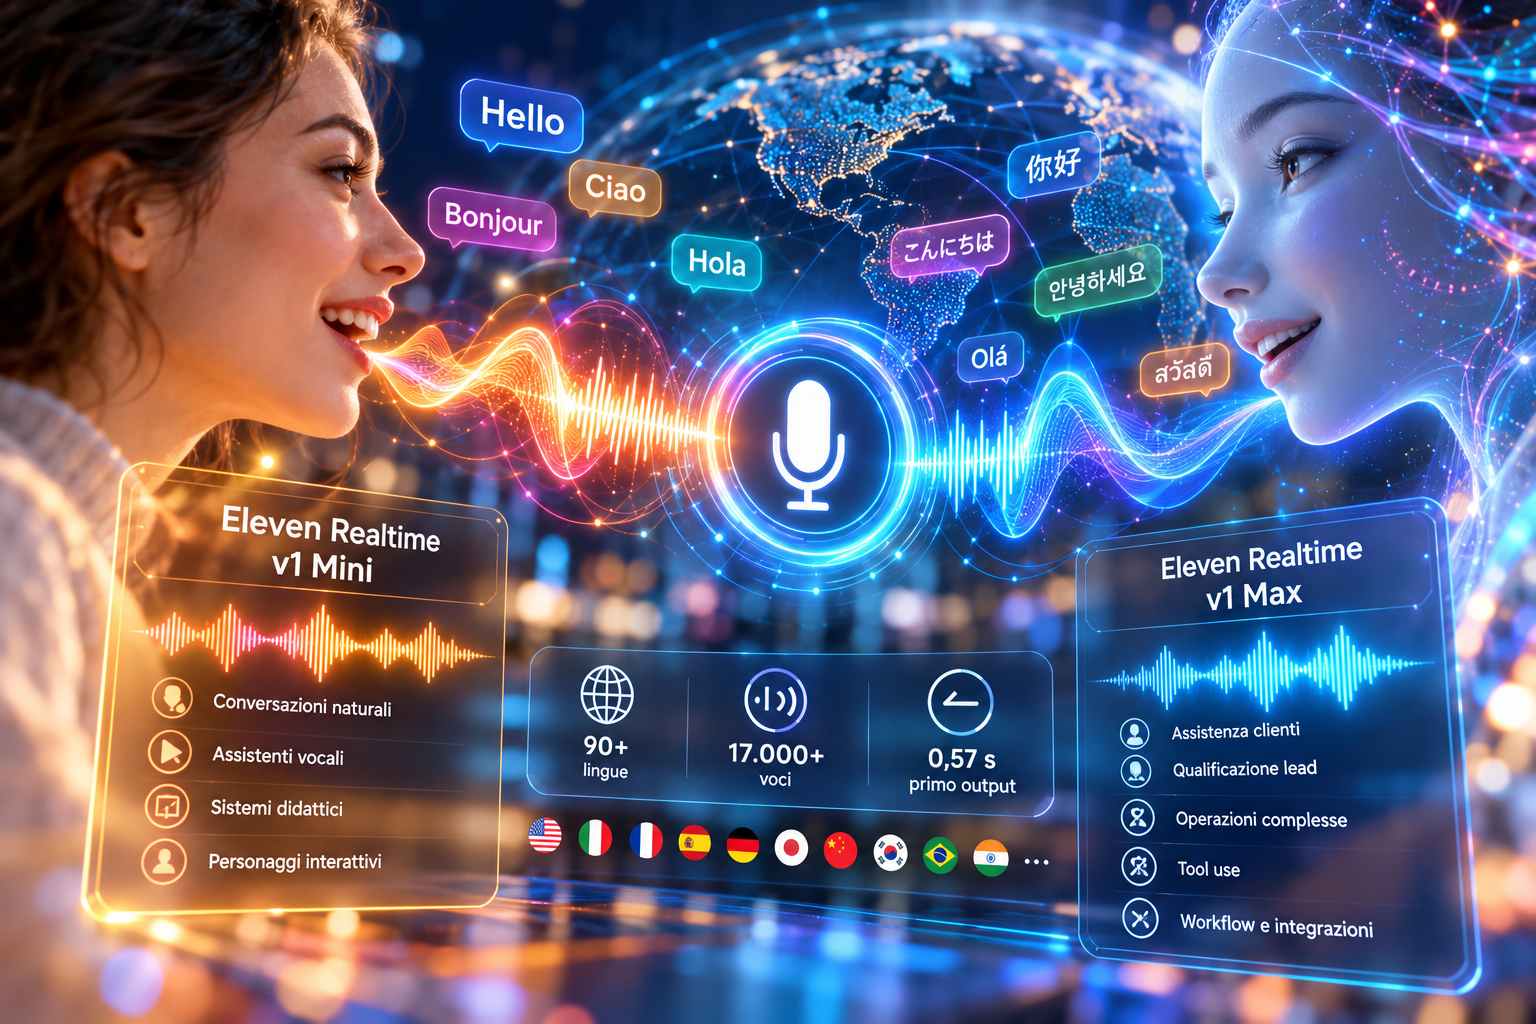
ElevenLabs ha presentato Eleven Realtime, una famiglia di modelli speech-to-speech progettata per realizzare agenti conversazionali capaci di ricevere, interpretare e generare parlato in tempo reale attraverso un sistema integrato. La prima versione comprende Eleven Realtime v1 Mini ed Eleven Realtime v1 Max, due varianti destinate ad applicazioni con differenti requisiti di costo, ragionamento e gestione delle operazioni. Mini è orientato ad assistenti vocali, sistemi didattici e personaggi interattivi nei quali la naturalezza della conversazione costituisce il requisito principale, mentre Max è destinato all’assistenza clienti, alla qualificazione dei potenziali acquirenti e ai processi che richiedono più passaggi e chiamate a strumenti software. Entrambi supportano oltre 90 lingue e possono utilizzare più di 17.000 voci presenti nella libreria ElevenLabs. L’architettura integra riconoscimento vocale, rilevamento dell’attività della voce, identificazione dei turni conversazionali e generazione del parlato, riducendo la necessità di configurare separatamente i componenti che compongono le tradizionali pipeline di elaborazione vocale.
Uno degli aspetti principali riguarda il coordinamento temporale della conversazione. Un agente vocale deve distinguere le pause momentanee dalla conclusione di un intervento, riconoscere quando l’interlocutore desidera interromperlo e decidere se rispondere, attendere oppure produrre un breve segnale di ascolto. Nei sistemi che concatenano riconoscimento automatico del parlato, modello linguistico e sintesi vocale, questi passaggi richiedono normalmente una gestione esplicita dei tempi e delle interruzioni. Eleven Realtime affronta tali operazioni attraverso un modello progettato per la conversazione, comprendendo anche fenomeni come i backchannel, ossia le brevi risposte che indicano ascolto senza prendere completamente il turno di parola. La distinzione tra Mini e Max emerge proprio nel differente equilibrio tra abilità conversazionali e capacità di eseguire compiti attraverso strumenti esterni.
Le valutazioni pubblicate da Artificial Analysis comprendono tre benchmark destinati a misurare ragionamento sul parlato, dinamica conversazionale e prestazioni complessive degli agenti. Su Big Bench Audio, che verifica la capacità di rispondere a domande presentate oralmente, Eleven Realtime v1 Max ha ottenuto il 98,8% di risposte corrette, rispetto al 75,9% di Mini. Il tempo medio necessario a produrre il primo output audio è risultato pari a 0,57 secondi per Max e 0,62 secondi per Mini. Questi dati indicano una differenza favorevole alla variante Max sia nella prova di ragionamento sia nella latenza iniziale misurata, senza rappresentare automaticamente il tempo totale necessario per completare un’interazione. Su Full-Duplex-Bench, dedicato alla gestione dei turni, delle pause, delle interruzioni e dei segnali conversazionali, Mini ha invece superato Max ottenendo il 95,8%, contro il 94,1% della variante maggiore. Le misurazioni mostrano quindi che il modello con le migliori prestazioni nel ragionamento non è necessariamente quello con il risultato più elevato nella gestione delle dinamiche dialogiche.
Speech Agent Arena utilizza conversazioni dal vivo valutate attraverso confronti ciechi, preferenze umane e capacità di completamento dei compiti. In questa valutazione Max ha raggiunto un punteggio di 998, mentre Mini ha ottenuto 988. Si tratta di punteggi della classifica e non di percentuali di accuratezza. La differenza risulta più pronunciata nelle attività che richiedono l’utilizzo di strumenti software: Max ha completato correttamente l’87,1% dei compiti di tool use, contro il 60,3% di Mini. ElevenLabs raccomanda quindi Max per applicazioni che devono interagire frequentemente con servizi esterni, eseguire procedure articolate o coordinare più operazioni, mentre Mini può essere impiegato quando il requisito principale è una conversazione fluida con minori esigenze di ragionamento operativo.
La distribuzione è stata progettata anche per semplificare la migrazione delle applicazioni già realizzate utilizzando la Realtime API di OpenAI. Eleven Realtime adotta specifiche compatibili con l’interfaccia OpenAI Realtime, consentendo agli sviluppatori di modificare endpoint e nome del modello senza riprogettare integralmente il codice delle integrazioni basate su WebSocket. La compatibilità comprende l’utilizzo degli SDK OpenAI, mentre le applicazioni che impiegano WebRTC devono essere adattate al trasporto WebSocket supportato da ElevenLabs. I modelli sono inoltre accessibili attraverso ElevenAgents, piattaforma dell’azienda dedicata alla creazione e distribuzione degli agenti vocali su telefono, web, WhatsApp e canali dei contact center. ElevenAgents comprende strumenti per costruire workflow, collegare basi di conoscenza, impostare guardrail, effettuare test e monitorare le prestazioni operative. La combinazione delle due varianti permette di selezionare il modello in funzione delle caratteristiche dell’applicazione, distinguendo la qualità delle interazioni vocali dalla capacità di completare procedure attraverso strumenti e servizi esterni.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)