
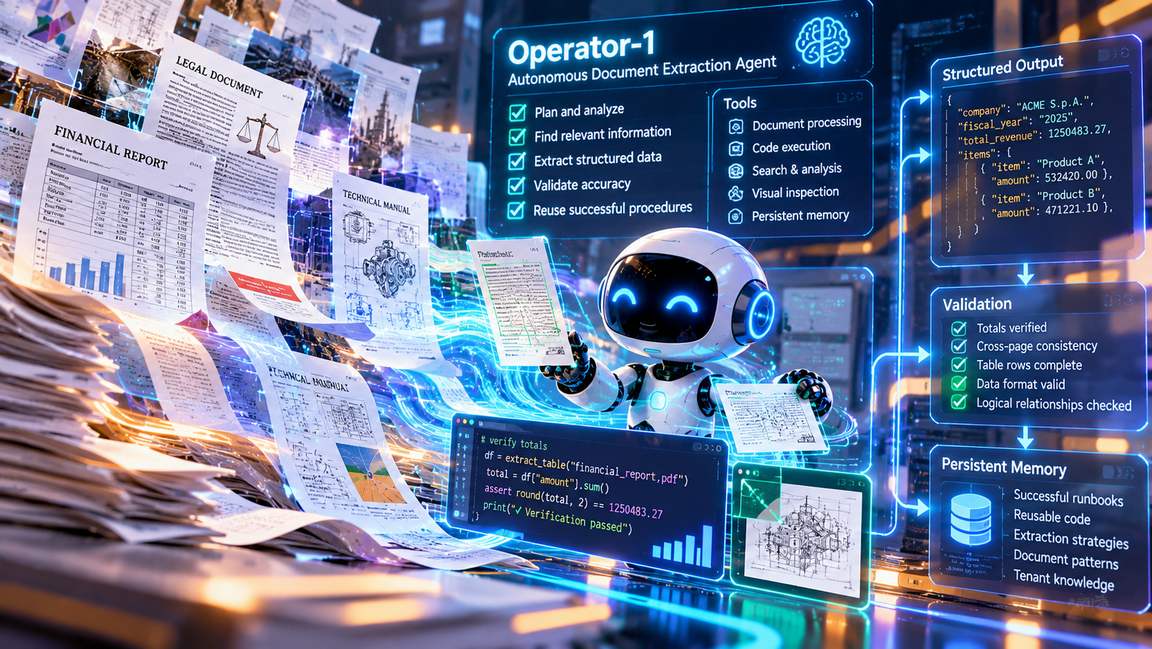
Extend ha annunciato Operator-1, un agente autonomo di intelligenza artificiale progettato per estrarre informazioni strutturate da documenti particolarmente complessi, verificare l’accuratezza dei risultati e riutilizzare le procedure che si sono dimostrate efficaci nelle elaborazioni precedenti. Il sistema combina strumenti dedicati all’elaborazione documentale, capacità di esecuzione del codice e una memoria persistente all’interno di un ambiente operativo specializzato, superando l’impostazione tradizionale basata sulla suddivisione dei documenti in segmenti e su un singolo passaggio di inferenza del modello linguistico. Questa architettura consente all’agente di pianificare autonomamente le operazioni necessarie per completare un’attività di estrazione, individuare le informazioni rilevanti, elaborarle secondo la struttura richiesta e controllare la coerenza dei dati prima della restituzione. Operator-1 è rivolto soprattutto ai processi documentali nei quali la complessità del formato, la lunghezza dei contenuti e la necessità di mantenere relazioni precise tra informazioni distribuite su più pagine rendono insufficienti le tecniche convenzionali di riconoscimento ed estrazione automatica.
Uno dei problemi affrontati riguarda l’elaborazione di documenti finanziari contenenti tabelle molto estese, nei quali i sistemi che procedono per segmentazione possono omettere alcune righe, duplicarne altre oppure perdere la continuità logica fra elementi appartenenti alla stessa struttura. Difficoltà analoghe interessano i documenti legali composti da migliaia di pagine, nei quali informazioni reciprocamente collegate possono trovarsi in sezioni molto distanti, oppure i documenti tecnici che integrano diagrammi complessi, annotazioni e contenuti testuali di dimensioni ridotte. Operator-1 utilizza strumenti di ricerca da riga di comando e funzionalità di interrogazione personalizzate per individuare e collegare informazioni distribuite anche su migliaia di pagine, mentre le capacità di ritaglio e ingrandimento delle immagini permettono di esaminare regioni specifiche del documento, verificare i contenuti in corrispondenza delle interruzioni di pagina e interpretare dettagli grafici in relazione al testo circostante. L’agente può inoltre scrivere ed eseguire codice per ricostruire righe tabellari, trasformare i dati estratti e verificare operazioni matematiche, ad esempio confrontando la somma delle singole voci contabili con il totale riportato in un prospetto finanziario. Il controllo non si limita quindi alla plausibilità linguistica del risultato, ma può comprendere verifiche computazionali direttamente collegate ai vincoli del documento.
L’architettura prevede anche un meccanismo di validazione iterativa attraverso il quale Operator-1 confronta i risultati prodotti con i requisiti dell’attività assegnata e avvia ulteriori tentativi quando una verifica non viene superata. Un componente particolarmente rilevante è la memoria persistente specifica per ciascun ambiente cliente, nella quale vengono conservati codice, strategie operative e procedure documentate, o runbook, che hanno consentito di completare correttamente elaborazioni precedenti. Quando l’agente incontra successivamente documenti della stessa tipologia, può recuperare queste informazioni e adattare le procedure già sperimentate, evitando di ripetere integralmente attività di analisi e sviluppo. La conservazione delle strategie a livello di tenant permette di costruire una conoscenza operativa associata ai flussi documentali di ciascuna organizzazione, con la possibilità di ridurre progressivamente le operazioni ridondanti e, potenzialmente, i costi di esecuzione. L’effettivo risparmio dipende comunque dalle caratteristiche dei documenti e dalla frequenza con cui possono essere riutilizzate le procedure memorizzate.
Extend ha accompagnato il lancio con i risultati ottenuti su tre benchmark dedicati all’estrazione documentale. Operator-1 ha raggiunto un’accuratezza del 99,3% su LongArray-Extract, benchmark open source sviluppato dalla stessa Extend per misurare la completezza e la precisione nell’estrazione di array molto lunghi da documenti reali. Su LongExtractionBench, benchmark di micro1 commissionato da Reducto e dedicato al popolamento di schemi JSON a partire da documenti estesi, il sistema ha ottenuto il 99,88%. Il terzo risultato riguarda ExtractBench di LlamaIndex, progettato per valutare l’estrazione strutturata da documenti aziendali, sul quale Operator-1 ha raggiunto il 96,57%. Secondo Extend, questi punteggi costituiscono nuovi risultati di riferimento nelle rispettive valutazioni e indicano prestazioni prossime alla saturazione su tre differenti prove di estrazione. I benchmark utilizzano tuttavia dataset e metodologie di misurazione distinti, mentre due delle tre valutazioni sono state pubblicate da soggetti terzi. Le prestazioni comunicate descrivono quindi il comportamento del sistema nei rispettivi contesti sperimentali e non equivalgono a una garanzia di accuratezza identica su qualsiasi tipologia documentale. L’elemento tecnico distintivo di Operator-1 rimane l’integrazione, in un unico processo autonomo, di ricerca, ispezione visiva, programmazione, validazione e memoria operativa, con l’obiettivo di trasformare l’estrazione documentale da una singola operazione di inferenza in una sequenza verificabile di attività coordinate.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)