
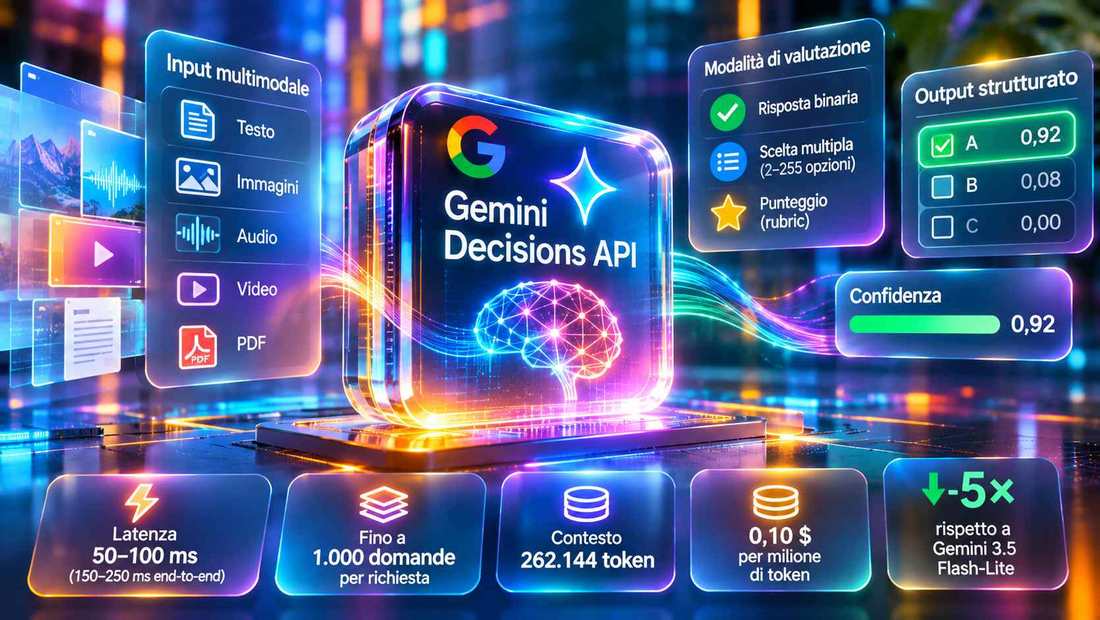
Google ha presentato Gemini Decisions API, una nuova interfaccia per l’esecuzione di valutazioni strutturate mediante intelligenza artificiale, basata sul modello Gemini Decision 1 e disponibile attraverso Gemini API in Google AI Studio. La soluzione permette di sottoporre fino a mille domande indipendenti all’interno di una singola richiesta, utilizzando un contesto condiviso composto da testo, immagini, registrazioni audio, video e documenti PDF. A differenza dei modelli linguistici generativi tradizionali, progettati per produrre risposte discorsive, Gemini Decision 1 è specializzato nell’attribuzione di punteggi alle opzioni disponibili e nella restituzione di decisioni direttamente utilizzabili dalle applicazioni. Il modello valuta le alternative attraverso un singolo passaggio di elaborazione, evitando di generare progressivamente un testo che dovrebbe essere successivamente interpretato e convertito in informazioni strutturate. Questa architettura è destinata soprattutto a processi quali selezione degli strumenti, instradamento verso modelli differenti, classificazione delle richieste, verifica delle politiche aziendali, valutazione del contesto e ordinamento dei risultati.
L’interfaccia supporta una finestra contestuale di 262.144 token, che comprende sia il contenuto condiviso sia le istruzioni associate alle domande. Sono disponibili tre modalità di valutazione: risposte binarie, selezione tra alternative predefinite e attribuzione di punteggi secondo una scala ordinata. Le domande a scelta multipla possono comprendere da due a 255 opzioni, mentre le valutazioni mediante rubric restituiscono una media ponderata delle probabilità associate ai diversi livelli. Ogni risposta è accompagnata da un valore di confidenza compreso tra zero e uno, interpretato come probabilità stimata di correttezza della risposta principale. Gli sviluppatori possono utilizzare questo dato per automatizzare le decisioni più affidabili e indirizzare quelle incerte verso ulteriori controlli, ma Google raccomanda di calibrare le soglie attraverso esempi etichettati rappresentativi dei propri dati e di mantenere una verifica umana nei processi sensibili, compresi quelli che autorizzano pagamenti. Le domande presenti in una richiesta non condividono informazioni tra loro: l’aggiunta o la rimozione di un quesito non modifica le altre risposte e le valutazioni dipendenti devono quindi essere coordinate dalla logica dell’applicazione mediante interrogazioni successive oppure selezione dei risultati pertinenti.
Google dichiara una latenza mediana di calcolo del modello compresa tra 50 e 100 millisecondi e una latenza complessiva di 150-250 millisecondi su input multimodali con contesti fino a 16.000 token. Nei test comunicati, il tempo di risposta rimane sostanzialmente stabile passando da una a cento domande nella stessa richiesta. Il prezzo è fissato a 0,10 dollari per milione di token in ingresso, senza addebito di token in uscita; il contesto condiviso viene conteggiato una sola volta, mentre ciascuna domanda aggiunge i propri token di istruzioni. Non sono previsti costi variabili per il ragionamento o tariffe separate per trascrizione audio e riconoscimento ottico dei documenti. Google indica un costo quasi cinque volte inferiore rispetto all’utilizzo di Gemini 3.5 Flash-Lite tramite Interactions API nella propria suite di valutazione. Tra gli impieghi interni figura Gemini Notebook, che utilizza la nuova interfaccia per selezionare livelli di modello e profondità di ragionamento, con una riduzione dichiarata della latenza fino al 40% per le richieste quotidiane. Altri utilizzi comprendono Stitch e il sistema CC di Google Labs per la selezione tra oltre 200 reazioni emoji. Gli sviluppatori possono accedere al servizio mediante Python, JavaScript e REST, utilizzando google-genai dalla versione 3.2. Sono previste integrazioni con OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit e OpenCode. La disponibilità iniziale riguarda Gemini Developer API v1beta, mentre il supporto su Google Cloud è annunciato per una fase successiva. Non sono ancora disponibili caching del contesto, Batch API, modalità Flex o Priority, cronologia conversazionale e blocchi di chiamata agli strumenti; le istruzioni delle domande devono inoltre essere esclusivamente testuali.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)