
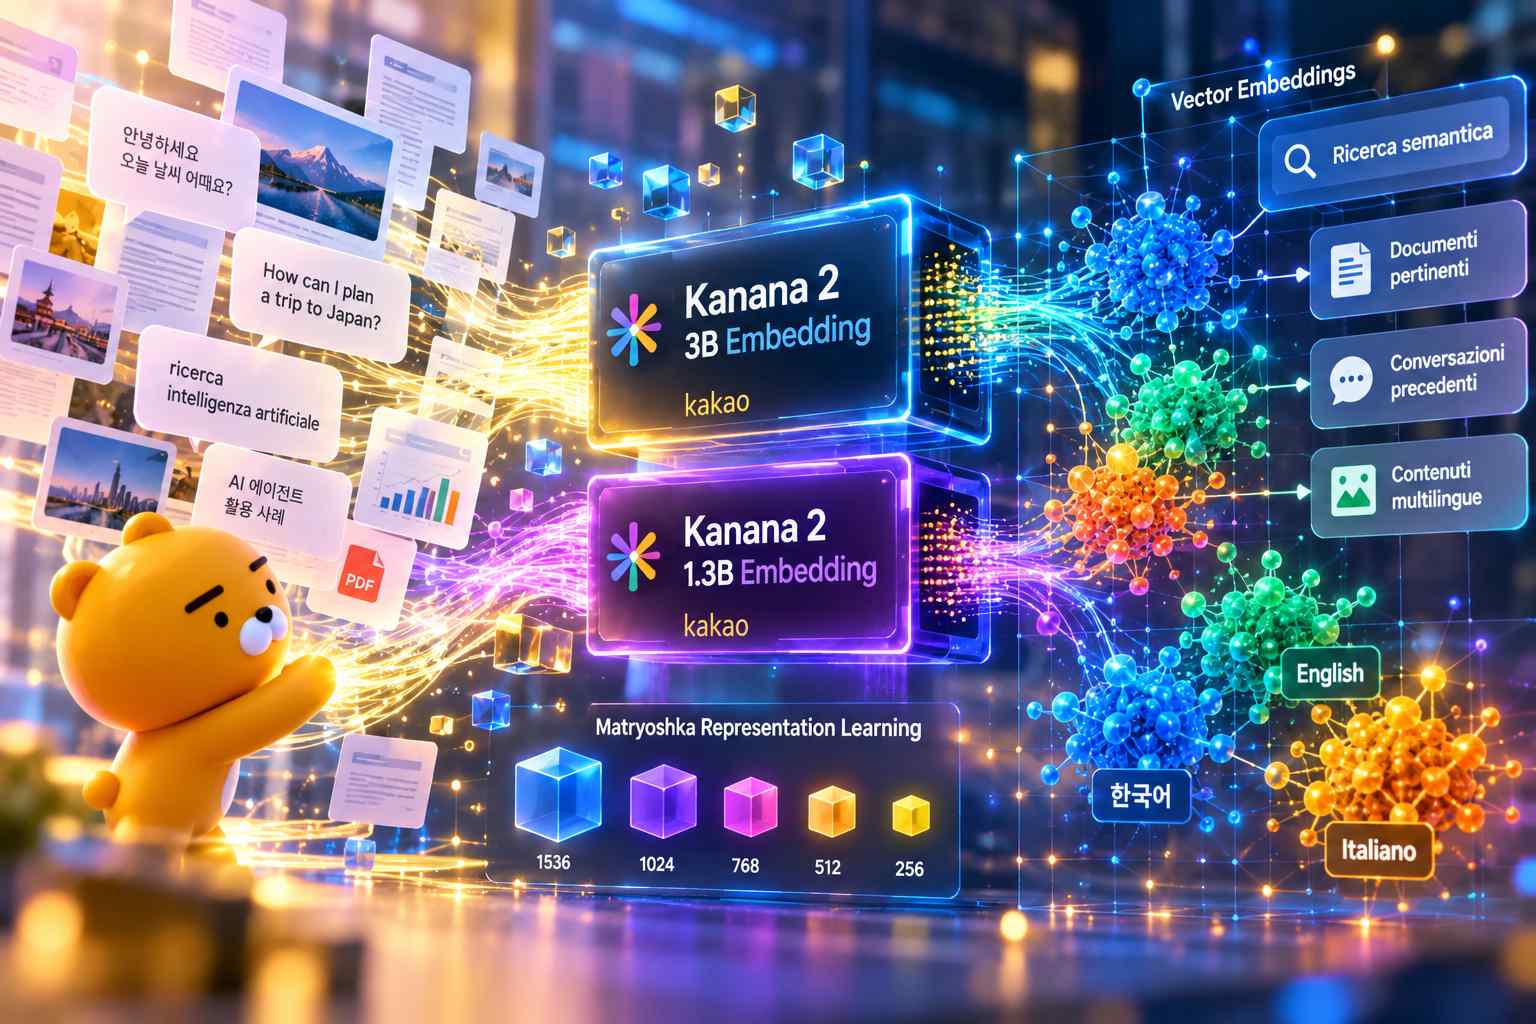
Kakao ha reso disponibili su Hugging Face due modelli di embedding appartenenti alla famiglia Kanana 2, sviluppati per supportare sistemi di ricerca semantica e agenti di intelligenza artificiale personalizzati. Le nuove versioni sono Kanana-2-3B-Embedding, con 3 miliardi di parametri, e Kanana-2-1.3B-Embedding, con 1,3 miliardi di parametri. Entrambi i modelli trasformano le informazioni testuali in rappresentazioni vettoriali numeriche, consentendo di confrontare il significato di domande, documenti e contenuti indipendentemente dalla presenza delle stesse parole. Questa funzionalità è particolarmente rilevante per gli agenti che devono recuperare informazioni da conversazioni precedenti, individuare elementi pertinenti all’interno di archivi e utilizzare il contesto personale dell’utente per formulare risposte coerenti. A differenza dei modelli generativi, gli embedding non hanno come funzione principale la produzione di testo, ma la rappresentazione semantica delle informazioni per attività di ricerca, classificazione e recupero.
Il modello da 3 miliardi di parametri è stato sviluppato attraverso un addestramento specializzato di Kanana-2-SLM, il modello linguistico compatto di Kakao, adattato alle attività di recupero delle informazioni. La versione da 1,3 miliardi è stata invece realizzata applicando tecniche di distillazione della conoscenza, per trasferire le capacità del modello più grande a una struttura con minori requisiti computazionali. Questa differenziazione permette agli sviluppatori di selezionare un modello più esteso quando è necessario privilegiare la capacità di rappresentazione oppure una versione più compatta quando assumono maggiore importanza l’efficienza e il consumo delle risorse.
Secondo le valutazioni comparative comunicate da Kakao, entrambi i modelli hanno ottenuto i risultati più elevati nelle prove in lingua coreana rispetto a NVIDIA Llama Nemotron Embed 1B v2 e Alibaba Qwen3 Embedding 4B, mantenendo prestazioni in inglese di livello comparabile. L’azienda dichiara inoltre un’efficienza di inferenza superiore rispetto a Qwen3 Embedding e miglioramenti dell’ordine di diverse decine di volte nella velocità di elaborazione e nell’utilizzo della memoria rispetto alle precedenti soluzioni di embedding sviluppate internamente. I risultati si riferiscono alle valutazioni effettuate dall’azienda e non indicano necessariamente un vantaggio uniforme in tutti i contesti applicativi e linguistici.
I modelli utilizzano la tecnica Matryoshka Representation Learning, che permette di selezionare differenti dimensioni dei vettori di embedding in base alle esigenze del servizio. Gli sviluppatori possono quindi adattare la rappresentazione semantica allo spazio di archiviazione disponibile e alle caratteristiche delle operazioni di ricerca, evitando di utilizzare necessariamente la massima dimensionalità prevista. Le due versioni vengono distribuite attraverso Kanana Open License, che consente anche impieghi commerciali secondo le relative condizioni. Kakao punta a favorire l’integrazione della ricerca semantica in applicazioni personalizzate, sistemi di memoria per agenti AI e servizi che richiedono il recupero efficiente di informazioni in lingua coreana, mantenendo al contempo capacità multilingue.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)