
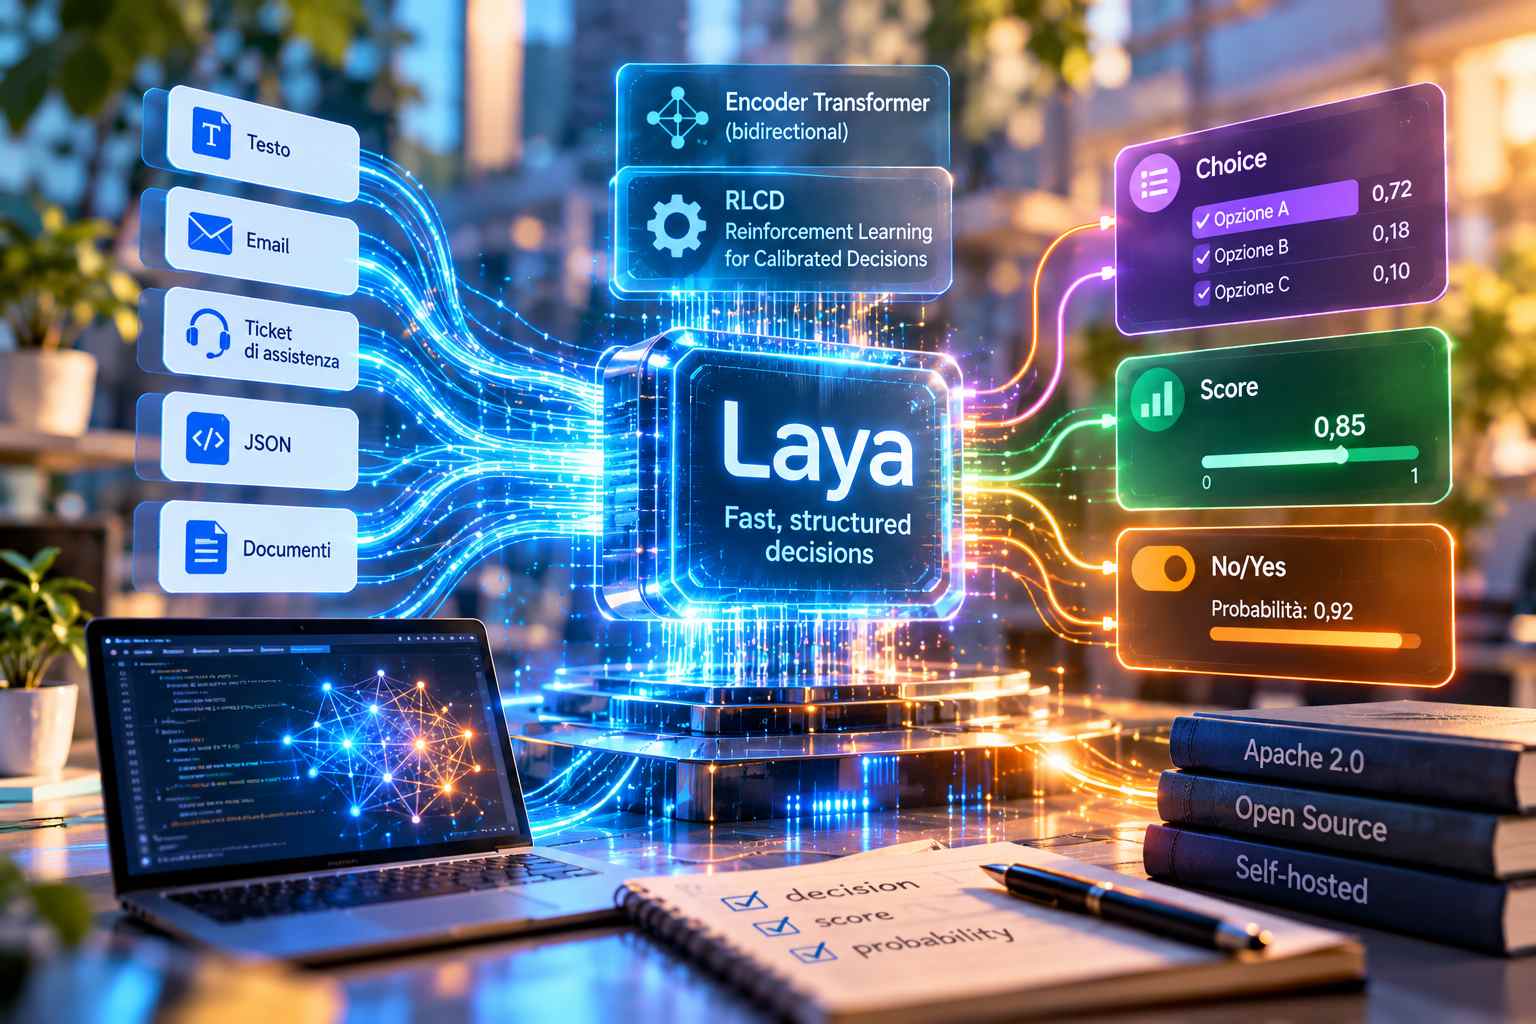
Laya è un modello open source sviluppato da Nandakishor M, fondatore della società indiana ConvAI Innovations, con l’obiettivo di eseguire decisioni rapide e strutturate senza ricorrere ogni volta a un grande modello linguistico generativo. Il lavoro alla base del progetto era iniziato già tra marzo e aprile 2025, quindi molti mesi prima della presentazione pubblica di Jev da parte di TypeSafe AI nel settembre 2026, partendo da una ricerca dedicata alla possibilità di riconoscere l’incertezza e le allucinazioni di un modello prima che questo completasse la generazione della risposta. Nandakishor aveva inizialmente lavorato su un approccio di Confidence Aware Routing basato su contrastive learning, studiando le rappresentazioni interne dei modelli per capire se fosse possibile determinare in anticipo quando un sistema disponesse effettivamente delle informazioni necessarie per rispondere. Da questa linea di ricerca è poi nato Laya, che abbandona completamente la generazione token per token e utilizza invece un encoder transformer bidirezionale con appositi livelli decisionali per restituire direttamente una scelta, un punteggio o una probabilità. Il progetto è distribuito con licenza Apache 2.0, comprende pesi scaricabili e può essere eseguito autonomamente senza inviare i dati a un servizio cloud esterno; proprio questa caratteristica lo differenzia da Jev, che viene fornito attraverso un’API ospitata da TypeSafe. Laya ha rapidamente attirato l’attenzione della comunità open source, arrivando ai primi posti fra i modelli in tendenza su Hugging Face e ottenendo migliaia di apprezzamenti sulla piattaforma, mentre il fondatore ha dichiarato di voler mantenere il progetto aperto affinché altri sviluppatori possano modificarlo, specializzarlo e costruirvi sopra nuovi sistemi decisionali.
Dal punto di vista tecnico, Laya appartiene alla stessa categoria di modelli che Jev definisce “System One”: sistemi che non devono elaborare una lunga risposta ma prendere una decisione rapida a partire da uno stato e da una serie di domande strutturate. I checkpoint attuali utilizzano encoder bidirezionali e non modelli autoregressivi. La versione inglese è basata su ModernBERT-large e conta complessivamente 421 milioni di parametri, mentre il checkpoint multilingual utilizza mmBERT-base, arriva a 322 milioni di parametri e supporta oltre 100 lingue; esiste inoltre una versione specificamente ottimizzata per i benchmark di typed decisions. L’input può essere costituito da testo, email, ticket di assistenza o documenti JSON e il modello risponde attraverso tre primitive principali: choice, che seleziona una delle alternative disponibili e assegna una probabilità a ciascuna; score, che produce un valore lungo una scala ordinata insieme alla relativa distribuzione; e noul, utilizzata per rispondere a domande binarie attraverso una probabilità compresa tra zero e uno. Tutte le domande possono essere elaborate in un singolo forward pass, evitando la generazione progressiva di token e la successiva necessità di interpretare una risposta testuale. Nel checkpoint principale ogni opzione viene associata a uno specifico marker all’interno dell’input, sul quale viene calcolato uno score, e un softmax trasforma successivamente questi valori in probabilità. Il modello principale dispone normalmente di una finestra di 512 token per ciascuna domanda, mentre le versioni multilingual e typed-decisions arrivano a 1.024 token e possono essere estese fino a circa 8.192 token in determinate configurazioni.
L’elemento centrale dell’addestramento è il sistema RLCD, Reinforcement Learning for Calibrated Decisions, progettato per fare in modo che la probabilità dichiarata dal modello corrisponda il più possibile alla probabilità effettiva che la decisione sia corretta. Il modello non viene quindi premiato soltanto quando sceglie l’opzione giusta, ma anche in funzione della qualità della confidenza che assegna alla propria risposta. Se, per esempio, classifica un’email come phishing con il 90% di probabilità e la classificazione risulta errata, la penalizzazione tiene conto anche dell’eccessiva sicurezza mostrata dal sistema. L’implementazione utilizza strictly proper scoring rules, comprese log score, spherical score e, per le scale ordinali, ranked probability score, in modo che il modo matematicamente più conveniente per massimizzare la ricompensa sia produrre probabilità il più possibile fedeli all’incertezza reale del modello. Nel training vengono inoltre aggiunte perturbazioni ai logits per favorire l’esplorazione e gli aggiornamenti utilizzano un meccanismo REINFORCE con baseline di gruppo, mentre le conversazioni multi-turn vengono gestite attraverso temporal difference learning sui diversi prefissi della sequenza. Questa architettura è pensata soprattutto per decisioni che possono essere automatizzate in base alla confidenza: un’applicazione può, per esempio, eseguire automaticamente un’azione quando Laya supera una certa soglia di probabilità e inoltrare invece il caso a un operatore umano quando il modello manifesta maggiore incertezza.
Le applicazioni previste riguardano soprattutto tutti quei compiti nei quali un LLM tradizionale sarebbe eccessivo perché il risultato finale consiste semplicemente in una classificazione o in un instradamento. Laya può essere utilizzato per rilevare phishing e spam, individuare prompt injection, moderare contenuti, classificare richieste di assistenza, decidere verso quale reparto inoltrare un ticket o stabilire quale modello AI debba occuparsi di una determinata richiesta. In un sistema composto da più modelli, per esempio, Laya può analizzare il prompt dell’utente e decidere se inviarlo a un piccolo modello economico oppure a un modello frontier più costoso; allo stesso modo, una richiesta di rimborso può essere riconosciuta e instradata direttamente verso il relativo workflow senza chiamare un LLM general purpose soltanto per identificare l’intento. La documentazione include già preset per model routing, email triage, guardrail in tempo reale e decisioni applicative, mentre un caso di specializzazione descritto dal progetto utilizza Laya come motore decisionale per un browser agent: dopo un fine-tuning specifico, la capacità di scegliere l’elemento corretto fra circa 45 possibili target è passata da un top-1 del 10% in modalità zero-shot al 66%, mentre il successo sui task reali è salito dallo 0 al 62%, con tempi di decisione tra 17 e 23 millisecondi per passaggio. Il modello è quindi pensato meno come sostituto universale di un LLM e più come base da specializzare per moltissime micro-decisioni ripetitive all’interno di agenti e applicazioni software.
La velocità è uno dei principali argomenti del progetto. Sui benchmark pubblicati dagli sviluppatori e misurati con una GPU Tesla T4, il checkpoint multilingual completa una singola domanda in circa 32,8 millisecondi e quello principale in circa 39,5 millisecondi; elaborando dieci domande contemporaneamente, la versione multilingual scende a circa 7,2 millisecondi per domanda, mentre su batch da cinquanta richieste arriva a circa 6,8 millisecondi per domanda. Il team confronta questi valori con misurazioni esterne di Jev comprese nell’ordine di alcune centinaia di millisecondi per richiesta e indica un vantaggio nell’ordine di sei-sette volte sulla singola domanda, anche se il confronto non è perfettamente omogeneo perché Jev viene interrogato attraverso una rete e Laya può essere eseguito direttamente sulla macchina locale. Nell’articolo viene riportato un intervallo di circa 30-35 millisecondi e un vantaggio stimato di sei-otto volte rispetto a Jev. Nel benchmark comunitario LocalLLaMA typed-decisions, condotto su circa 2.000 decisioni strutturate, Laya ha ottenuto un punteggio dichiarato di 0,766 contro 0,727 per Jev 1.13.0; si tratta però di un benchmark specifico e i risultati non implicano che Laya sia superiore in qualsiasi workload, tanto che la documentazione stessa del progetto raccomanda di considerarlo soprattutto come base da fine-tunare su compiti specifici e non come motore zero-shot universale.
Uno dei vantaggi più concreti rispetto a un servizio esclusivamente cloud è la possibilità di eseguire Laya interamente all’interno dell’infrastruttura dell’utente. I checkpoint possono funzionare su GPU, CPU e attraverso runtime differenti, e la comunità ha già realizzato implementazioni per Apple Silicon, Node.js e TypeScript tramite ONNX Runtime. Quest’ultima versione permette di utilizzare il modello senza PyTorch e senza un runtime Python in produzione, mantenendo un formato di richiesta e risposta compatibile con quello della reference implementation e molto simile all’API System One utilizzata da Jev. Il fatto che i dati rimangano sul dispositivo permette di costruire quella che Nandakishor definisce un’architettura “zero-egress”, nella quale email, ticket, documenti aziendali e altri input sensibili non devono lasciare la rete locale soltanto per ottenere una decisione. Questo apre l’impiego anche a dispositivi edge, laptop, sistemi embedded e infrastrutture nelle quali latenza, riservatezza o assenza di connettività rendono meno adatto un endpoint remoto. Le dimensioni attuali sono comunque molto maggiori del “circa un milione di parametri” indicato nel testo della notizia: i checkpoint ufficiali pubblicati da ConvAI Innovations hanno 421 milioni e 322 milioni di parametri, pur rimanendo nettamente più piccoli dei grandi modelli generativi da diversi miliardi o decine di miliardi di parametri.
L’utilizzo locale incide anche sul modello economico. Jev applica una tariffazione per token attraverso la propria API, mentre Laya può essere scaricato e ospitato direttamente senza una tariffa per singola richiesta, lasciando naturalmente all’utilizzatore i costi dell’hardware e dell’infrastruttura. Nandakishor ritiene che questo tipo di decision model possa ridurre significativamente la quantità di chiamate ai grandi modelli linguistici, soprattutto nelle applicazioni agentiche dove gran parte delle operazioni consiste in routing, controlli, classificazioni o valutazioni semplici. Nell’esempio fornito dal fondatore, un’organizzazione che spende circa 5.000 dollari al mese in API LLM potrebbe, in determinate condizioni, ridurre la cifra nell’ordine di 1.000-2.000 dollari affidando a un piccolo modello decisionale le richieste che non necessitano realmente di generazione; non si tratta tuttavia di un risparmio garantito, perché il risultato dipende dalla quota di workload che può essere spostata dal modello più grande senza compromettere la qualità. La logica diventa particolarmente rilevante per gli agenti, che possono compiere decine o centinaia di micro-decisioni durante uno stesso task: chiamare un modello generativo per ognuna di esse significa pagare ripetutamente inferenza e latenza anche quando la risposta richiesta è soltanto “sì”, “no”, “strumento A” oppure “strumento B”.
Lo sviluppo di Laya prosegue inoltre con una versione denominata Laya Max e con ulteriori lavori sul calcolo edge. ConvAI Innovations sta collaborando con ricercatori e partner esterni, ma Nandakishor non intende al momento raccogliere capitali specificamente per trasformare Laya in un modello chiuso, preferendo mantenere aperta la ricerca e lasciare alle aziende la possibilità di costruire prodotti commerciali sopra la tecnologia. Il percorso del progetto deriva anche da un background differente da quello tipico di molti fondatori di startup AI: Nandakishor ha studiato ingegneria elettrica al Government Engineering College di Kannur, nel Kerala, e durante gli studi ha partecipato a hackathon e conferenze tecnologiche e depositato già al secondo anno un brevetto provvisorio relativo a un pannello solare ibrido teorico basato sul grafene. La direzione sulla quale sta concentrando ora la ricerca è quella di sistemi sempre più piccoli capaci di prendere decisioni direttamente sui dispositivi, riducendo la dipendenza da grandi data center e dall’infrastruttura richiesta dai modelli generativi. Laya viene quindi sviluppato non come concorrente general purpose degli LLM, ma come livello decisionale aperto, veloce e specializzabile da inserire accanto a questi ultimi nei workflow nei quali generare testo rappresenta una parte minima del lavoro effettivamente necessario.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)