
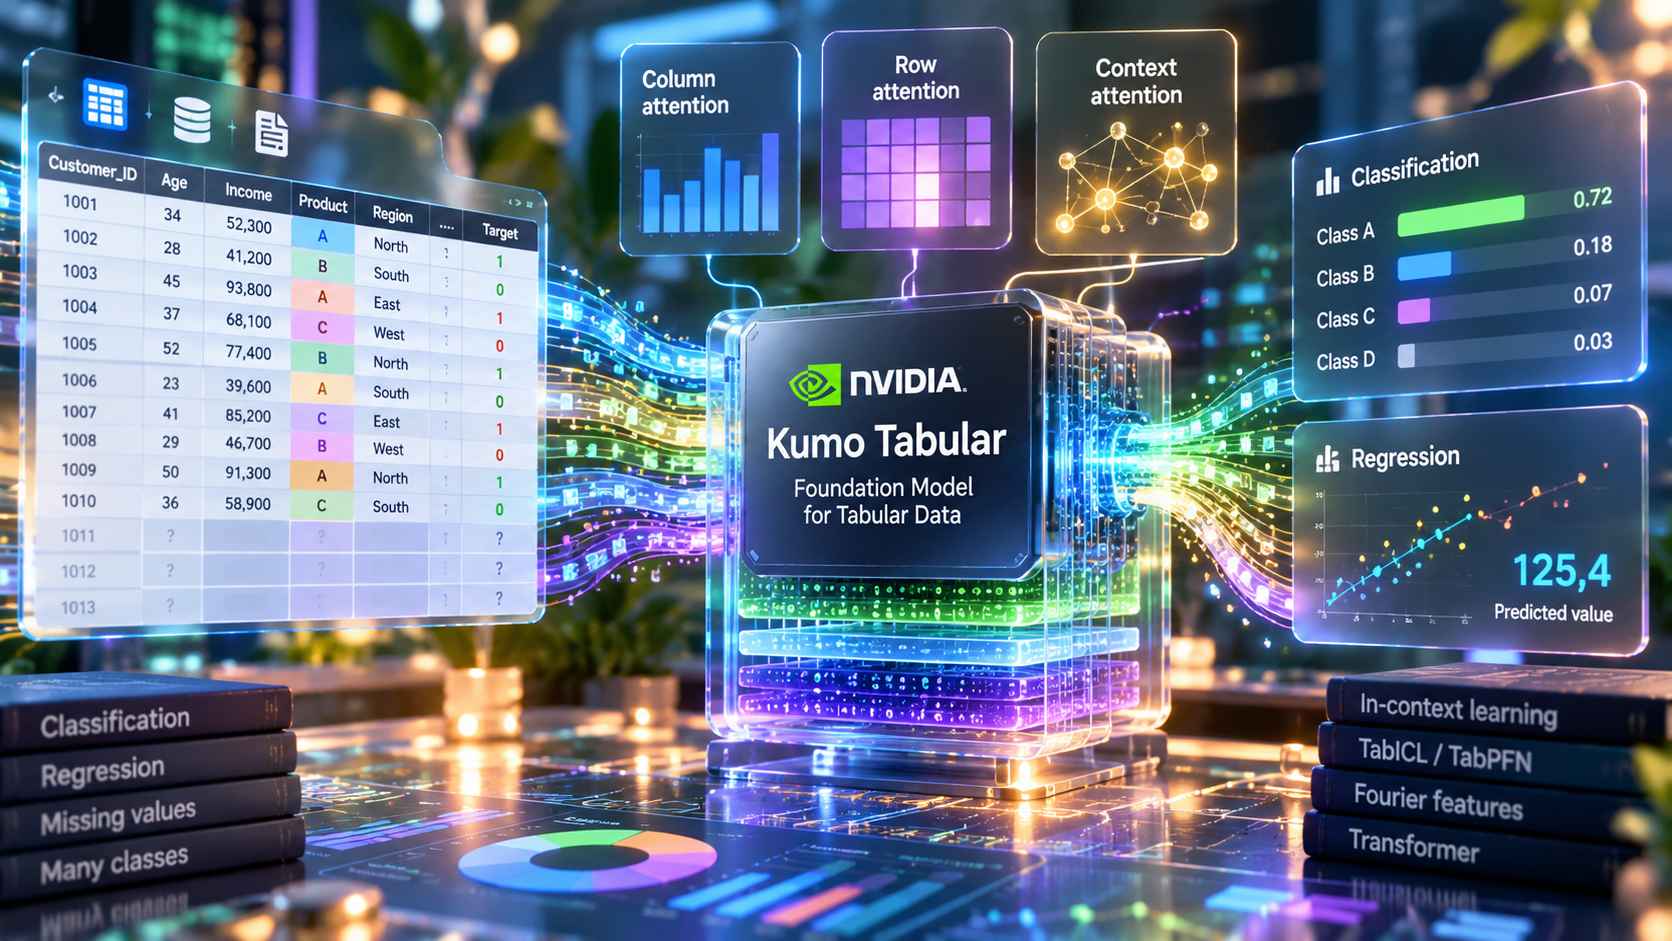
NVIDIA ha rilasciato Kumo Tabular, un foundation model aperto progettato specificamente per la previsione su dati tabellari e capace di gestire sia problemi di classificazione sia attività di regressione. Il modello riceve una tabella contenente righe già etichettate e utilizza queste informazioni come contesto per prevedere direttamente le etichette o i valori associati a nuove righe attraverso un singolo forward pass, senza richiedere un nuovo ciclo di addestramento, tuning degli iperparametri o feature engineering per ogni problema. Kumo Tabular fa parte della raccolta NVIDIA Kumo Structured ed è stato preaddestrato esclusivamente su dati artificiali; viene distribuito in tre dimensioni, Small, Medium e Large, con configurazioni comprese tra 28 e 215 milioni di parametri. I pesi sono disponibili tramite Hugging Face con licenza OpenMDW 1.1, che consente anche l’impiego commerciale, mentre l’esecuzione avviene attraverso la libreria open source structured-data-models sviluppata da NVIDIA, incaricata anche di scaricare automaticamente i pesi al primo utilizzo e di gestire preprocessing, ensemble e classificazione con numerose classi.
L’approccio nasce dalla volontà di trasferire ai dati tabellari il principio dell’in-context learning già utilizzato nei grandi modelli linguistici. Nei sistemi tradizionali, problemi aziendali come la previsione dell’abbandono di un cliente, del rischio di insolvenza, della domanda o del prezzo vengono normalmente affrontati costruendo modelli specifici, spesso basati su gradient-boosted trees. Ogni nuova attività richiede quindi la raccolta e l’etichettatura dei dati, la progettazione delle feature, la ricerca degli iperparametri, la validazione e infine il deployment di un modello dedicato. Kumo Tabular utilizza invece un modello già preaddestrato su milioni di tabelle differenti: le righe etichettate fornite al momento dell’inferenza costituiscono il contesto da cui il sistema ricava la struttura del problema e le relazioni tra variabili e target, mentre le nuove righe vengono elaborate direttamente per produrre probabilità di classe oppure valori numerici.
Dal punto di vista architetturale Kumo Tabular è un Transformer costruito attorno alla struttura delle tabelle e combina tre forme di attenzione dedicate rispettivamente alle colonne, alle righe e alla relazione tra esempi di contesto ed esempi da prevedere, riprendendo meccanismi già introdotti da sistemi come TabICL e TabPFN. La prima fase è quella di cell embedding, nella quale gruppi di celle vengono trasformati in token. I valori numerici e quelli categorici vengono rappresentati mediante Fourier features, basate su seni e coseni di frequenze apprese dal modello, utilizzando pesi distinti per le due categorie di dati. I valori mancanti vengono invece trattati esplicitamente dall’architettura e non devono essere preventivamente sostituiti attraverso procedure di imputazione. Ai token appartenenti alle righe utilizzate come contesto viene inoltre aggiunto un embedding che rappresenta l’etichetta conosciuta.
Successivamente ogni riga viene compressa in una propria rappresentazione attraverso l’alternanza di column attention e row attention. La column attention analizza i valori lungo una stessa colonna, permettendo al modello di capire il significato relativo di un dato rispetto alla distribuzione della variabile a cui appartiene, mentre la row attention mette in relazione le differenti caratteristiche presenti all’interno della stessa riga per apprenderne le interazioni. La column attention utilizza un meccanismo di induced self-attention il cui costo cresce linearmente con il numero di righe, mentre la row attention impiega rotary positions per distinguere la posizione delle diverse colonne. A ogni riga vengono inoltre associati quattro token CLS apprendibili che funzionano da rappresentazione finale della riga stessa. Una volta completata questa compressione, il costo computazionale della fase successiva non dipende più direttamente dal numero originale di colonne presenti nella tabella.
Un Transformer finale opera quindi sugli embedding delle righe. Le righe di contesto possono prestare attenzione tra loro, mentre le query, cioè le righe di cui deve essere determinata l’uscita, possono prestare attenzione soltanto alle righe di contesto. In questo modo ciascuna previsione dipende dai dati utilizzati come esempio e dalla singola riga da classificare o stimare, senza essere influenzata dalle altre query elaborate contemporaneamente. Poiché il contesto non dipende dalle query, le chiavi e i valori associati alle righe note possono essere calcolati una sola volta e riutilizzati per successive inferenze. Per le righe di query viene utilizzato anche un meccanismo denominato Test-GQA, progettato per ridurre la dimensione della cache che deve essere letta durante ogni previsione. Un ulteriore elemento dell’architettura è la length-aware attention temperature: poiché l’attenzione softmax tende a distribuirsi progressivamente quando cresce il numero delle chiavi, Kumo Tabular modifica la temperatura delle query secondo un fattore che aumenta con il logaritmo del numero delle chiavi, utilizzando un coefficiente appreso separatamente per ogni attention head. L’obiettivo è preservare un’attenzione sufficientemente selettiva anche quando le tabelle utilizzate durante l’inferenza sono molto più lunghe rispetto a quelle tipicamente incontrate durante il training. Il livello di uscita produce probabilità per le classi nei problemi di classificazione, mentre nelle attività di regressione genera 999 quantili, dai quali possono essere ricavati sia una previsione puntuale sia una stima dell’incertezza.
Una caratteristica centrale di Kumo Tabular riguarda il modo in cui è stato costruito il dataset di pretraining. NVIDIA non ha utilizzato tabelle reali, ma ha generato artificialmente ogni tabella a partire da uno Structural Causal Model. Il generatore definisce innanzitutto una configurazione complessiva della tabella e crea successivamente un grafo causale casuale che collega differenti variabili nascoste. Il grafo viene valutato dalle radici verso le foglie applicando a ciascun nodo funzioni estratte casualmente, tra cui trasformazioni lineari, piccole reti neurali, alberi e Gaussian process. Alcuni nodi vengono trasformati nelle colonne numeriche o categoriche osservabili, uno viene utilizzato come target, mentre altri restano nascosti e svolgono quindi un ruolo simile a quello delle cause non misurate che possono essere presenti nei dataset reali. Dopo questa generazione iniziale vengono applicate ulteriori trasformazioni che introducono correlazioni tra gruppi di colonne, limitano gli outlier e inseriscono valori mancanti. Un controllo basato su un ensemble di alberi elimina inoltre le tabelle dalle quali non emerge un segnale effettivamente apprendibile.
Il generatore introduce intenzionalmente numerose imperfezioni tipiche dei dati del mondo reale. I valori possono risultare mancanti secondo schemi differenti, alcune feature vengono discretizzate o rese meno precise in modo che righe apparentemente duplicate possano avere etichette differenti, le variabili categoriche possono comprendere un numero elevato di livelli e i target di regressione possono presentare distribuzioni heavy-tailed. Durante l’addestramento, la maggior parte delle righe di ciascuna tabella viene fornita con la relativa etichetta come contesto, mentre il modello deve prevedere le etichette delle righe rimanenti. Classificazione e regressione vengono addestrate separatamente: per la prima viene utilizzata una cross-entropy loss, mentre per la seconda viene applicata una quantile loss. Il training è suddiviso in tre fasi. La prima utilizza tabelle con 1.024 righe e fino a 100 colonne; nella seconda la dimensione del contesto varia da 400 fino a 10.240 righe, mentre la terza estende il contesto fino a 60.000 righe, mantenendo fino a 100 colonne. Nel complesso Kumo Tabular Small, Medium e Large sono stati esposti rispettivamente a circa 35 milioni, 71 milioni e 137 milioni di tabelle artificiali. NVIDIA ha inoltre previsto la pubblicazione della procedura di training e dei generatori utilizzati per produrre questi dati artificiali.
Le valutazioni diffuse da NVIDIA comprendono TabArena, BeyondArena, TALENT e ScoringBench. Su TabArena i tre modelli sono stati utilizzati con le impostazioni predefinite e confrontati con sistemi che comprendono gradient-boosted trees sottoposti a tuning, AutoGluon e altri foundation model progettati per dati tabellari. Kumo Tabular raggiunge un ELO complessivo di 1950 e, nella valutazione condotta utilizzando una singola GPU RTX 6000 Pro per tutti i modelli, viene indicato come 26 volte più veloce di LimiX-2; le tre configurazioni si collocano inoltre sul nuovo fronte di Pareto tra accuratezza ed efficienza dichiarato da NVIDIA. Su BeyondArena il modello ottiene un ELO di 1418 e un Improvability Score del 7,78%. Nei test TALENT raggiunge il miglior posizionamento complessivo considerando accuratezza nella classificazione, log-loss della classificazione e RMSE nella regressione, con average rank rispettivamente pari a 6,67, 3,98 e 4,22. ScoringBench, dedicato invece alla qualità delle distribuzioni predittive, colloca Kumo Tabular Large e Kumo Tabular Medium rispettivamente al primo e al secondo posto in termini di average rank.
L’utilizzo presenta comunque alcuni limiti tecnici definiti. Kumo Tabular opera direttamente soltanto su colonne numeriche e categoriche; informazioni testuali, immagini o timestamp devono essere trasformati in feature attraverso le procedure di preprocessing disponibili nella libreria. Un singolo forward pass supporta direttamente fino a dieci classi, mentre structured-data-models permette di estendere la classificazione a un numero arbitrario di classi utilizzando error-correcting output codes. Le prestazioni possono inoltre diminuire quando le tabelle superano nettamente le dimensioni incontrate durante l’addestramento oppure quando le righe sulle quali vengono effettuate le previsioni appartengono a una distribuzione differente rispetto alle righe utilizzate come contesto. Prima dell’impiego operativo NVIDIA raccomanda quindi di verificare accuratezza e calibrazione utilizzando dati held-out rappresentativi dello specifico scenario applicativo.
Kumo Tabular viene eseguito attraverso structured-data-models, una libreria GPU-native che richiede almeno Python 3.11 e PyTorch 2.7. Per i workload CUDA viene raccomandato anche cuDF, in modo da mantenere sulla GPU le operazioni tipiche dei dataframe ed evitare trasferimenti di dati non necessari tra CPU e acceleratore. La libreria fornisce una piattaforma comune per diversi foundation model destinati ai dati strutturati e comprende le implementazioni di riferimento di TabICLv2, KumoTabular e TabFM per i dati tabellari, oltre a KumoRelational per i dati relazionali. Il codice sviluppato direttamente da NVIDIA all’interno del repository è distribuito con licenza Apache 2.0, mentre i pesi di Kumo Tabular utilizzano la licenza OpenMDW 1.1. La combinazione tra pesi pubblicamente disponibili, inferenza senza addestramento specifico per ogni nuovo dataset e una libreria che include preprocessing e gestione delle classi consente quindi di utilizzare direttamente le righe etichettate di una tabella come contesto e ottenere nuove previsioni senza costruire da zero una pipeline di machine learning separata per ciascun problema.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)