
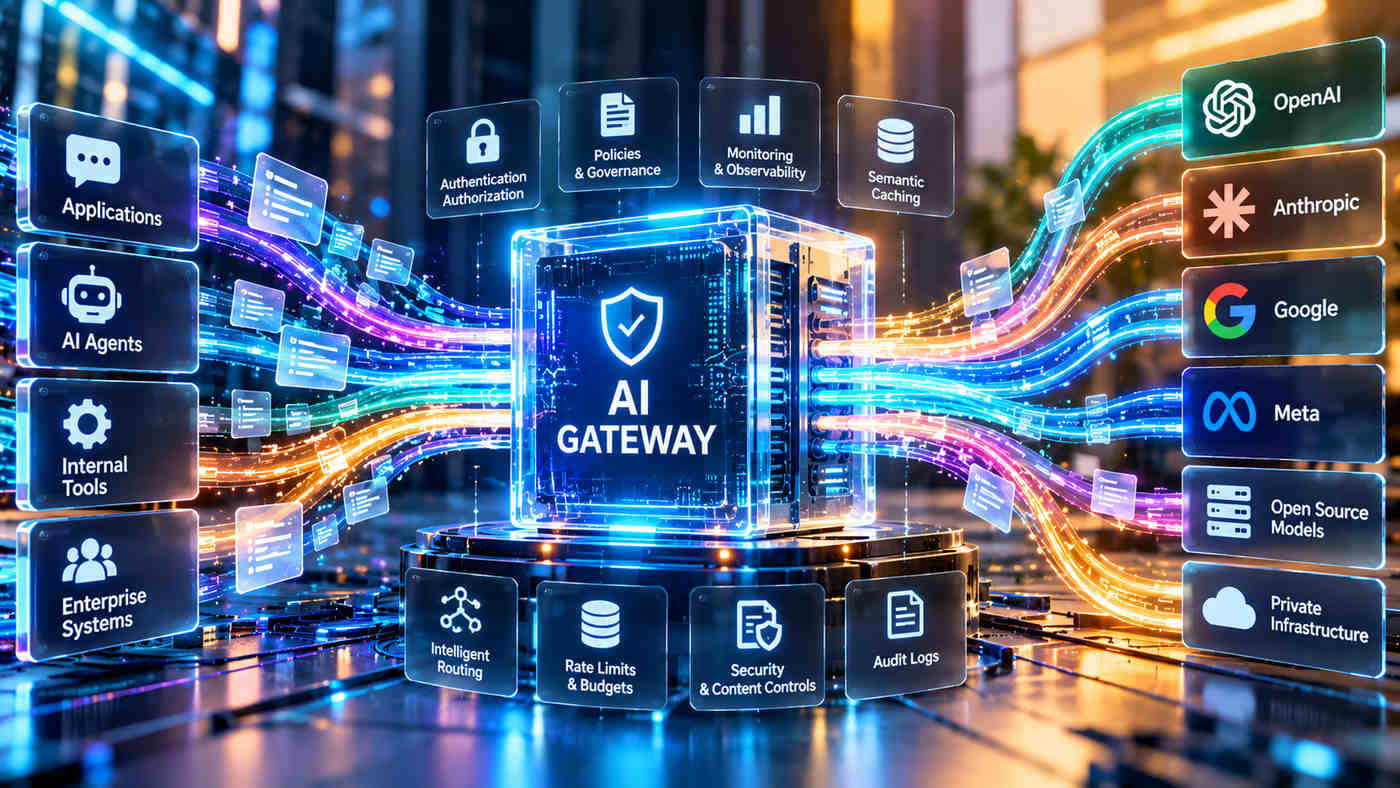
Perplexity ha pubblicato una guida tecnica dedicata al funzionamento degli AI Gateway, componenti infrastrutturali progettati per centralizzare la gestione delle richieste provenienti da applicazioni e agenti di intelligenza artificiale dirette verso modelli linguistici, servizi esterni e strumenti software. Un AI Gateway opera come livello proxy tra i sistemi applicativi e i fornitori dei modelli, occupandosi di instradamento, autenticazione, autorizzazione, monitoraggio dei consumi, sicurezza e applicazione delle politiche aziendali. Questa architettura permette di superare la gestione separata delle integrazioni con OpenAI, Anthropic, Google, modelli open source e sistemi ospitati su infrastrutture private, che normalmente richiedono SDK, chiavi API e formati di richiesta differenti. Le applicazioni inviano le richieste a un endpoint centralizzato, mentre il Gateway traduce le chiamate nel formato previsto dal fornitore selezionato, consentendo di aggiungere, sostituire o dismettere modelli attraverso modifiche alla configurazione anziché intervenire direttamente sul codice dei singoli servizi.
L’elaborazione di una richiesta attraversa quattro passaggi operativi. Il sistema verifica inizialmente l’identità del chiamante e le autorizzazioni associate alla chiave di accesso e al relativo ruolo, applica successivamente le politiche aziendali riguardanti limiti di token, budget, protezione dei dati personali e controlli sui contenuti, seleziona il modello di destinazione in funzione di costo, latenza, capacità o disponibilità e registra infine le informazioni necessarie alla tracciabilità dell’operazione. Il meccanismo di routing può prevedere il passaggio automatico a un fornitore alternativo quando il servizio principale presenta indisponibilità o restrizioni sul numero di richieste. I limiti di utilizzo possono essere attribuiti a singoli utenti, progetti o gruppi di lavoro, con blocco delle richieste al raggiungimento delle soglie stabilite. Tra le funzionalità previste rientra inoltre la semantic caching, che confronta semanticamente una nuova richiesta con quelle già elaborate e può restituire una risposta memorizzata senza effettuare una nuova chiamata al modello. I sistemi di osservabilità raccolgono il modello utilizzato, il numero di token consumati, i tempi di risposta, gli errori e l’esito delle operazioni, mentre i controlli di governance regolano l’accesso ai modelli e conservano registrazioni verificabili delle attività.
Perplexity distingue gli AI Gateway dai tradizionali API Gateway, evidenziando che i primi devono interpretare elementi specifici delle applicazioni generative, come il consumo di token, il contenuto dei prompt, le istruzioni potenzialmente malevole e le equivalenze semantiche tra richieste. Un API Gateway convenzionale gestisce prevalentemente autenticazione, instradamento verso servizi backend e limitazioni basate sul numero delle chiamate, mentre un’infrastruttura destinata ai modelli linguistici può applicare criteri di selezione basati sulle caratteristiche del modello e controlli specifici sui dati trasmessi. Viene inoltre precisata la differenza tra LLM Gateway, responsabile delle chiamate ai modelli, e MCP Gateway, destinato alla governance degli strumenti e delle fonti informative accessibili attraverso il Model Context Protocol. Soluzioni come LiteLLM, Portkey, Azure API Management ed Envoy AI Gateway integrano progressivamente entrambe le funzioni. Nei sistemi agentici, caratterizzati da sequenze iterative di interrogazioni ai modelli e utilizzo di strumenti, il Gateway consente di controllare ciascuna comunicazione, autorizzare gli accessi alle risorse e registrare le operazioni in un audit log, senza tuttavia sostituire la logica di pianificazione dell’agente, la gestione della memoria conversazionale o la valutazione della qualità delle risposte.
L’introduzione di un livello intermedio comporta inevitabilmente un incremento della latenza. Un benchmark indipendente realizzato nel giugno 2026 dal gruppo VMware Cloud Foundation di Broadcom ha misurato, per una configurazione ottimizzata di Envoy AI Gateway, un sovraccarico di circa 2 millisecondi per richiesta fino a 224 utenti contemporanei, considerando instradamento e rate limiting ma escludendo l’ispezione dei contenuti. L’attivazione di guardrail e semantic caching può introdurre ulteriori ritardi nell’ordine di decine o centinaia di millisecondi. La gestione centralizzata non garantisce inoltre automaticamente una maggiore qualità delle risposte, poiché una politica di routing orientata esclusivamente alla riduzione dei costi potrebbe selezionare modelli meno appropriati. La necessità di controllare più fornitori emerge anche dai dati raccolti da Dataiku e Harris Poll nel 2026: il 93% dei CIO aziendali intervistati considera modelli differenti più adatti a specifiche applicazioni, l’81% delle imprese prevede di utilizzare almeno due fornitori e il 55% ha già cambiato almeno una volta il proprio provider LLM.
Il quadro operativo comprende anche gli aspetti economici, la continuità dei servizi e la protezione dei dati. Secondo l’indagine DoiT/Sapio del 2026, il 79% dei responsabili finanziari coinvolti ha dichiarato di aver superato il budget destinato all’intelligenza artificiale nell’anno precedente. Il Cisco AI Readiness Index 2025, condotto su 8.039 dirigenti di organizzazioni con oltre 500 dipendenti, ha rilevato che l’83% pianificava lo sviluppo o l’adozione di agenti AI, mentre Gartner ha previsto la presenza di agenti specializzati nel 40% delle applicazioni aziendali entro la fine del 2026, rispetto a meno del 5% nel 2025. Le rilevazioni indipendenti citate da Perplexity collocavano nel maggio 2026 la disponibilità dei principali fornitori LLM tra il 99,85% e il 99,9%, equivalenti indicativamente a 9-13 ore annue di indisponibilità. In un’indagine Cockroach Labs condotta su 1.125 responsabili infrastrutturali, circa due terzi degli intervistati hanno stimato in oltre 100.000 dollari il costo aziendale di un’ora di interruzione dei servizi AI. Sul versante della sicurezza, OWASP ha individuato nella prompt injection il principale rischio per le applicazioni LLM nel 2025, mentre Zscaler ThreatLabz ha rilevato un incremento annuale del 93% dei dati aziendali trasmessi alle applicazioni di intelligenza artificiale e 410 milioni di violazioni delle politiche di prevenzione della perdita di dati associate a ChatGPT.
La scelta di implementare un AI Gateway dipende dalla complessità effettiva dell’infrastruttura. La presenza di chiavi API distribuite in più applicazioni, costi difficilmente attribuibili ai diversi reparti, dipendenza da un singolo fornitore, richieste contenenti informazioni riservate non sottoposte a controllo, integrazioni MCP e assenza di una visione centralizzata della conformità costituiscono indicatori di una possibile necessità operativa. Per prototipi, progetti con traffico limitato o applicazioni che utilizzano un solo modello con requisiti di sicurezza essenziali, il livello aggiuntivo può invece risultare superfluo. Tra le alternative self-hosted figurano LiteLLM, Portkey e Apache APISIX, installabili su cloud privati, Kubernetes o infrastrutture locali; tra i servizi gestiti sono citati Cloudflare AI Gateway, Azure API Management e Amazon Bedrock AgentCore Gateway. La valutazione comprende il controllo sui dati, la riservatezza, i tempi di implementazione, le integrazioni disponibili e gli oneri di gestione delle componenti di stato, tra cui PostgreSQL, Redis ed etcd. Non esiste pertanto una soluzione open source universalmente migliore: la configurazione dipende dai vincoli applicativi e dal livello di controllo richiesto sui flussi di intelligenza artificiale.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)