
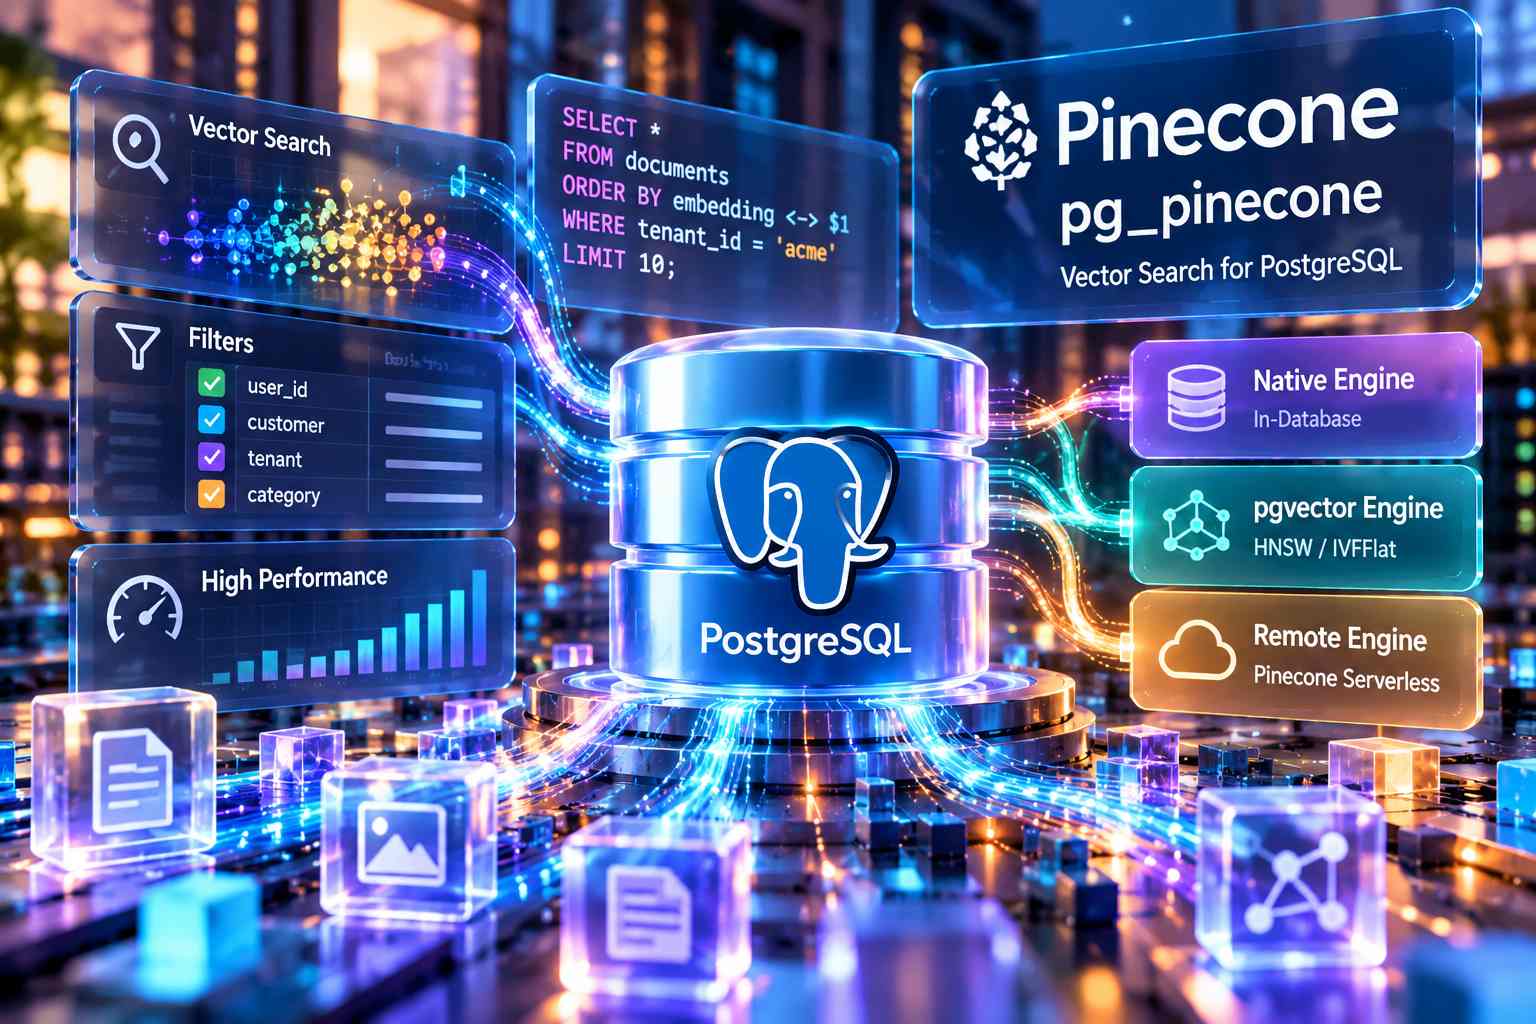
Pinecone ha annunciato il rilascio di pg_pinecone, un’estensione open source per PostgreSQL distribuita con licenza Apache 2.0 che introduce un nuovo motore di ricerca vettoriale utilizzabile direttamente sulle colonne già gestite attraverso pgvector. Il progetto è stato sviluppato per migliorare l’efficienza delle interrogazioni per similarità, ridurre l’occupazione degli indici e affrontare le difficoltà associate alle ricerche vettoriali che includono filtri su attributi relazionali. L’estensione mantiene PostgreSQL come sistema principale di conservazione dei dati, consentendo alle applicazioni di continuare a utilizzare connessioni SQL e strutture tabellari esistenti senza trasferire necessariamente i vettori a un database separato. Pinecone individua una delle principali limitazioni degli approcci basati su indici HNSW nella crescita del consumo di memoria e nei costi di costruzione degli indici, oltre che nel comportamento delle ricerche filtrate. Quando un’interrogazione deve recuperare elementi appartenenti a uno specifico utente, cliente o tenant, l’applicazione dei filtri dopo l’individuazione dei vicini più prossimi può eliminare una parte consistente dei risultati, producendo un numero di righe inferiore al limite SQL richiesto oppure richiedendo scansioni aggiuntive. Il nuovo motore affronta questo problema integrando il controllo dei filtri direttamente nel processo di ricerca.
L’architettura di pg_pinecone prevede tre modalità di esecuzione configurabili a livello di tabella. Il motore native, selezionato per impostazione predefinita, costruisce ed esegue gli indici all’interno di PostgreSQL senza richiedere un account Pinecone, una chiave API o comunicazioni di rete con servizi esterni. Il motore pgvector permette invece di utilizzare indici HNSW o IVFFlat già esistenti, risultando appropriato soprattutto per tabelle che non richiedono filtri vettoriali complessi. Il motore remote trasferisce l’esecuzione delle ricerche a un indice serverless gestito da Pinecone, con l’obiettivo di supportare carichi che superano la capacità del singolo server PostgreSQL. Il passaggio fra le tre modalità avviene attraverso la funzione pinecone.set_engine() e non richiede modifiche alle interrogazioni SQL applicative. La commutazione è reversibile e consente di adattare progressivamente l’infrastruttura senza cambiare lo schema logico utilizzato dal software. Nel caso del motore remoto, i vettori possono essere sincronizzati in background verso l’indice gestito, mentre le ricerche continuano a essere eseguite in PostgreSQL durante il trasferimento iniziale. La modalità locale mantiene invece interamente nel database i dati e le operazioni di ricerca.
Il motore native utilizza un algoritmo di approximate nearest neighbor basato su un indice inverted file, nel quale i vettori vengono raggruppati in cluster in funzione della loro similarità. Al posto della struttura a grafo caratteristica di HNSW viene utilizzata una codifica quantizzata RaBitQ, con un consumo indicativo di circa un bit per dimensione vettoriale, oltre ad alcuni valori aggiuntivi necessari alla correzione delle stime. I codici relativi ai vettori appartenenti allo stesso cluster sono memorizzati in maniera contigua, riducendo la necessità di attraversare strutture distribuite in numerose pagine di memoria. Durante una ricerca, il sistema identifica inizialmente i cluster più vicini al vettore richiesto confrontandolo con i rispettivi centroidi, stima successivamente le distanze attraverso le rappresentazioni compresse e seleziona i candidati migliori, che vengono infine riordinati utilizzando i vettori completi conservati nella tabella. Per supportare le interrogazioni filtrate, il motore memorizza accanto ai codici anche il valore di una colonna utilizzata come filtro e mantiene informazioni sulla distribuzione dei valori durante la costruzione dell’indice. Quando il filtro interessa una frazione particolarmente ridotta dei record, per impostazione predefinita non superiore al 3%, il sistema esegue una ricerca preliminarmente filtrata su tutti gli elementi corrispondenti, valutandoli attraverso i vettori originali e ottenendo risultati esatti. Per filtri meno selettivi viene utilizzata una procedura single-stage che esplora fino a metà dei cluster più vicini, applicando le condizioni prima del calcolo delle distanze. I nuovi inserimenti vengono associati al cluster più appropriato e diventano immediatamente ricercabili, mentre modifiche molto estese della tabella possono richiedere un’operazione REINDEX o una manutenzione automatica per riequilibrare i raggruppamenti.
Nei benchmark pubblicati da Pinecone, realizzati su un milione di vettori wiki_dpr a 768 dimensioni, l’indice native ha occupato 136 MB, contro 2,0 GB di un indice HNSW con rappresentazioni halfvec e 4,1 GB con vettori a precisione completa. I test sono stati eseguiti su un’istanza AWS r6id.4xlarge con 16 vCPU e 128 GB di memoria, utilizzando PostgreSQL 17 per alcune misurazioni e PostgreSQL 18 per le interrogazioni filtrate. Con ricerche non filtrate e recall pari a 0,95, Pinecone ha rilevato una latenza mediana di 1,3 millisecondi per il proprio motore, rispetto a 1,7 e 2,7 millisecondi per le due configurazioni HNSW. Con recall pari a 0,99, i valori dichiarati sono rispettivamente 2,3, 4,7 e 6,7 millisecondi. Applicando un filtro corrispondente al 10% dei record, il motore native ha raggiunto recall 1,000 in 12,3 millisecondi, mentre HNSW con scansioni iterative ha ottenuto, nel confronto riportato, recall massimo di 0,920 in 5,9 millisecondi. Con un filtro dell’1% il motore Pinecone ha registrato recall 0,981 in 8,3 millisecondi. La costruzione dell’indice ha richiesto 45 secondi, contro 62 e 79 secondi delle configurazioni alternative. Le misurazioni sono fornite dall’azienda e dipendono dal dataset, dalle impostazioni e dall’ambiente di test, per il quale è disponibile un sistema di benchmark riproducibile.
pg_pinecone richiede PostgreSQL 17 o 18, l’installazione di pgvector e privilegi di superutente. È disponibile attraverso pacchetti precompilati su GitHub oppure mediante immagini Docker basate su pgvector, mentre la compilazione dai sorgenti utilizza Rust e cargo-pgrx 0.19.2. L’impiego del motore remoto richiede anche la configurazione dell’estensione nelle librerie precaricate di PostgreSQL. Accanto alla ricerca vettoriale, Pinecone mette a disposizione funzionalità opzionali per generare embedding da testo attraverso la funzione SQL embed(), effettuare interrogazioni full-text con BM25, combinare ricerca lessicale e vettoriale e riordinare i risultati mediante modelli di reranking richiamabili con rerank(). I servizi di inferenza gestiti richiedono l’accesso alle API Pinecone, mentre la modalità nativa di ricerca non comporta tale dipendenza. Il repository pubblico comprende documentazione SQL, istruzioni operative, procedure di disaster recovery e strumenti per riprodurre i test prestazionali. Pinecone ha dichiarato che manterrà direttamente il progetto, esaminerà i contributi esterni e definirà l’evoluzione della prima versione anche attraverso le segnalazioni della comunità su GitHub, Discord e incontri periodici dedicati agli sviluppatori.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI).