
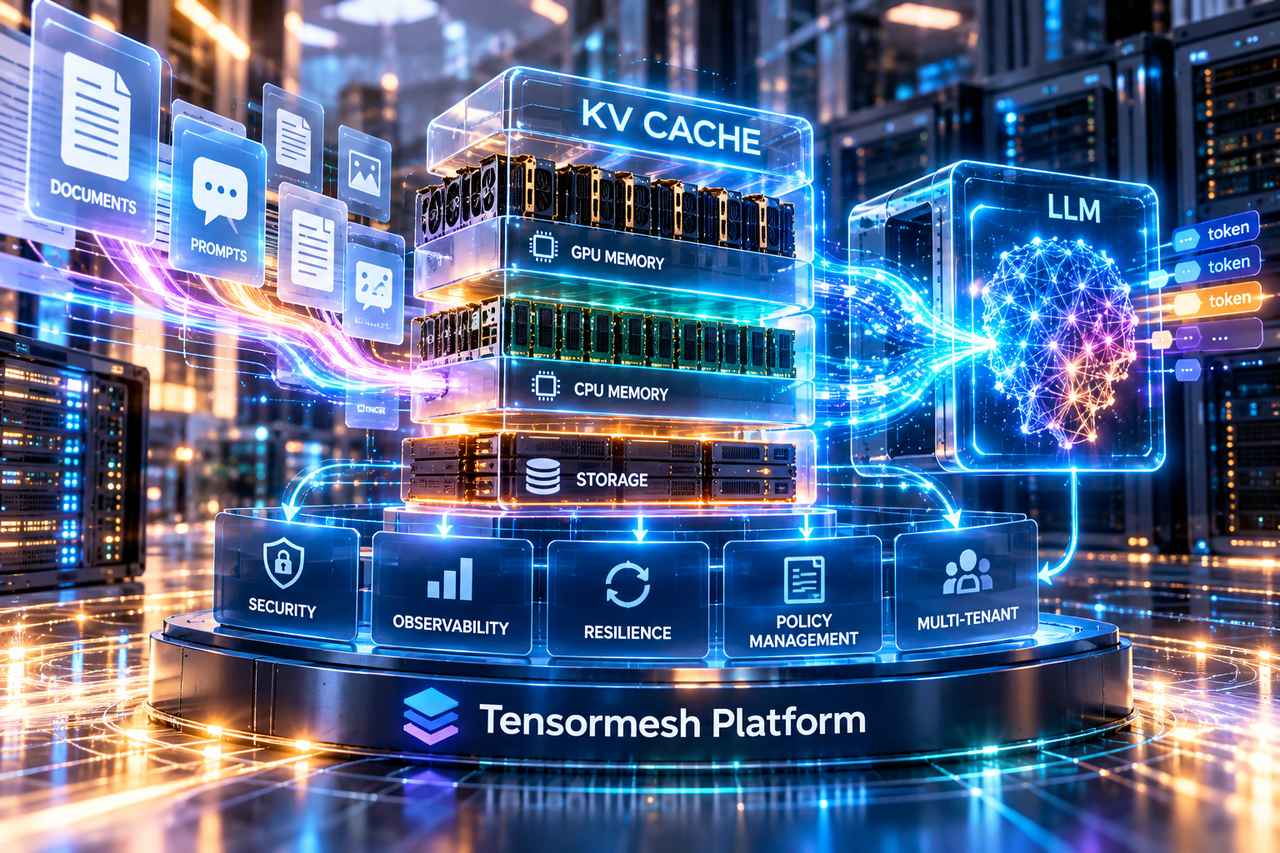
Tensormesh lancia Tensormesh Platform, una soluzione infrastrutturale progettata per ridurre il costo computazionale dell’inferenza dei modelli linguistici di grandi dimensioni attraverso la gestione e il riutilizzo della Key-Value cache, comunemente indicata come KV cache. La piattaforma nasce dall’esperienza del gruppo di sviluppo responsabile di LMCache, progetto open source dedicato alla gestione della memoria temporanea impiegata dai Large Language Model durante l’elaborazione delle richieste. Tensormesh estende queste funzionalità introducendo un livello di amministrazione destinato agli ambienti aziendali, nel quale gli stati intermedi dell’inferenza possono essere conservati, individuati, trasferiti e riutilizzati attraverso differenti risorse hardware. L’architettura comprende la memoria delle GPU, la memoria principale delle CPU e i sistemi di archiviazione, consentendo di distribuire i dati temporanei su più livelli in funzione delle esigenze operative. L’obiettivo consiste nell’evitare che le infrastrutture debbano ripetere elaborazioni già eseguite quando richieste differenti condividono documenti, istruzioni, cronologie conversazionali o altre porzioni significative del contesto. Questa condizione si verifica frequentemente nelle applicazioni aziendali che interrogano repository documentali, nei sistemi di assistenza basati su manuali tecnici e negli agenti AI che utilizzano istruzioni operative persistenti, producendo un consumo aggiuntivo di risorse GPU ogni volta che il modello deve ricostruire informazioni precedentemente elaborate.
Il funzionamento della piattaforma si basa sulla distinzione tra le due principali fasi dell’inferenza autoregressiva: prefill e decode. Durante il prefill, il modello elabora i token contenuti nel prompt iniziale e costruisce le rappresentazioni intermedie necessarie ai meccanismi di attenzione; durante il decode, genera progressivamente i token della risposta sfruttando anche le informazioni già disponibili nella KV cache. Quest’ultima conserva gli stati associati alle chiavi e ai valori dei livelli di attenzione, evitando che il modello debba ricalcolare integralmente il contesto precedente durante la generazione. Tensormesh interviene sulla possibilità di conservare e recuperare tali stati anche tra richieste distinte, anziché limitarne l’utilizzo alla singola sessione di inferenza. Quando un’applicazione sottopone più domande relative allo stesso documento, il sistema può recuperare le rappresentazioni associate alle porzioni di testo comuni e utilizzarle per elaborare la nuova richiesta, continuando comunque a generare una risposta specifica. Il procedimento è quindi diverso dalla memorizzazione di risposte già prodotte, perché riguarda il riutilizzo di calcoli intermedi e non la restituzione di contenuti precedentemente generati. Il vantaggio si concentra principalmente sulla fase di prefill e sul tempo necessario a produrre il primo token, mentre la generazione dei nuovi token mantiene i propri requisiti computazionali. Di conseguenza, l’efficacia del sistema dipende dalla quantità di contesto condiviso tra le richieste, dalla possibilità di recuperare rapidamente gli stati memorizzati e dal rapporto tra il costo del recupero e quello di una nuova elaborazione.
Tensormesh Platform introduce cinque componenti di gestione destinati all’esercizio in ambienti produttivi: sicurezza, osservabilità, resilienza, amministrazione delle policy e separazione degli ambienti multi-tenant. Queste capacità permettono di controllare l’accesso ai dati temporanei, monitorare il comportamento dell’infrastruttura, gestire eventuali malfunzionamenti e definire le condizioni di conservazione ed eliminazione delle informazioni memorizzate. Le API di controllo consentono inoltre di individuare le voci della cache, mantenerle disponibili mediante operazioni di pinning, trasferirle tra differenti risorse, comprimerle oppure cancellarle. La gestione degli stati intermedi viene così separata dal singolo processo di inferenza e trattata come un servizio infrastrutturale condiviso. La piattaforma utilizza un’architettura basata su Kubernetes, con un operatore dedicato alla gestione dei componenti, cache server distribuiti sui nodi GPU e un coordinatore responsabile delle operazioni a livello di infrastruttura. L’installazione avviene attraverso Helm, mentre l’amministrazione viene supportata da un’interfaccia web e da strumenti a riga di comando. LMCache costituisce la base tecnologica del sistema e permette di trasferire gli stati della cache tra diversi livelli di memoria, sessioni ed istanze dei motori di inferenza, utilizzando backend di archiviazione e trasporto configurabili. Questa organizzazione risponde anche ai limiti della memoria GPU, che non può essere occupata indiscriminatamente da dati potenzialmente riutilizzabili senza sottrarre capacità alle richieste attive. Il trasferimento degli stati meno frequentemente utilizzati verso la memoria host o lo storage consente di aumentarne la quantità complessivamente conservabile, introducendo tuttavia costi aggiuntivi legati alla latenza di accesso e alla larghezza di banda.
Una delle caratteristiche tecnologiche più rilevanti riguarda l’impiego di CacheBlend, un meccanismo sviluppato nell’ambito di LMCache per estendere il riutilizzo della memoria oltre i prefissi identici. Le tecniche convenzionali di prefix caching funzionano quando più prompt condividono esattamente la stessa sequenza iniziale di token, ma risultano meno efficaci nelle applicazioni Retrieval-Augmented Generation, nelle quali documenti già elaborati possono essere recuperati in ordine differente oppure inseriti in posizioni diverse del contesto. CacheBlend affronta questa limitazione recuperando porzioni memorizzate della KV cache ed eseguendo nuovamente i calcoli soltanto per una frazione selezionata dei token, necessaria a tenere conto delle dipendenze contestuali che influenzano le rappresentazioni interne del modello. La ricomputazione parziale è importante perché gli stati di attenzione associati a un segmento di testo possono cambiare quando cambia il contenuto che lo precede. La ricerca dedicata a CacheBlend, presentata a EuroSys 2025, ha riportato nei carichi sperimentali analizzati un miglioramento compreso tra 2,2 e 3,3 volte nel tempo necessario a generare il primo token e un aumento del throughput compreso tra 2,8 e 5 volte rispetto alla ricostruzione completa della KV cache. Le valutazioni sono state condotte utilizzando tre modelli open source e quattro dataset di benchmark; rappresentano quindi risultati ottenuti in condizioni specifiche e non prestazioni garantite per tutte le configurazioni della piattaforma.
L’architettura descritta da Tensormesh comprende inoltre il trasferimento peer-to-peer degli stati della cache tra nodi differenti e la separazione delle operazioni di prefill e decode, due funzionalità destinate a migliorare la distribuzione dei carichi all’interno delle infrastrutture di inferenza. Il trasferimento tra nodi permette a un’istanza di recuperare informazioni precedentemente elaborate da un’altra, mentre la disaggregazione delle fasi di inferenza consente di assegnare l’elaborazione iniziale dei prompt e la generazione delle risposte a risorse computazionali separate. La documentazione tecnica presenta tuttavia una distinzione importante tra le funzionalità descritte nell’annuncio e quelle effettivamente validate nelle singole versioni del software: la matrice di compatibilità datata 17 settembre 2026 colloca ancora il trasferimento peer-to-peer e la disaggregazione tra le funzionalità previste nella roadmap, mentre altre sezioni documentali fanno riferimento a implementazioni preliminari. Per quanto riguarda i motori di inferenza, risultano verificati vLLM e NVIDIA Dynamo, mentre il supporto di SGLang e TensorRT-LLM è indicato tra gli sviluppi previsti. La configurazione descritta per il lancio comprende vLLM su Kubernetes, GPU NVIDIA oppure acceleratori AMD Instinct compatibili attraverso ROCm, con sistemi di archiviazione basati su filesystem. Il caching non limitato ai prefissi per i modelli dense e l’integrazione con SGLang vengono presentati come capacità successive. La piattaforma opera inoltre accanto a modelli distribuiti su infrastrutture gestite direttamente dall’organizzazione e non costituisce un’estensione applicabile indistintamente alle API di modelli ospitati da fornitori esterni.
Tensormesh Platform viene resa disponibile contestualmente al lancio, proponendo un sistema nel quale la KV cache diventa una risorsa persistente e amministrabile a livello di infrastruttura anziché un elemento temporaneo confinato al singolo processo di generazione. La misurazione delle prestazioni richiede il confronto tra richieste eseguite con cache inizialmente vuota e richieste che possono recuperare stati già disponibili, considerando il time-to-first-token, il throughput, l’utilizzo delle GPU, i tempi di trasferimento e il consumo di memoria, storage e rete. Anche un’elevata percentuale di cache hit, infatti, non implica necessariamente un risparmio complessivo se il recupero delle informazioni richiede più risorse della loro ricostruzione. La verifica deve comprendere anche la qualità delle risposte, soprattutto quando vengono combinati segmenti elaborati in contesti differenti, nonché il comportamento delle policy di conservazione e isolamento tra utenti o reparti aziendali. Con questa impostazione, Tensormesh propone una gestione centralizzata degli stati computazionali riutilizzabili, destinata principalmente alle organizzazioni che eseguono modelli linguistici sulle proprie infrastrutture e gestiscono volumi significativi di richieste caratterizzate da contesti ripetitivi.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)