
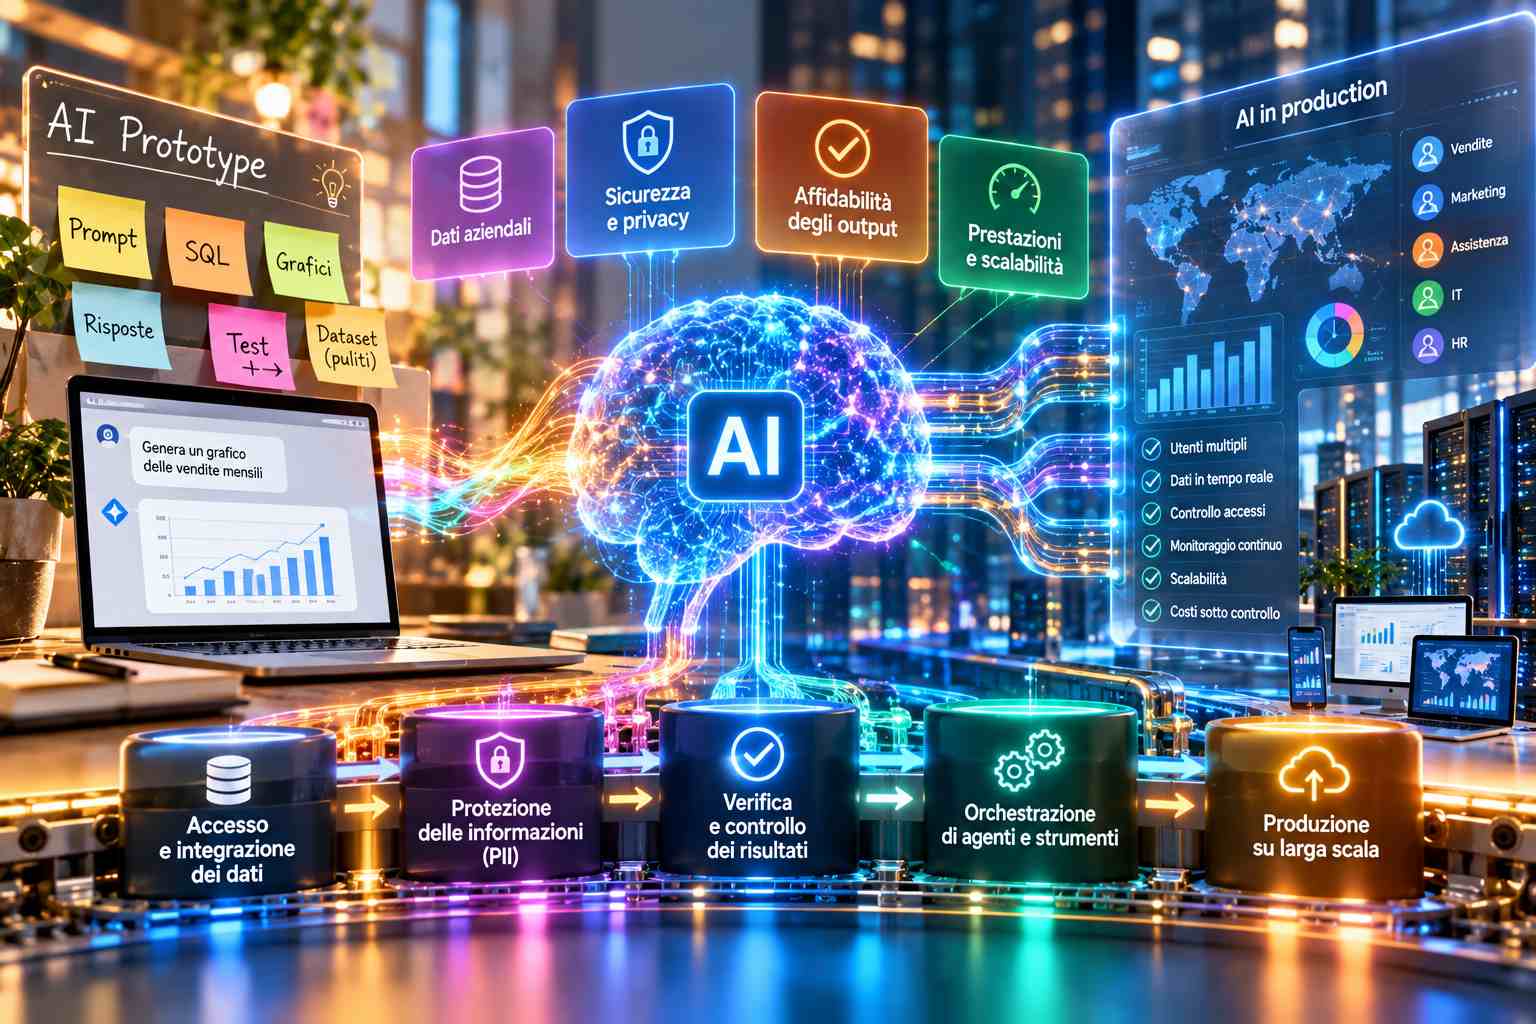
Tiger Analytics ha illustrato, durante Cypher 2026, tenutosi a Bengaluru dal 7 al 9 ottobre, le principali difficoltà incontrate dalle imprese nel trasferimento dei prototipi di intelligenza artificiale generativa verso sistemi utilizzabili su larga scala. Bhanu Prasad Mahanti e Sri Vallabha Deevi hanno descritto un insieme di problematiche che riguardano l’affidabilità delle risposte, l’accesso ai dati aziendali, la protezione delle informazioni riservate, le prestazioni e la gestione di migliaia di interrogazioni. Un prototipo può produrre correttamente query SQL, grafici o risposte a domande circoscritte, ma il suo comportamento in un ambiente produttivo deve essere verificato su dati aggiornati continuamente, richieste non previste durante lo sviluppo e utenti caratterizzati da differenti autorizzazioni. Mahanti ha distinto tre categorie di implementazioni: workflow agentici basati su un’orchestrazione deterministica, agenti singoli capaci di selezionare e utilizzare strumenti e sistemi multiagente autonomi. Le prime due categorie risultano generalmente più semplici da distribuire e controllare, mentre la terza presenta maggiori difficoltà nella previsione delle interazioni e nella verifica del comportamento complessivo. Richiamando un’indagine condotta fra sviluppatori dell’ecosistema LangChain, Mahanti ha indicato la qualità degli output come principale difficoltà, seguita dalla latenza e dalla sicurezza. Le soglie di affidabilità richieste dipendono dal contesto: un sistema di personalizzazione delle comunicazioni commerciali può tollerare errori occasionali che sarebbero invece inaccettabili in applicazioni destinate a produrre decisioni operative o informazioni economicamente vincolanti.
Un caso concreto presentato da Deevi riguarda un produttore di dispositivi elettronici che raccoglie nel cloud informazioni sullo stato di funzionamento delle proprie apparecchiature. L’azienda disponeva già di un’interfaccia attraverso la quale gli amministratori IT potevano visualizzare dati riepilogativi ed eseguire interrogazioni SQL, ma non tutti gli utilizzatori possedevano le competenze necessarie per formulare query complesse. Tiger Analytics ha integrato un chatbot agentico che interpreta le richieste in linguaggio naturale, seleziona le tabelle pertinenti, genera ed esegue le interrogazioni, presenta visualizzazioni e permette di approfondire i risultati attraverso conversazioni successive. Il sistema consente anche di confrontare dati provenienti da tabelle differenti e di indagare le cause dei malfunzionamenti dei dispositivi. La soluzione ha attraversato tre versioni, con la terza in fase di distribuzione. Una delle difficoltà principali riguarda la diversa frequenza di aggiornamento delle informazioni: alcuni dati dei dispositivi arrivano ogni quattro ore, mentre altre tabelle seguono cicli differenti. Per questo motivo non è stato possibile affidarsi a una singola tabella unificata, ma è stato necessario costruire una procedura capace di individuare dinamicamente le fonti più appropriate. Una versione precedente aveva raggiunto un’accuratezza dichiarata del 90% e una latenza di circa dieci secondi sulle interrogazioni complesse. L’azienda ha sviluppato soluzioni analoghe anche per il commercio al dettaglio e per la gestione dei sinistri assicurativi.
Un secondo insieme di requisiti riguarda la protezione delle informazioni personali e l’applicazione delle autorizzazioni. Durante le prove iniziali, i sistemi vengono frequentemente sviluppati utilizzando dataset ripuliti o sintetici, mentre negli ambienti reali informazioni identificative possono comparire nei prompt, nei database, nei grafici e negli archivi vettoriali impiegati per il recupero semantico dei documenti. Tiger Analytics utilizza tecniche di tokenizzazione reversibile per sostituire i dati personali prima dell’invio ai modelli, applicando ulteriori mascheramenti dinamici ai database e procedure di sanificazione dei contenuti prima della creazione degli embedding. La piattaforma integra inoltre piccoli modelli linguistici per individuare comportamenti potenzialmente ostili e regole deterministiche per controllare i contenuti provenienti da fonti esterne. Le minacce considerate comprendono prompt injection, estrazione delle istruzioni di sistema, manipolazione dei dati e tentativi di escalation dei privilegi. I risultati restituiti dagli strumenti collegati ai modelli vengono trattati come contenuti non attendibili, con possibilità di introdurre una revisione umana per le operazioni più sensibili.
Il controllo degli accessi richiede meccanismi applicati direttamente all’infrastruttura dei dati. Gli amministratori devono impedire, per esempio, che un utente del reparto marketing consulti informazioni riservate alle vendite oppure che un operatore acceda ai dati delle risorse umane. Tiger Analytics utilizza permessi basati sui ruoli e identificativi dei tenant, ricorrendo nelle configurazioni più restrittive a database separati, namespace vettoriali distinti, crittografia e isolamento di rete. Deevi ha sottolineato che le sole istruzioni contenute nei prompt non costituiscono un sistema affidabile di autorizzazione, perché il modello può interpretarle erroneamente oppure ricevere contenuti costruiti per aggirarle. I controlli devono quindi essere applicati dai servizi che gestiscono l’accesso alle informazioni, indipendentemente dal comportamento linguistico dell’agente.
Anche la correttezza dei risultati deve essere verificata lungo più passaggi. Gli errori possono comparire durante la generazione delle query, nella selezione e nel recupero dei dati oppure nella sintesi finale. Un chatbot commerciale che comunichi erroneamente uno sconto del 90%, per esempio, può creare conseguenze economiche immediate per l’impresa. Per contenere queste situazioni, Tiger Analytics limita le interrogazioni agli attributi presenti negli schemi dei database, conserva i riferimenti alle fonti, impone formati strutturati e introduce procedure alternative quando la generazione non soddisfa i requisiti. Le verifiche proseguono anche dopo la distribuzione attraverso golden dataset, validazione degli schemi, piccoli modelli per individuare contenuti tossici e modelli giudice che valutano un campione delle risposte. Il campionamento permette di limitare il costo delle verifiche, poiché sottoporre ogni interazione a un secondo modello aumenterebbe significativamente il consumo di risorse. L’analisi comprende inoltre segnali indiretti provenienti dagli utenti, come conversazioni abbandonate, grafici ignorati e valutazioni negative.
Il passaggio alla produzione richiede infine una revisione dell’architettura applicativa. Molti prototipi sono costruiti come sequenze monolitiche nelle quali ogni fase dipende dal completamento della precedente. Nei sistemi aziendali, invece, migliaia di richieste al minuto possono attivare contemporaneamente più chiamate ai modelli, interrogazioni ai database e strumenti esterni, moltiplicando i possibili punti di errore. La progettazione deve pertanto considerare gestione della concorrenza, isolamento delle operazioni, controllo della latenza, disponibilità dei servizi e costi di inferenza, oltre alle capacità linguistiche del modello. Le esperienze descritte da Tiger Analytics mostrano che la qualità osservata durante una dimostrazione non può essere utilizzata come unica misura dell’idoneità alla produzione: ogni distribuzione richiede valutazioni continue, controlli applicativi indipendenti e un’infrastruttura capace di adattarsi ai cambiamenti dei dati e dei carichi di lavoro.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)