
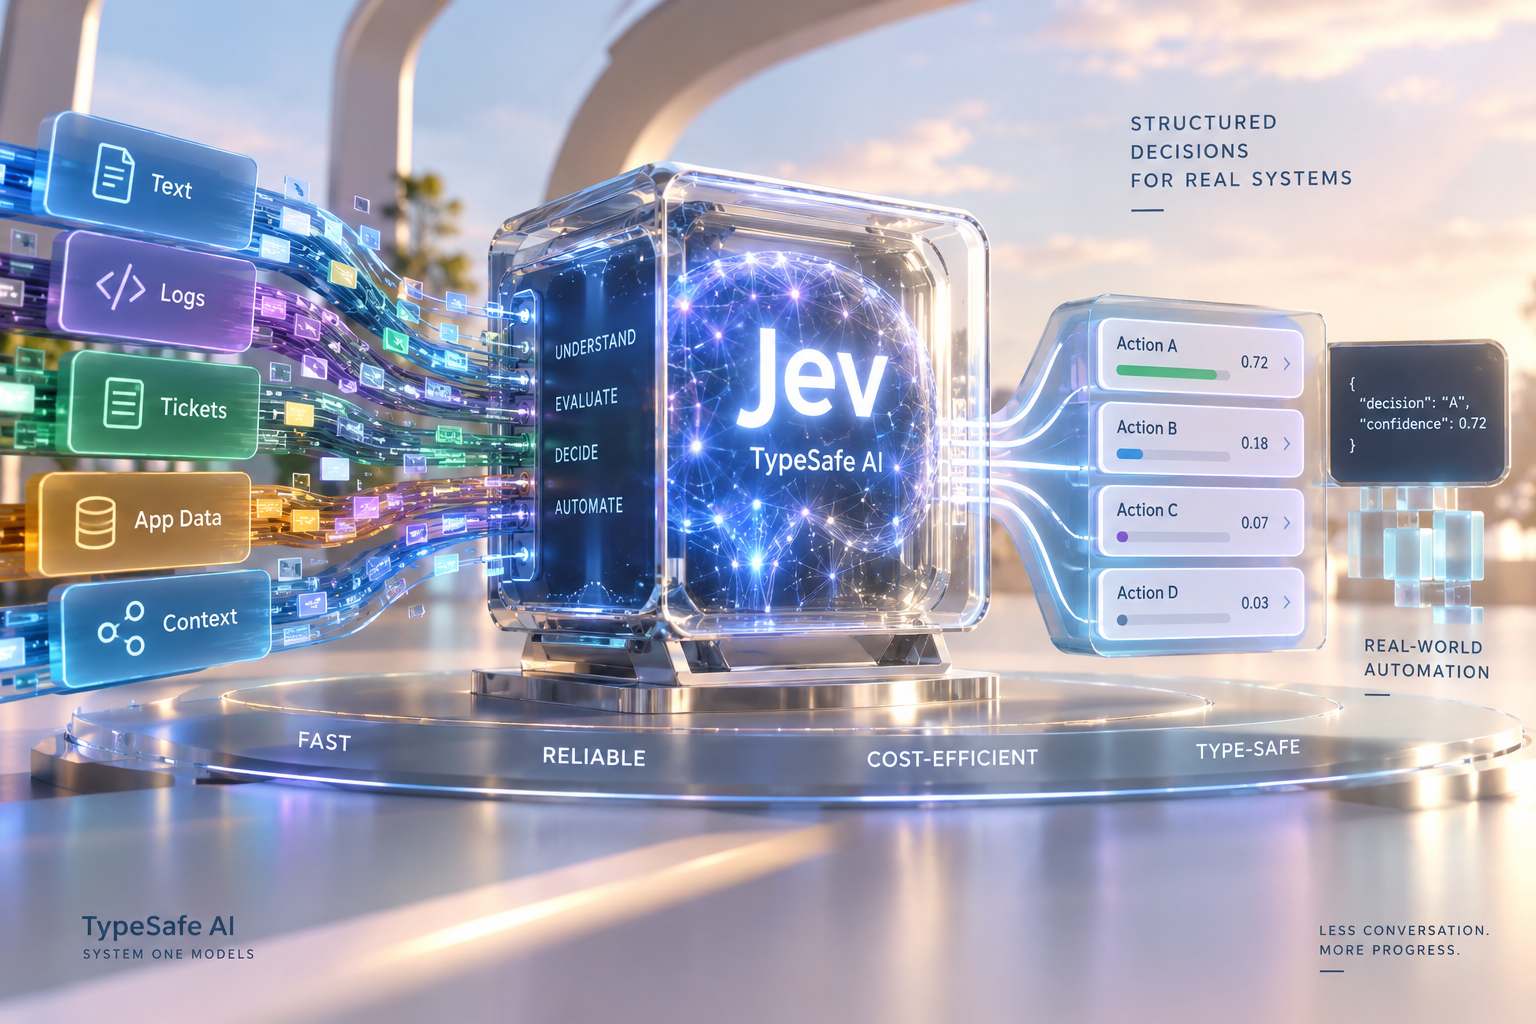
Il modello di intelligenza artificiale Jev, sviluppato dalla startup statunitense TypeSafe AI e presentato il 15 settembre 2026, è al centro di una controversia relativa alla paternità delle tecnologie utilizzate per produrre decisioni probabilistiche senza generare risposte testuali. Nandakishor Mukkunnoth, fondatore di ConvAI Innovations, sostiene di aver sviluppato un’architettura concettualmente analoga circa un anno prima della presentazione commerciale di Jev e di averne pubblicato i principi attraverso precedenti lavori scientifici. Il ricercatore ha espresso le proprie contestazioni in un intervento pubblicato sul suo blog dopo il lancio del modello TypeSafe, richiamando in particolare SalesRLAgent, un progetto descritto in un documento scientifico diffuso il 30 marzo 2025 insieme ai pesi del modello e al relativo dataset. Mukkunnoth ha inoltre indicato un secondo lavoro, pubblicato nel settembre dello stesso anno, che a suo giudizio presenta corrispondenze ancora più strette con le modalità operative successivamente attribuite a Jev. La contestazione riguarda la precedenza nello sviluppo di determinate idee e soluzioni architetturali, ma non è accompagnata da una dimostrazione indipendente di plagio o da una verifica tecnica pubblica che accerti l’effettiva derivazione del modello TypeSafe dai lavori di ConvAI Innovations.
La differenza principale tra i due progetti riguarda l’ambito applicativo nel quale sono state sviluppate e distribuite le rispettive tecnologie. SalesRLAgent era stato progettato per affrontare problemi decisionali appartenenti a settori specifici, attraverso un modello capace di elaborare le informazioni disponibili e stimare la probabilità delle possibili risposte. Secondo Mukkunnoth, proprio questa specializzazione avrebbe contribuito a limitare l’attenzione ricevuta dalla sua ricerca, nonostante la pubblicazione anticipata del materiale tecnico e dei componenti necessari alla riproduzione degli esperimenti. TypeSafe AI ha invece presentato Jev come motore decisionale general-purpose, accessibile attraverso un servizio commerciale dotato di API, documentazione, strumenti di sviluppo, infrastruttura di esecuzione e condizioni economiche definite. La differenza fra una ricerca pubblicata e una piattaforma distribuita commercialmente rappresenta quindi un elemento centrale nella ricostruzione della vicenda: il ricercatore rivendica la precedenza delle idee tecniche, mentre TypeSafe ha realizzato un prodotto destinato all’integrazione diretta nelle applicazioni aziendali. La precedente pubblicazione di un’architettura simile non dimostra automaticamente che un sistema successivo ne abbia copiato il codice, i pesi o le procedure di addestramento.
Jev appartiene alla categoria dei modelli decisionali, sistemi che ricevono dati contestuali e domande strutturate e restituiscono risultati probabilistici associati a opzioni prestabilite. A differenza dei tradizionali large language model utilizzati per produrre contenuti in linguaggio naturale, il modello non deve generare una risposta attraverso una lunga sequenza autoregressiva di token. L’applicazione può sottoporgli, per esempio, la cronologia degli acquisti di un cliente e chiedere di stimare la probabilità di un reso oppure di identificare quale prodotto sia oggetto di una richiesta. Il risultato viene restituito come valore numerico o distribuzione di probabilità, direttamente interpretabile dal software chiamante. Gli sviluppatori possono collegare tali valori alle istruzioni condizionali dei programmi per selezionare procedure differenti senza dover analizzare una risposta discorsiva, estrarre informazioni da testo libero o mantenere una cronologia conversazionale estesa. TypeSafe descrive Jev come un sistema basato su architettura Transformer, con un meccanismo di campionamento parallelo e un metodo di addestramento denominato Reinforcement Learning for Calibrated Decisions (RLCD), orientato alla produzione di probabilità coerenti con la frequenza effettiva degli eventi osservati.
L’eliminazione della generazione testuale può ridurre la quantità di elaborazione necessaria per determinate operazioni, poiché il modello restituisce direttamente le informazioni richieste anziché costruire una spiegazione parola per parola. Questo approccio permette di contenere la latenza e i costi nei processi che richiedono numerose classificazioni o valutazioni ripetitive, come l’instradamento delle richieste, la selezione di azioni, l’identificazione di categorie o la valutazione di condizioni operative. La produzione di risultati strutturati riduce inoltre alcuni problemi tipici dell’integrazione software dei modelli generativi, come la restituzione di formati non validi o di informazioni aggiuntive non richieste. Le probabilità prodotte non garantiscono tuttavia automaticamente l’accuratezza delle decisioni: rimangono necessarie verifiche sulla calibrazione del modello, sulla qualità dei dati di ingresso e sulle prestazioni rispetto alle diverse distribuzioni operative. Anche la riduzione dei fenomeni comunemente identificati come allucinazioni deve essere interpretata nel contesto specifico delle risposte probabilistiche, che possono comunque essere inesatte o insufficientemente affidabili.
La presentazione commerciale di Jev è stata seguita dalla diffusione di diversi servizi e progetti con caratteristiche operative analoghe. Microsoft ha introdotto Decision, OpenAI ha presentato Decisions API e Pastino ha sviluppato Glide, mentre Cloudflare e Perplexity hanno distribuito rispettivamente Clef e Decider. Queste soluzioni condividono, con differenze nelle architetture e nelle funzionalità, l’obiettivo di produrre valutazioni strutturate utilizzabili direttamente dalle applicazioni. Una parte dei modelli concorrenti è stata realizzata adattando sistemi linguistici relativamente compatti, ai quali vengono aggiunte componenti per interpretare domande, vincolare le possibili risposte e calcolare le relative probabilità. Fra le basi tecnologiche impiegate da alcuni progetti figurano anche i modelli open source Qwen di Alibaba. La somiglianza delle interfacce di utilizzo non implica necessariamente l’identità delle architetture sottostanti: modelli differenti possono essere addestrati per produrre lo stesso tipo di risultato, utilizzando tecniche, dati e parametri distinti.
In risposta alla controversia, Mukkunnoth ha reso disponibile Laya, un modello decisionale open source progettato per funzionare su infrastrutture hardware controllate direttamente dagli utilizzatori. Il sistema supporta più lingue e restituisce risultati probabilistici attraverso un’interfaccia operativa simile a quella dei modelli decisionali commerciali. La principale differenza architetturale dichiarata riguarda l’impiego di una base encoder-only appartenente alla famiglia BERT, anziché l’adattamento di modelli linguistici generativi come Qwen. Le architetture encoder-only elaborano le informazioni di ingresso per costruire rappresentazioni contestuali utilizzabili nelle attività di classificazione e stima, senza richiedere necessariamente un decoder autoregressivo per la produzione di testo. Questa configurazione consente di realizzare sistemi specializzati nella valutazione di domande e opzioni, distinguendoli dalle architetture progettate principalmente per generare sequenze linguistiche. La possibilità di eseguire Laya localmente permette inoltre agli sviluppatori di controllare direttamente l’ambiente di inferenza e di esaminare il comportamento del modello senza dipendere esclusivamente da un servizio remoto.
La documentazione pubblica disponibile non permette attualmente di stabilire un rapporto diretto di derivazione tecnica tra SalesRLAgent e Jev. TypeSafe AI non ha pubblicato integralmente i pesi, la configurazione del modello e le procedure di addestramento necessarie per un confronto approfondito con i lavori precedenti. Le dichiarazioni di Mukkunnoth documentano quindi una rivendicazione di priorità scientifica che richiederebbe un’analisi comparativa delle rispettive architetture, dei metodi di apprendimento e delle implementazioni. L’esistenza di lavori antecedenti sul calcolo di decisioni probabilistiche rappresenta un elemento verificabile attraverso le pubblicazioni richiamate dal ricercatore, mentre l’eventuale utilizzo non autorizzato delle sue specifiche soluzioni da parte di TypeSafe rimane, allo stato attuale, un’ipotesi non dimostrata.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)