
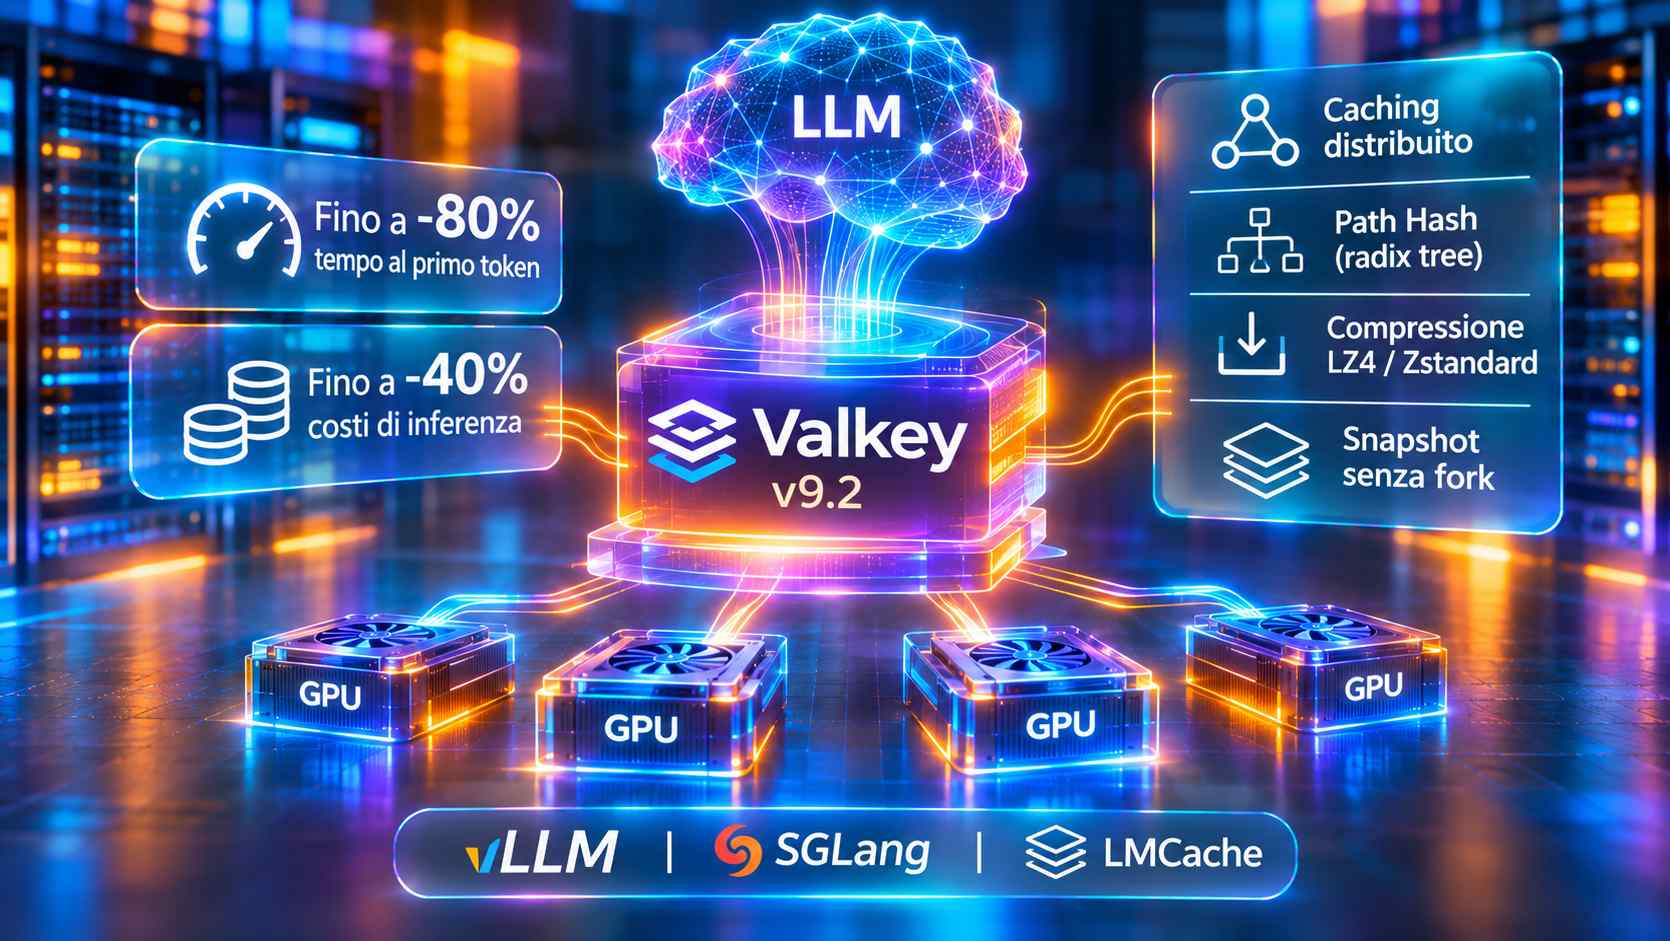
Il progetto open source Valkey ha rilasciato la versione 9.2 del proprio sistema di archiviazione dati in memoria, accompagnando l’aggiornamento con una soluzione di caching distribuito destinata alle infrastrutture di inferenza dei modelli linguistici. La tecnologia permette di condividere tra differenti nodi computazionali le rappresentazioni intermedie generate durante l’elaborazione dei prompt, riducendo la necessità di ripetere operazioni già effettuate dalle GPU. Secondo le stime diffuse dal progetto, l’implementazione della cache condivisa può consentire, in condizioni favorevoli, una riduzione dei costi di inferenza fino al 40% e una diminuzione fino all’80% del tempo necessario alla generazione del primo token della risposta, utilizzando le infrastrutture di accelerazione hardware già disponibili.
Il sistema interviene sulla gestione della KV cache, costituita dai tensori key e value prodotti dai meccanismi di attenzione dei modelli linguistici durante l’elaborazione delle sequenze di token. Nella fase denominata prefill, il modello elabora le istruzioni, la cronologia della conversazione e gli eventuali dati aggiuntivi presenti nel prompt prima di iniziare la generazione della risposta. Quando una parte significativa del contesto viene riproposta nelle richieste successive, il riutilizzo dei tensori precedentemente calcolati permette di limitare la ripetizione delle operazioni computazionali. Valkey introduce un livello di caching condiviso tra i nodi di inferenza, complementare alla memoria delle GPU e alla memoria dei server host, attraverso il quale è possibile recuperare informazioni precedentemente rimosse dalle cache locali. L’integrazione con i motori di inferenza vLLM e SGLang avviene mediante LMCache, senza richiedere necessariamente modifiche al codice applicativo.
La versione 9.2 comprende inoltre Path Hash, una struttura dati basata su radix tree che supporta la ricerca di corrispondenze esatte, l’identificazione del prefisso comune più lungo e l’esplorazione delle sequenze gerarchiche. La struttura può essere utilizzata come indice per individuare le porzioni di contesto già elaborate e la posizione delle relative informazioni all’interno dell’infrastruttura di caching. Multiverse Computing ha dichiarato di aver incrementato del 50% il numero di richieste gestite utilizzando le medesime GPU, mantenendo l’obiettivo di un secondo per il tempo mediano di generazione del primo token. La latenza mediana è diminuita del 23% in condizioni di traffico ordinario e del 95% durante i picchi di utilizzo.
Un ulteriore benchmark ha utilizzato cento conversazioni simultanee, con contesti compresi tra 12.000 e 28.000 token e un carico di otto richieste al secondo. L’infrastruttura comprendeva due nodi dotati ciascuno di otto GPU NVIDIA H100, il modello Llama 3.1 70B, vLLM, LMCache e un cluster Valkey distribuito su tre shard. La configurazione ha registrato un incremento di circa il 25% delle richieste elaborate e del 28% dei token di output, con un costo aggiuntivo della cache equivalente a circa il 15% della spesa per le GPU. I benefici risultano invece limitati quando il contesto elaborato è già interamente gestibile attraverso le memorie locali o quando le richieste non presentano porzioni testuali riutilizzabili.
L’aggiornamento introduce anche snapshot senza fork, realizzati attraverso thread in background, e meccanismi di compressione LZ4 e Zstandard per ridurre l’occupazione delle risorse durante la replicazione. In una prova condotta su tre milioni di chiavi, la compressione LZ4 ha ridotto del 52% la banda utilizzata, con un impatto sul throughput inferiore all’1%. Le strutture sorted set di grandi dimensioni adottano inoltre alberi B+ in sostituzione delle skiplist, con riduzioni dell’occupazione di memoria per elemento comprese tra il 36% e il 43% nelle configurazioni esaminate. Completano il rilascio nuovi strumenti per l’identificazione delle hot key, la gestione dei ruoli di accesso, la prioritizzazione delle comunicazioni interne al cluster e il controllo del traffico di scrittura durante i ritardi di replicazione.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)