
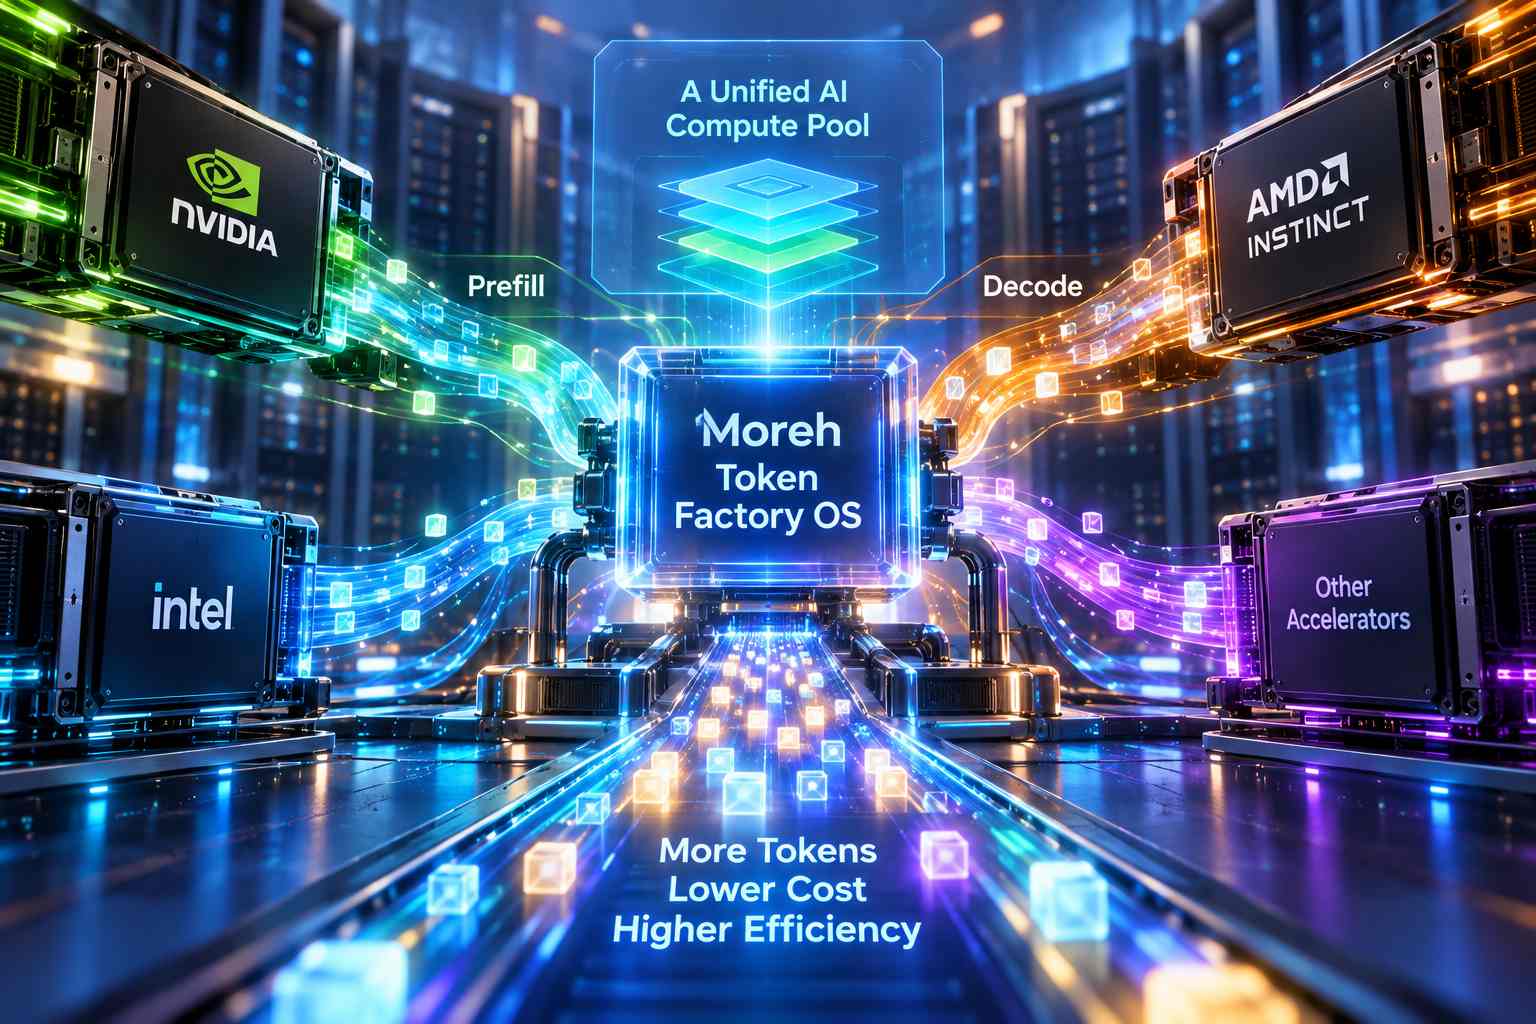
Moreh ha presentato un nuovo concetto di infrastruttura software per data center AI denominato Token Factory OS, progettato per utilizzare acceleratori eterogenei come se appartenessero a un unico pool di risorse. La proposta è stata illustrata durante AI Infra Summit 2026, in programma dal 15 al 17 settembre al Santa Clara Convention Center, insieme a una tecnologia di inferenza distribuita capace di coordinare acceleratori prodotti da vendor differenti. L’obiettivo è aumentare l’efficienza complessiva nella produzione di token senza vincolare il data center a una specifica GPU o a un singolo motore di inferenza.
Token Factory OS è pensato per selezionare il percorso di inferenza più adatto in funzione delle caratteristiche del modello, del tipo di richiesta e delle capacità di calcolo offerte dai diversi acceleratori disponibili nell’infrastruttura. Invece di assegnare l’intero processo di inferenza a una singola tipologia di GPU, il sistema può distribuire le diverse fasi sui dispositivi più adatti, collegando tra loro calcolo e trasferimento dei dati. L’idea è quindi utilizzare l’intero data center come una risorsa coordinata, ottimizzando il numero di token prodotti dall’infrastruttura nel suo complesso anziché concentrarsi esclusivamente sulle prestazioni nominali di un singolo acceleratore.
Uno dei principali componenti utilizzati per realizzare questo modello è il framework di inferenza MoAI. Moreh lo ha progettato per trattare acceleratori differenti come membri dello stesso cluster e distribuire le operazioni del processo di inferenza in base alle caratteristiche di ciascun dispositivo. Il framework cerca quindi di evitare che le prestazioni dell’intero sistema siano determinate esclusivamente dall’hardware più potente o da un’unica architettura, permettendo invece di combinare acceleratori diversi attraverso il livello software.
Moreh ha mostrato anche un caso concreto di inferenza eterogenea nel quale NVIDIA H100 e AMD Instinct MI300X vengono utilizzate all’interno dello stesso sistema. L’elaborazione del prompt, cioè la fase di prefill, viene affidata alle H100, mentre la generazione progressiva della risposta, o decode, viene eseguita sulle MI300X. Il software di inferenza distribuita di Moreh gestisce il collegamento dei dati tra le due tipologie di acceleratore, consentendo alle fasi del processo di essere eseguite su hardware differente pur rimanendo parte della stessa richiesta.
Nei test presentati dall’azienda, questa configurazione ha prodotto un throughput fino a 1,67 volte superiore rispetto a una configurazione equivalente basata su acceleratori dello stesso vendor. Il risultato viene utilizzato da Moreh per mostrare che separare prefill e decode e assegnare ciascuna fase al tipo di acceleratore considerato più adatto può aumentare l’efficienza complessiva dell’infrastruttura. Non si tratta quindi di far lavorare più GPU dello stesso tipo in parallelo, ma di suddividere funzionalmente il workload tra architetture differenti e coordinare il flusso dei dati attraverso il software.
La fase di prefill e quella di decode presentano infatti caratteristiche computazionali differenti. Nel prefill il modello elabora il contesto fornito inizialmente dall’utente e può sfruttare un’elevata capacità di calcolo parallelo, mentre durante il decode genera progressivamente i nuovi token della risposta. Moreh applica questa separazione per creare una struttura di serving nella quale hardware differenti possono specializzarsi sulle fasi in cui risultano più efficienti, invece di utilizzare lo stesso acceleratore per l’intero ciclo di generazione.
Il modello Token Factory OS amplia questa logica dal singolo cluster all’intero data center. L’obiettivo di Moreh è poter aggregare acceleratori NVIDIA, AMD e potenzialmente altre architetture in un unico livello operativo, lasciando al software il compito di decidere dove eseguire i diversi workload. In questa configurazione la disponibilità di hardware eterogeneo non viene considerata un problema di compatibilità da eliminare, ma una caratteristica che può essere sfruttata per adattare l’inferenza alle risorse disponibili.
Durante AI Infra Summit 2026, il CEO di Moreh Gangwon Cho ha descritto questa trasformazione come il passaggio da data center che forniscono capacità GPU a infrastrutture che producono direttamente token. Nel modello tradizionale il valore di un data center AI viene spesso collegato al numero e alla capacità delle GPU installate, mentre secondo Moreh la metrica più rilevante per le infrastrutture dedicate all’inferenza sta diventando la quantità di token che può essere prodotta a un determinato costo.
Questo cambiamento modifica anche il modo in cui viene considerata l’efficienza dell’hardware. Invece di valutare soltanto le prestazioni assolute di una singola GPU, Token Factory OS punta a considerare quanto efficacemente acceleratori diversi possano essere combinati per ridurre il costo di produzione dei token. Il livello software assume quindi un ruolo centrale nel determinare quale hardware utilizzare, come distribuire i workload e come coordinare le diverse fasi dell’inferenza.
La proposta di Moreh si inserisce in un contesto in cui i data center AI stanno iniziando a utilizzare un numero crescente di acceleratori con architetture differenti. Le infrastrutture possono comprendere GPU NVIDIA e AMD, oltre ad altri acceleratori specializzati, ma la gestione di questi dispositivi tende normalmente a rimanere separata a causa delle differenze tra stack software, runtime e sistemi di comunicazione. Token Factory OS cerca invece di introdurre un livello di astrazione che consenta di impiegare queste risorse come un’unica capacità computazionale distribuita.
Moreh punta quindi a spostare l’ottimizzazione dal singolo dispositivo all’intero processo di serving. Attraverso MoAI e il modello Token Factory OS, il sistema può scegliere quale acceleratore utilizzare per una determinata fase, distribuire le operazioni tra hardware differenti e coordinare il trasferimento dei dati necessario a completare la generazione. Il risultato atteso è un’infrastruttura nella quale la produttività viene misurata principalmente attraverso il throughput dei token e il relativo costo, indipendentemente dal produttore delle singole GPU impiegate.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)