
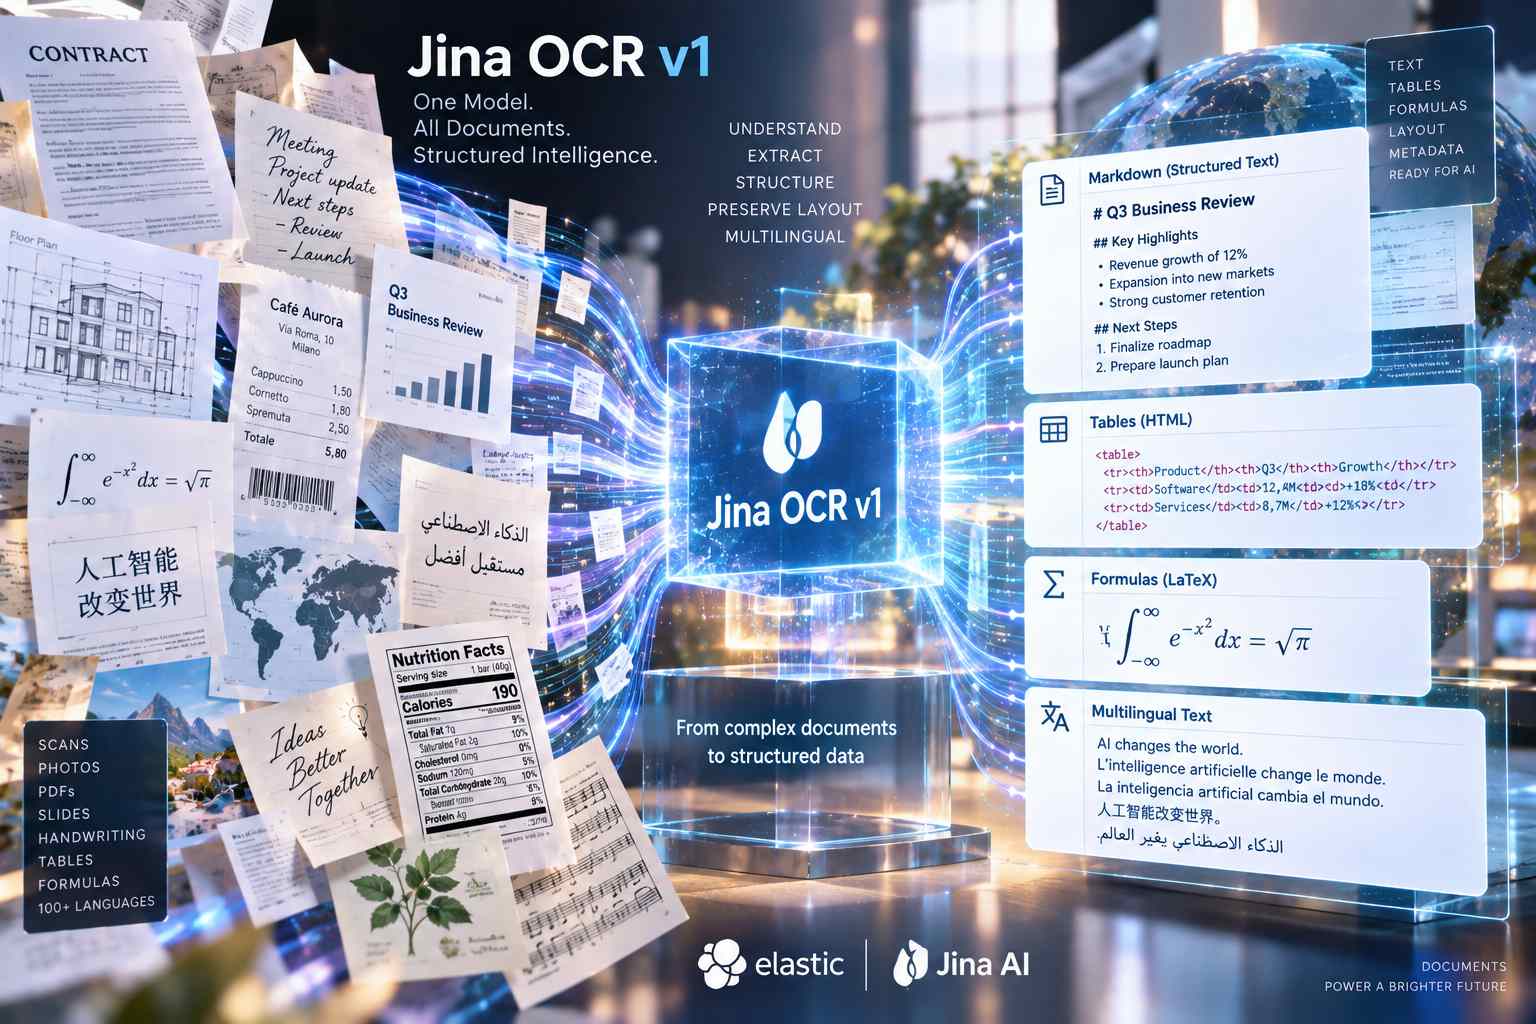
Elastic ha presentato Jina OCR v1, un nuovo modello vision-language sviluppato da Jina AI per trasformare documenti visivi complessi in testo strutturato attraverso un unico passaggio di elaborazione. Il sistema è stato progettato per sostituire pipeline OCR tradizionali composte da più modelli e programmi separati, nelle quali il documento viene prima segmentato, poi classificato nelle sue diverse aree, successivamente sottoposto al riconoscimento del testo e infine ricostruito nel formato di output. Jina OCR v1 affronta invece l’intero processo end-to-end, analizzando direttamente scansioni, fotografie di documenti, slide, note manoscritte e altre immagini ricche di testo e producendo un output coerente con l’ordine di lettura e con la struttura visuale originale. Il modello supporta oltre 100 lingue e gestisce nello stesso flusso testo stampato e manoscritto, layout articolati, tabelle e formule matematiche, con l’obiettivo di fornire dati già utilizzabili nei sistemi di indicizzazione, ricerca, retrieval e applicazioni agentiche.
Dal punto di vista architetturale, Jina OCR v1 utilizza un modello mixture-of-experts da 3,4 miliardi di parametri complessivi, ma ne attiva circa 570 milioni per ciascun token durante l’inferenza. La base deriva dall’architettura encoder-decoder di DeepSeek-OCR e integra un vision encoder che rappresenta una vista globale dell’immagine a 1024×1024 pixel attraverso 256 token visuali, affiancandola a un massimo di nove ritagli locali a maggiore risoluzione quando sono necessari dettagli aggiuntivi. Ogni tile supplementare può essere trasformato in un massimo di 100 token, permettendo al modello di conservare una rappresentazione compatta dell’intera pagina senza perdere completamente le informazioni presenti nelle aree più dense. Alla struttura di DeepSeek-OCR Jina aggiunge FastMTP, un sistema di speculative decoding che utilizza un blocco di previsione condiviso ricorsivamente su tre passaggi e verifica successivamente i token generati, mantenendo invariata la sequenza finale che sarebbe stata prodotta dal decoder principale. Questa soluzione riduce il carico computazionale durante l’inferenza e, secondo i test pubblicati da Jina AI, consente su una GPU NVIDIA L4 di raddoppiare la velocità di decoding rispetto alla generazione autoregressiva greedy tradizionale.
L’output viene prodotto principalmente come testo UTF-8 strutturato in Markdown, mantenendo titoli, sezioni, liste e ordine di lettura del documento, mentre le tabelle vengono restituite in HTML attraverso tag come table, th, tr e td e le formule matematiche vengono convertite in sintassi LaTeX compatibile con il pacchetto amsmath. Il modello può quindi essere utilizzato non soltanto per riconoscere caratteri, ma per recuperare direttamente la struttura logica di una pagina e trasformarla in formati adatti a elaborazioni successive. Questa capacità viene applicata anche a documenti con impaginazioni non lineari, report aziendali, slide di presentazione, etichette, packaging, biglietti da visita e materiali manoscritti, compresa la scrittura corsiva inglese. Per le lingue, Jina OCR v1 dichiara un supporto complessivo per 108 idiomi e include alfabeti latini modificati, greco, cirillico, sistemi di scrittura asiatici e mediorientali e documenti nei quali più lingue sono presenti contemporaneamente nella stessa pagina.
Sul piano delle prestazioni, Jina OCR v1 raggiunge un punteggio di 91,14 su OmniDocBench v1.6 e di 83,4 su olmOCR-Bench, risultato che lo rende il modello con il punteggio più elevato tra quelli con meno di 600 milioni di parametri attivi riportati nei test pubblicati da Elastic. Su OmniDocBench supera anche GPT-5.2 nelle metriche utilizzate per valutare accuratezza dei caratteri e correttezza dell’ordine di lettura, pur impiegando una quantità di parametri attivi sensibilmente inferiore rispetto ai grandi modelli general purpose. Nello stesso benchmark Jina OCR v1 raggiunge 91,14 punti contro 86,59 di GPT-5.2 e presenta errori inferiori nelle metriche TextEdit e ReadOrderEdit, mentre Ovis2.6-30B-A3B rimane davanti nelle valutazioni complessive ma utilizza quasi nove volte il numero totale di parametri e circa sei volte quelli attivi. Nel confronto riportato nel technical report, il modello raggiunge inoltre una produttività massima di 2,57 pagine al secondo, collocandosi sul punto di equilibrio tra accuratezza, dimensione e costo computazionale che Jina AI ha scelto come obiettivo principale del progetto.
Il training è stato costruito combinando corpora pubblici ripuliti e pagine sintetiche progettate per rafforzare il comportamento del modello sui casi più complessi. Dopo la fase iniziale di instruction alignment, Jina AI ha applicato un fine-tuning mirato alla robustezza sui documenti difficili e una fase di reinforcement learning basata su GRPO con dense verifiable rewards. Invece di assegnare un unico punteggio finale all’intero output, questo sistema utilizza controlli deterministici su formule, tabelle e struttura e assegna credito anche ai singoli elementi correttamente ricostruiti. In questo modo il modello riceve un segnale di apprendimento più granulare durante il post-training e può migliorare separatamente aspetti come la conservazione della struttura, la trascrizione delle formule matematiche e la ricostruzione delle tabelle. La combinazione tra compressed vision, decoder mixture-of-experts, speculative decoding e training con ricompense verificabili costituisce quindi la base tecnica con cui Jina OCR v1 tenta di ottenere prestazioni da modello di fascia alta mantenendo un costo di inferenza compatibile anche con GPU relativamente economiche.
Il modello può essere utilizzato attraverso diversi canali. Elastic lo rende disponibile tramite la propria inference API e l’Elastic Inference Service, utilizzando un endpoint chat_completions perché l’output viene restituito come flusso testuale, mentre Jina AI fornisce accesso diretto tramite API HTTP con un sistema a token prepagati e 10 milioni di token gratuiti per le prove iniziali. È possibile anche installarlo localmente tramite Jina On-Prem oppure scaricarne i pesi da Hugging Face: in questo caso la licenza CC BY-NC 4.0 consente utilizzi accademici e non commerciali, mentre per l’impiego commerciale on-premise è necessario rivolgersi a Elastic. Jina AI Reader API offre inoltre un percorso specifico per documenti PDF e pagine web, convertendoli automaticamente in immagini prima dell’elaborazione. Il modello nativo, infatti, non accetta direttamente PDF e richiede che le pagine siano prima trasformate in un formato immagine come PNG, mentre il supporto PDF nativo all’interno dei servizi Elastic è indicato come in sviluppo.
Jina OCR v1 è quindi posizionato da Elastic come componente iniziale delle pipeline di ingestione documentale, con il compito di trasformare materiale visuale non strutturato in testo e dati già utilizzabili da motori di ricerca, sistemi RAG e agenti AI. L’integrazione con Elasticsearch consente di far seguire al riconoscimento la fase di indicizzazione e retrieval senza introdurre necessariamente strumenti OCR esterni, mentre la disponibilità open-weight su Hugging Face permette anche implementazioni locali o in ambienti isolati. Il modello è stato pubblicato il 14 settembre 2026 e il technical report descrive esplicitamente l’obiettivo di offrire parsing documentale di qualità elevata su hardware a costo contenuto, mantenendo nello stesso modello funzioni che normalmente richiederebbero componenti separate per layout analysis, OCR multilingue, riconoscimento della scrittura, estrazione delle tabelle e conversione delle formule matematiche.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)