
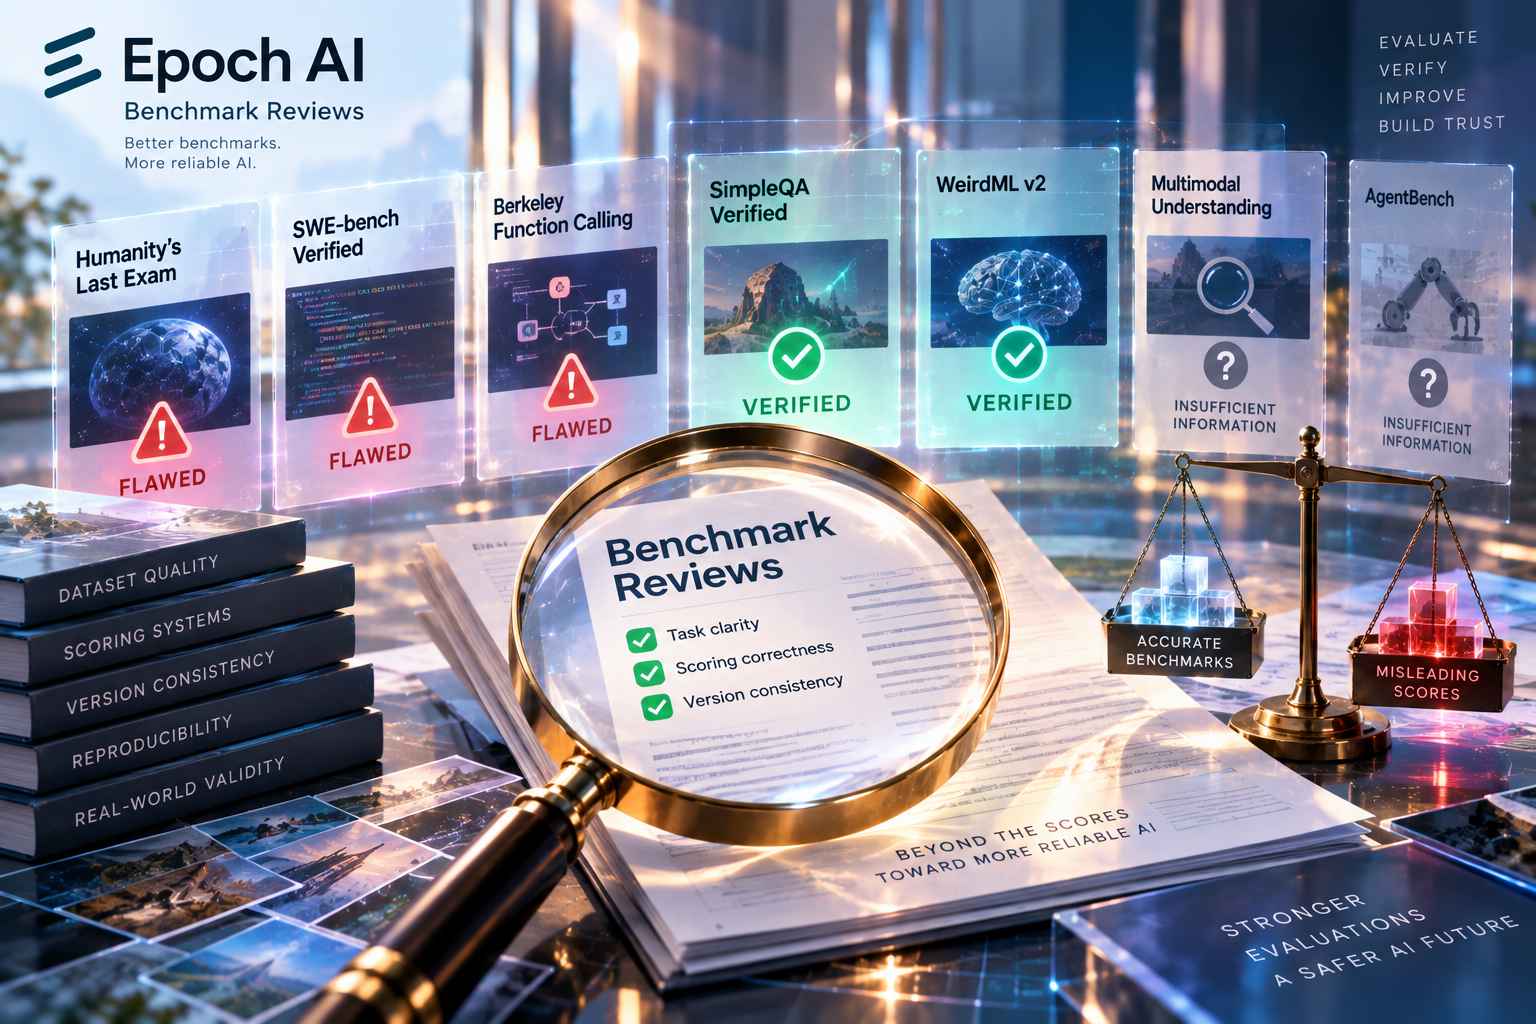
Epoch AI ha avviato Benchmark Reviews, un progetto dedicato alla verifica sistematica dei benchmark utilizzati per misurare e confrontare le prestazioni dei modelli di intelligenza artificiale, spostando quindi l’attenzione dai punteggi ottenuti dai sistemi AI all’affidabilità degli stessi strumenti impiegati per assegnarli. La prima analisi ha coinvolto 15 benchmark ampiamente utilizzati nel settore, compresi Humanity’s Last Exam (HLE), SWE-bench Verified e Berkeley Function Calling Leaderboard: soltanto quattro sono stati classificati come “Verified”, nove come “Flawed”, quindi caratterizzati da difetti sufficientemente rilevanti, mentre per altri due non erano disponibili informazioni sufficienti per arrivare a una valutazione definitiva. L’iniziativa nasce dalla constatazione che errori nelle risposte considerate corrette, problemi nei sistemi di scoring oppure differenze introdotte tra versioni successive dello stesso test possono alterare direttamente i risultati attribuiti ai modelli e, di conseguenza, compromettere anche l’affidabilità delle classifiche e dei confronti costruiti a partire da quei punteggi.
I problemi individuati riguardano infatti elementi molto concreti del funzionamento delle valutazioni. Nel Berkeley Function Calling Leaderboard, per esempio, una prova richiedeva di determinare l’ora corrente a Sydney: per rispondere correttamente sarebbe stato necessario utilizzare lo strumento messo a disposizione del modello, ma il riferimento utilizzato per la valutazione assegnava invece il punteggio alla risposta che rifiutava di utilizzare quello strumento. Anche Humanity’s Last Exam, benchmark progettato per sottoporre i sistemi AI a quesiti particolarmente difficili, conteneva casi nei quali la formulazione del problema e la risposta registrata come corretta non coincidevano. Errori di questo tipo non rappresentano soltanto imperfezioni formali, perché un modello può essere penalizzato nonostante abbia prodotto una risposta sostanzialmente corretta oppure, nella situazione opposta, ottenere punti grazie a una risposta che non soddisfa realmente il compito richiesto. Il punteggio finale può quindi finire per misurare almeno in parte il comportamento dello specifico sistema di valutazione anziché la capacità effettiva del modello sottoposto al test.
Epoch AI ha definito tre criteri principali per effettuare le verifiche: deve essere possibile determinare chiaramente quali siano i compiti sottoposti ai modelli e le regole utilizzate per valutarli, il sistema di scoring deve funzionare correttamente e i risultati prodotti dalle diverse versioni di uno stesso benchmark devono poter essere confrontati in maniera coerente. La classificazione “Flawed” viene assegnata quando gli errori capaci di modificare il punteggio interessano più del 20% dei problemi esaminati oppure quando viene individuato un difetto abbastanza grave da mettere in discussione il funzionamento complessivo del sistema di valutazione. La verifica non ha però portato a considerare inaffidabili tutti i benchmark analizzati: quattro, tra cui SimpleQA Verified e WeirdML v2, hanno soddisfatto i requisiti perché non sono stati individuati errori critici. Anche questi strumenti mantengono comunque alcuni limiti strutturali, come la possibile contaminazione derivante dalla pubblicazione dei problemi e quindi dalla potenziale esposizione delle risposte ai modelli, oppure una copertura limitata delle capacità che si intendono misurare.
La classificazione prodotta da Benchmark Reviews non deve inoltre essere interpretata come una certificazione definitiva dell’assenza o della presenza di ogni possibile problema. Quando durante la verifica viene raccolta una quantità di prove sufficiente per classificare un benchmark come difettoso, Epoch AI non prosegue necessariamente l’analisi fino a individuare tutte le anomalie presenti, quindi possono rimanere errori non ancora documentati. Allo stesso modo, la correzione dei problemi rilevati non trasferisce automaticamente la valutazione ottenuta a una nuova versione: ogni aggiornamento sostanziale deve essere sottoposto nuovamente al processo di verifica. Diventa quindi importante considerare non soltanto il nome del benchmark e il punteggio raggiunto da un modello, ma anche la versione esatta del test utilizzata, il metodo di scoring applicato, gli strumenti eventualmente messi a disposizione durante l’esecuzione, il tempo concesso e la relazione tra il risultato numerico finale e la capacità che quel test intende effettivamente misurare. La verifica dei benchmark introduce così un ulteriore livello di controllo nella valutazione dell’intelligenza artificiale: prima di utilizzare una classifica come misura comparativa delle prestazioni dei modelli, occorre stabilire quanto sia affidabile il sistema che ha generato quei punteggi.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)