
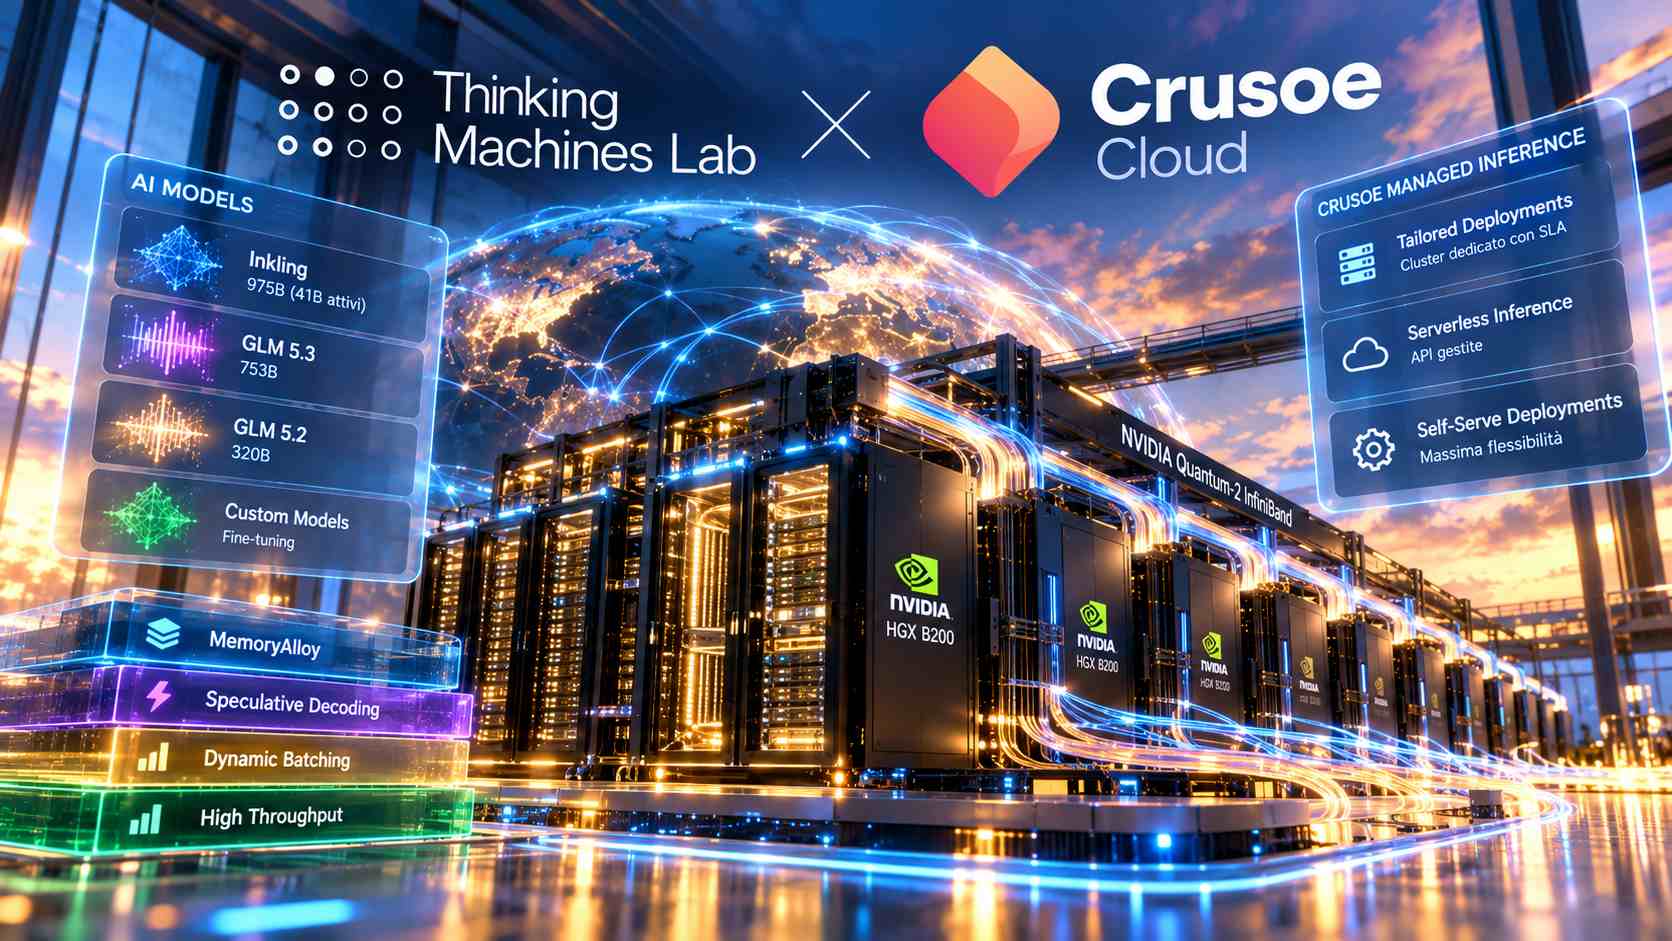
Thinking Machines Lab ha siglato con Crusoe un accordo annuale da 65 milioni di dollari per eseguire su Crusoe Cloud l’inferenza dei propri modelli open-weight e di altri sistemi utilizzati nei workload di produzione. L’infrastruttura verrà fornita attraverso Crusoe Managed Inference e sarà basata su un Tailored Deployment dedicato composto da sistemi NVIDIA HGX B200 collegati tramite networking NVIDIA Quantum-2 InfiniBand, configurazione progettata per sostenere elevati volumi di richieste mantenendo throughput, affidabilità e rapporto prezzo-prestazioni adatti a carichi di produzione su larga scala. Tra i workload indicati rientrano i modelli Inkling sviluppati da Thinking Machines Lab, GLM 5.2 e GLM 5.3 e varianti personalizzate sottoposte a fine-tuning. Crusoe gestirà direttamente il cluster e il relativo stack di inferenza, fornendo a Thinking Machines Lab un endpoint dedicato, sottoposto a benchmark e supportato da SLA, in modo che il laboratorio possa scalare l’erogazione dei modelli senza dover amministrare autonomamente tutta l’infrastruttura necessaria al serving. Secondo Myle Ott, responsabile ML Infrastructure di Thinking Machines Lab, la piattaforma ha permesso di passare rapidamente dalla fase di valutazione alla produzione rispettando i requisiti tecnici interni del laboratorio e offrendo costi e capacità sufficienti a destinare una quota maggiore delle risorse alla ricerca.
Crusoe Managed Inference mette a disposizione tre modalità principali di utilizzo. I Tailored Deployments rappresentano il livello con il maggiore grado di personalizzazione: il cliente porta il proprio modello e definisce i requisiti, mentre Crusoe realizza e gestisce un ambiente dedicato con ottimizzazioni specifiche dell’inferenza, benchmark e prestazioni garantite tramite SLA. Serverless Inference permette invece di utilizzare modelli open source attraverso API completamente gestite all’interno di Crusoe Intelligence Foundry con un modello di consumo basato sull’utilizzo, mentre i Self-Serve Deployments consentono agli sviluppatori di distribuire autonomamente modelli nella stessa piattaforma scegliendo configurazioni ottimizzate per throughput oppure per reattività. Il sistema supporta anche modelli personalizzati mediante Serverless Fine-Tuning e Intelligence Foundry funge da ambiente unico per individuare i modelli disponibili, generare chiavi API, monitorare le metriche di prestazione e distribuire endpoint gestiti. L’accordo con Thinking Machines Lab utilizza quindi il livello più personalizzato dell’offerta, con un cluster interamente dedicato invece di risorse condivise o endpoint serverless.
Uno dei componenti tecnici centrali dello stack di inferenza di Crusoe è MemoryAlloy, un fabric di memoria nativo del cluster progettato per mantenere informazioni tra nodi differenti e indirizzare le richieste in modo da evitare la ripetizione non necessaria delle operazioni di prefill. Nelle pipeline di inferenza dei grandi modelli linguistici, la fase di prefill elabora l’intero contesto fornito prima che inizi la generazione dei nuovi token e può diventare particolarmente costosa quando vengono utilizzati prompt lunghi o quando porzioni dello stesso contesto ricorrono tra richieste differenti. MemoryAlloy punta a riutilizzare queste informazioni tra i nodi del cluster e viene combinato con tecniche come speculative decoding e dynamic batching per aumentare la quantità di richieste processabili contemporaneamente e ridurre il tempo necessario prima della generazione del primo token. Crusoe dichiara fino a 9,9 volte un time-to-first-token più rapido e fino a cinque volte un throughput superiore rispetto a una configurazione basata su vLLM utilizzata come riferimento nei propri benchmark con Llama 3.3 70B su un deployment composto da quattro nodi. Questi numeri derivano da benchmark realizzati dall’azienda e dipendono quindi dal modello, dalla configurazione hardware e dal tipo di workload, ma spiegano perché Thinking Machines Lab abbia scelto un’infrastruttura espressamente ottimizzata per l’inferenza invece di utilizzare semplicemente capacità GPU general purpose.
Tra i modelli destinati al nuovo cluster figura Inkling, presentato da Thinking Machines Lab il 15 luglio 2026 come transformer Mixture-of-Experts open-weight con 975 miliardi di parametri complessivi e 41 miliardi di parametri attivi durante l’inferenza. Il modello supporta una context window fino a un milione di token ed è stato pre-addestrato su circa 45.000 miliardi di token comprendenti testo, immagini, audio e video, rappresentando il primo grande training run completato dal laboratorio su sistemi NVIDIA GB300 NVL72. Accanto alla versione principale è stato presentato Inkling-Small, modello MoE da 276 miliardi di parametri complessivi e 12 miliardi attivi, progettato per offrire un diverso compromesso tra capacità, velocità e costo dell’inferenza. I pesi completi di Inkling sono disponibili su Hugging Face sia nel checkpoint originale sia in formato NVFP4 ottimizzato per l’esecuzione sulle GPU NVIDIA Blackwell, mentre il modello può essere sottoposto a fine-tuning tramite Tinker, la piattaforma di personalizzazione sviluppata da Thinking Machines Lab, con opzioni di contesto da 64.000 e 256.000 token. Portare un modello MoE di queste dimensioni in produzione richiede un’infrastruttura capace non soltanto di ospitare i pesi, ma anche di coordinare efficientemente memoria, comunicazioni tra GPU e distribuzione dei token tra gli esperti, rendendo il networking InfiniBand e le ottimizzazioni del serving componenti importanti quanto la capacità computazionale pura.
L’accordo comprende inoltre GLM 5.2 e GLM 5.3 tra i workload di produzione gestiti dal servizio. Nel catalogo Managed Inference di Crusoe, GLM 5.3 di Z.ai viene indicato come modello da 753 miliardi di parametri con context window fino a un milione di token, mentre GLM 5.3 Flash dispone di 320 miliardi di parametri; entrambi possono essere utilizzati anche tramite Serverless Inference. La presenza contemporanea di modelli proprietari di Thinking Machines Lab, modelli di terze parti e versioni sottoposte a fine-tuning mostra che il contratto non riguarda un singolo checkpoint ma un’infrastruttura destinata a supportare un insieme eterogeneo di modelli e carichi di lavoro nel tempo. Per Thinking Machines Lab questo consente di separare maggiormente le attività di ricerca e sviluppo dalla gestione operativa dell’inferenza, mentre Crusoe assume responsabilità su deployment, manutenzione, ottimizzazione e disponibilità del servizio. Erwan Menard, SVP Product Management di Crusoe Cloud, ha indicato proprio questa combinazione di infrastruttura, serving e strumenti per il ciclo di vita dei modelli come uno degli obiettivi principali del servizio Managed Inference.
Le due aziende prevedono inoltre di ampliare la collaborazione verso l’inferenza batch destinata alla produzione di dati sintetici su larga scala. Questo tipo di workload utilizza i modelli già addestrati per generare grandi quantità di esempi che possono essere impiegati successivamente per fine-tuning, reinforcement learning, valutazioni o nuovi cicli di training, trasformando quindi l’infrastruttura di inferenza in una componente diretta del processo di ricerca. In questo scenario lo stesso cluster può essere utilizzato non soltanto per rispondere alle richieste degli utenti finali, ma anche per produrre i dati necessari a migliorare le generazioni successive dei modelli. L’accordo rappresenta inoltre un contratto particolarmente rilevante per Crusoe: la società dichiara che Thinking Machines Lab si aggiunge a un portafoglio di clienti che ha portato Managed Inference oltre 100 milioni di dollari di annual recurring revenue contrattualizzato in meno di un anno dal lancio del servizio. Con 65 milioni di dollari annui attribuiti al solo accordo con Thinking Machines Lab, la partnership mostra anche quanto il costo dell’inferenza stia diventando una voce infrastrutturale autonoma per i laboratori che devono servire modelli da centinaia di miliardi di parametri su larga scala, distinta dagli investimenti necessari per il loro addestramento iniziale.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)