
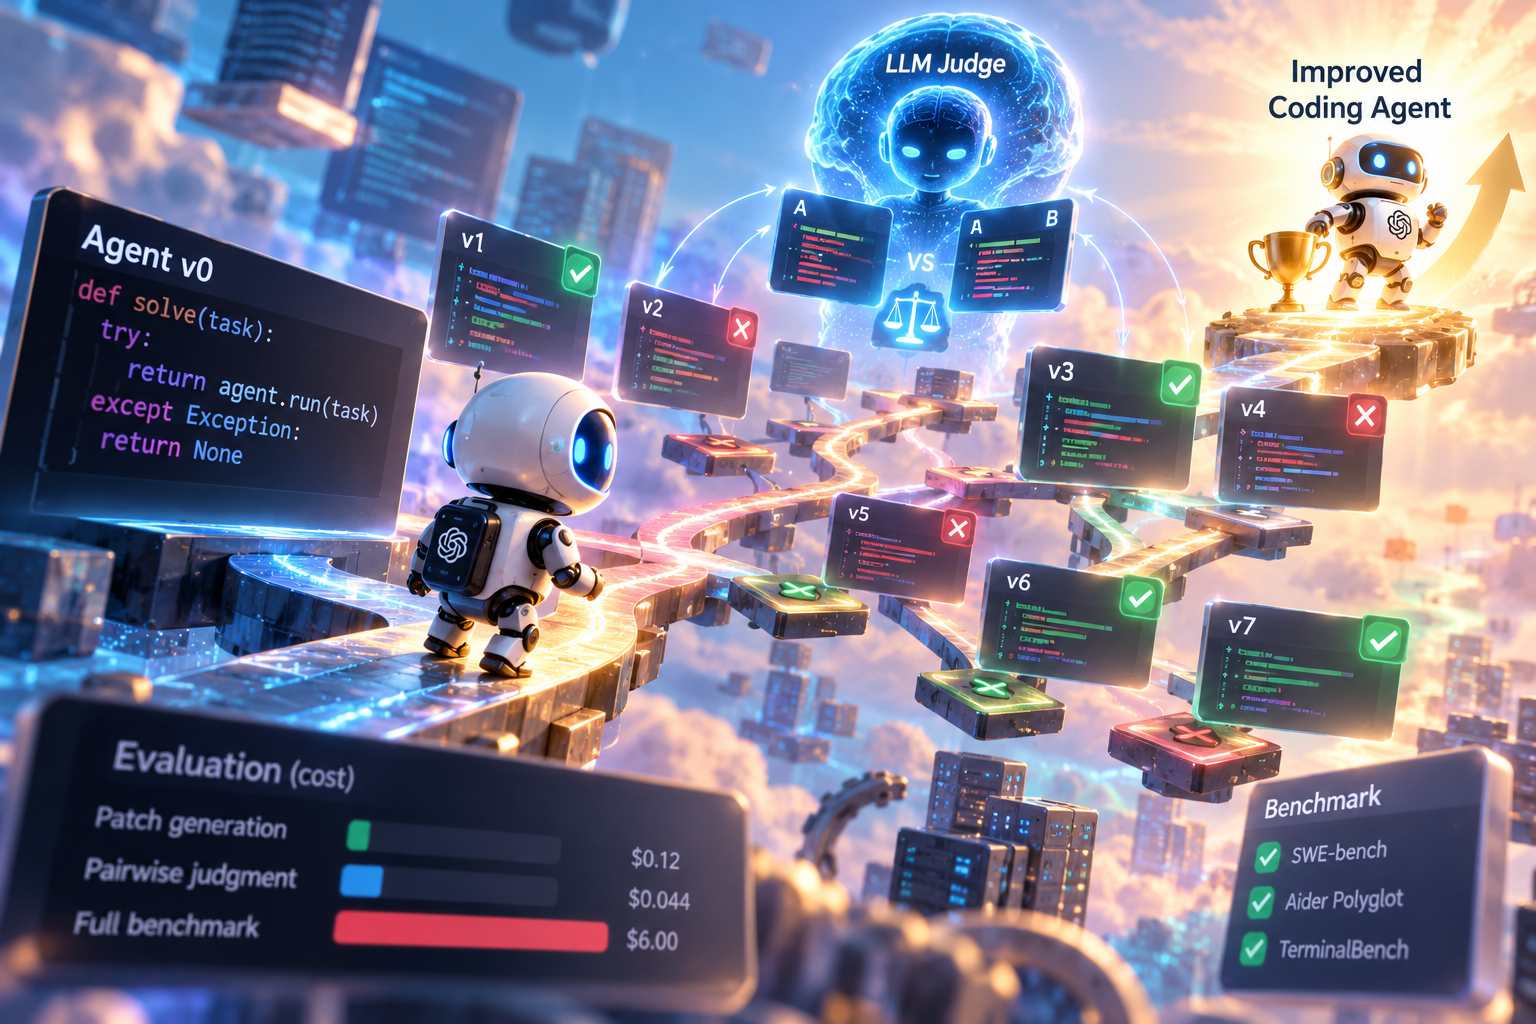
MIT e Sakana AI hanno sviluppato SIFT, acronimo di Recursive Self-Improvement via Fast Tree-search, un framework pensato per rendere più efficiente l’auto-miglioramento ricorsivo degli agenti di coding riducendo quello che i ricercatori definiscono “evaluation bottleneck”, cioè il costo necessario per verificare se una modifica apportata autonomamente da un agente produca davvero un miglioramento. I sistemi di questo tipo lavorano attraverso un ciclo nel quale un modello esamina il comportamento dell’agente, individua punti deboli, modifica prompt, strumenti, logica di controllo o codice dell’harness che avvolge il modello di base e genera quindi una nuova versione da sottoporre a valutazione. Il problema è che ogni modifica candidata deve normalmente essere testata su una quantità significativa di task reali per stabilire se sia effettivamente migliore della precedente, e proprio questa fase può diventare molto più costosa della generazione delle modifiche stesse. I ricercatori ricordano che approcci precedenti all’auto-evoluzione, come Darwin-Gödel Machine, SICA e Huxley-Gödel Machine, hanno mostrato che un agente può effettivamente migliorare la propria implementazione attraverso iterazioni successive, ma il processo di ricerca può richiedere migliaia di ore CPU e costi molto elevati: nel caso di valutazioni estese su SWE-bench, le stime citate nel lavoro arrivano oltre i 22.000 dollari. SIFT interviene quindi non sul modello di coding vero e proprio, che non viene riaddestrato a ogni iterazione, ma sul sistema che decide quali versioni dell’agente meritino di essere esplorate e valutate in profondità, cercando di conservare i benefici dell’auto-miglioramento senza sostenere il costo di un benchmark completo per ogni singola modifica.
Il meccanismo centrale consiste nell’utilizzare un secondo modello linguistico come giudice intermedio, sfruttando il fatto che confrontare direttamente due implementazioni è molto più economico che eseguire entrambe su decine o centinaia di problemi di programmazione. Quando viene generato un nuovo candidato, SIFT lo sottopone innanzitutto a un controllo leggero su quattro task semplici, utilizzato per eliminare rapidamente patch che abbiano danneggiato l’agente o che non siano in grado di completare neppure attività basilari. Se supera questo primo filtro, il candidato viene confrontato dal modello giudice con un massimo di dieci versioni già presenti nell’archivio e considerate competitive. Il giudice non vede i punteggi ottenuti nei benchmark e non conosce i risultati delle prove: riceve invece il codice completo dei due agenti oppure la sequenza delle differenze introdotte rispetto alla versione di partenza e deve stabilire quale dei due abbia maggiori probabilità di funzionare meglio. Ogni confronto produce una vittoria o una sconfitta e l’insieme di questi risultati viene aggregato attraverso un modello statistico Bradley-Terry, utilizzato per trasformare confronti pairwise rumorosi e incompleti in una graduatoria globale della forza relativa dei candidati. SIFT combina quindi questo ranking con i risultati delle valutazioni effettivamente già disponibili e con una penalità legata al numero di volte in cui uno stesso nodo dell’albero è stato scelto come progenitore, evitando che l’esplorazione converga troppo presto su una singola linea evolutiva apparentemente promettente. In questo modo le versioni con ranking migliore hanno maggiore probabilità di essere ulteriormente sviluppate e di entrare nella coda delle valutazioni costose, mentre i candidati meno promettenti possono essere abbandonati prima di consumare una quantità significativa di risorse computazionali.
Un’altra differenza importante rispetto agli approcci più semplici è l’architettura disaggregata e asincrona del processo di ricerca. Generazione di nuove patch, confronti del giudice e valutazioni sui benchmark non devono terminare in sequenza prima che l’iterazione successiva possa iniziare: mentre alcuni candidati stanno ancora eseguendo i test più costosi, il sistema può già utilizzare i segnali preliminari del giudice per espandere altre parti dell’albero. Questo evita che l’intero processo rimanga bloccato in attesa della conclusione di una singola valutazione e permette di utilizzare CPU e chiamate ai modelli in parallelo. I ricercatori hanno inoltre evidenziato una forte asimmetria nei costi delle diverse operazioni. Nei test riportati, una singola espansione dell’agente con GPT-5 mini costa circa 0,12 dollari e richiede 0,186 ore CPU, mentre un confronto pairwise effettuato da GPT-5.4 costa mediamente 0,044 dollari e circa 0,0042 ore CPU; una valutazione completa sul sottoinsieme Polyglot-50 utilizzando o3-mini arriva invece a circa 6 dollari e 2,6 ore CPU. Poiché un nuovo nodo viene confrontato al massimo con dieci candidati, l’intero round di giudizio rimane quindi di un ordine di grandezza più economico rispetto all’esecuzione completa del benchmark, fornendo un segnale sufficientemente rapido da guidare l’esplorazione prima che siano disponibili i risultati definitivi. SIFT non elimina le valutazioni reali, che restano necessarie per confermare i miglioramenti, ma le riserva ai nodi che hanno già superato filtri progressivamente più selettivi.
I risultati sul benchmark Aider Polyglot mostrano il vantaggio pratico del metodo. Polyglot comprende 225 task di programmazione distribuiti tra C++, Go, Rust, Java, JavaScript e Python; durante la ricerca SIFT utilizza prima il filtro di quattro task e poi un sottoinsieme fisso di 50 problemi, mantenendo l’intero benchmark da 225 task come valutazione finale separata. Con Qwen3-Coder-30B-A3B-Instruct come modello di coding e Qwen3-480B come modello di auto-miglioramento e giudice, l’agente passa durante l’evoluzione dal 16% al 38% sul sottoinsieme Polyglot-50, mentre il migliore discendente raggiunge il 31,1% sull’intero Polyglot-225. Questo risultato viene ottenuto attraverso 30 passaggi di espansione, con un costo API di 34,3 dollari, 224 ore CPU complessive e 6,71 ore di tempo reale, circa un decimo delle risorse CPU richieste dalla baseline DGM citata nel confronto. Nelle stesse condizioni, il sistema di partenza con Qwen3-Coder-30B raggiunge il 20%, SICA il 25,1%, DGM il 27,1% e HGM il 30,5%, mentre SIFT arriva al 31,1% utilizzando Qwen3-480B come giudice e al 32% utilizzando GPT-5.4. Nel test con o3-mini come modello di coding, l’agente di base ottiene invece il 14,2%, DGM raggiunge il 30,7%, mentre SIFT con GPT-5.4 come giudice sale al 35,1%; un’esecuzione di questo tipo completa la ricerca in meno di cinque ore, con 42 ore CPU e circa 150 dollari di crediti API nel test riportato, e ulteriori repliche hanno prodotto risultati compresi tra il 32% e il 35,6%.
Il framework mostra inoltre che le modifiche individuate durante l’auto-miglioramento non sono necessariamente legate al solo modello sul quale sono state scoperte. I ricercatori hanno preso gli harness ottimizzati da SIFT utilizzando o3-mini e Qwen3-30B e li hanno successivamente applicati a GPT-5 mini e GPT-5.4 mini, osservando miglioramenti consistenti anche sui nuovi modelli. Questo suggerisce che almeno una parte delle modifiche trovate riguarda proprietà generali della struttura agentica, come il modo in cui vengono organizzati i passaggi di ragionamento, l’utilizzo degli strumenti, il controllo degli errori o l’esecuzione dei test, invece di limitarsi a sfruttare caratteristiche specifiche del modello utilizzato durante la ricerca. SIFT è stato inoltre valutato su TerminalBench 2.1, benchmark composto da task eterogenei e di lungo periodo eseguiti all’interno di container terminali specifici per ciascun problema, utilizzando GPT-5 mini come coding model, GPT-5 per diagnosi e auto-miglioramento e GPT-5.4-high come giudice pairwise. Anche in questo caso il metodo confronta una ricerca guidata dal giudice con una variante priva di questo segnale intermedio, mantenendo un limite di 30 espansioni e un sottoinsieme fisso di 50 task durante l’esplorazione, così da verificare se la valutazione preliminare del giudice aiuti effettivamente a selezionare candidati che generalizzano su prove più ampie.
L’elemento distintivo di SIFT è quindi la separazione tra generazione delle modifiche, stima preliminare della loro qualità e verifica effettiva sui task. L’auto-miglioramento ricorsivo non viene affidato ciecamente al giudizio del modello linguistico: il modello giudice serve soltanto a stabilire dove concentrare le risorse, mentre i benchmark continuano a fornire il segnale reale utilizzato per verificare la qualità finale. Il sistema costruisce progressivamente un archivio di versioni dell’agente, mantiene più rami dell’albero contemporaneamente e utilizza il modello Bradley-Terry per trasformare una serie di confronti locali in un ranking globale, affiancandolo ai risultati empirici e a un meccanismo di esplorazione che penalizza le linee già visitate frequentemente. In questo modo MIT e Sakana AI cercano di affrontare uno dei problemi più concreti dei sistemi di auto-evoluzione: non tanto la capacità di produrre nuove versioni di un agente, che i modelli attuali possiedono già, quanto la capacità di esplorare abbastanza varianti da trovare quelle realmente migliori senza spendere la maggior parte delle risorse nella valutazione di modifiche destinate a essere scartate.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)