
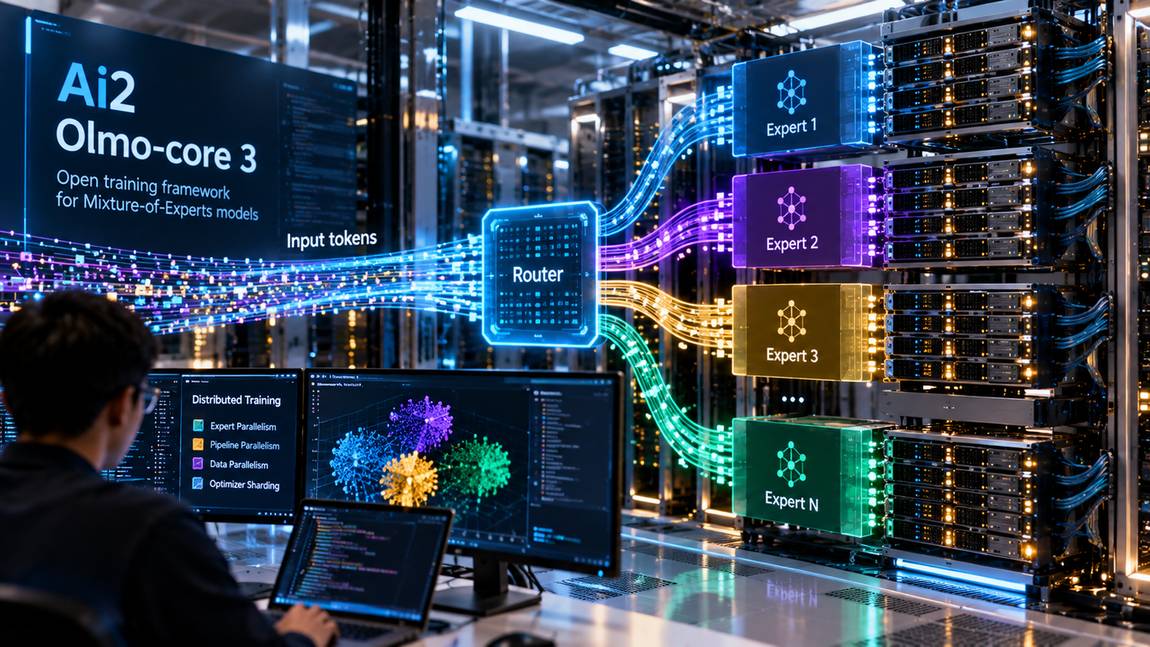
L’Allen Institute for Artificial Intelligence (Ai2) ha rilasciato Olmo-core 3, una nuova versione del framework open source utilizzato per sviluppare e addestrare modelli linguistici di grandi dimensioni. L’aggiornamento introduce un sistema di addestramento completamente riorganizzato per le architetture Mixture-of-Experts (MoE), nelle quali i parametri del modello sono distribuiti fra numerose reti specializzate e soltanto una parte di esse viene attivata durante l’elaborazione di ciascun token. L’obiettivo è aumentare il numero totale di parametri senza far crescere in proporzione il volume delle operazioni eseguite per ogni elemento di input, mantenendo al tempo stesso un utilizzo efficiente delle GPU. La tecnologia rappresenta un’evoluzione dell’infrastruttura utilizzata per la famiglia Olmo, dopo i precedenti esperimenti con OlmoE e i modelli densi della generazione Olmo 3. Il rilascio comprende il codice del sistema e la documentazione tecnica, permettendo ai ricercatori di intervenire direttamente sui meccanismi di parallelizzazione, instradamento degli esperti e gestione della memoria distribuita.
La modifica strutturale più importante riguarda il passaggio da una precedente implementazione basata su Fully Sharded Data Parallelism (FSDP) a un sistema che utilizza Distributed Data Parallelism (DDP) in combinazione con la distribuzione degli esperti. Nella configurazione MoE precedente, l’elaborazione di piccoli batch comportava ripetute operazioni di raccolta e ridistribuzione dei pesi del modello, con trasferimenti che potevano assorbire una parte significativa della larghezza di banda disponibile fra GPU. Olmo-core 3 mantiene invece gli esperti residenti sui dispositivi ai quali sono stati assegnati e trasferisce verso di essi i token che devono essere elaborati, riducendo il movimento dei pesi. La nuova struttura combina expert parallelism, che suddivide le reti specializzate fra diversi acceleratori, pipeline parallelism, che distribuisce i livelli del modello su gruppi di GPU, e un ottimizzatore distribuito che ripartisce fra i dispositivi gli stati utilizzati per aggiornare i parametri. Questa organizzazione limita la necessità di replicare l’intero modello e tutti gli stati dell’ottimizzatore su ciascuna GPU, mantenendo separati i differenti requisiti di memoria e comunicazione.
Le ottimizzazioni riguardano anche il percorso dei dati all’interno delle GPU. Il rowwise expert parallelism consente di collocare direttamente i token instradati nei buffer di ingresso degli esperti, riducendo le operazioni intermedie di riordinamento. Il GPU-resident routing mantiene sui dispositivi le informazioni necessarie alla distribuzione dei token, evitando che la CPU debba attendere il trasferimento delle strutture di instradamento prima di accodare nuove operazioni. Il framework utilizza inoltre grouped GEMM, una tecnica che aggrega numerose moltiplicazioni matriciali di dimensioni relativamente contenute, tipiche degli esperti MoE, in gruppi di operazioni eseguibili più efficientemente dagli acceleratori. Ai2 ha integrato il supporto per MXFP8, un formato numerico a precisione ridotta che diminuisce la quantità di dati trasferiti e il costo delle elaborazioni quando la conversione fra rappresentazioni non annulla i benefici. In una prova controllata su quattro GPU NVIDIA B300, l’utilizzo selettivo di MXFP8 ha aumentato il throughput complessivo di addestramento di circa il 21% rispetto alla configurazione BF16, riducendo contemporaneamente il picco di memoria attiva da 103 a 95 GiB.
Il confronto più diretto con il precedente sistema di addestramento è stato effettuato utilizzando otto GPU NVIDIA B300 e un modello MoE da 47 miliardi di parametri. In questo ambiente Olmo-core 3 ha raggiunto, secondo le misurazioni pubblicate da Ai2, circa 52.000 token al secondo per GPU, contro i 19.400 token al secondo della precedente implementazione FSDP, con un incremento del throughput pari a circa 2,7 volte. Un secondo esperimento ha valutato la possibilità di aumentare il numero degli esperti da 8 a 128, mantenendo quattro esperti attivi per token e circa 3,2 miliardi di parametri effettivamente coinvolti nell’elaborazione. In queste condizioni, la capacità totale del modello è cresciuta da 4,6 a 47 miliardi di parametri, mentre la riduzione del throughput di addestramento è rimasta inferiore al 5%. Si tratta di risultati riferiti a specifiche configurazioni hardware e software predisposte dal gruppo di ricerca, non di una garanzia di miglioramento identico rispetto a qualsiasi altro framework MoE o su infrastrutture GPU differenti.
Ai2 ha esteso le prove anche a configurazioni di dimensioni molto superiori. Un modello da 1.200 miliardi di parametri complessivi, con 58,36 miliardi di parametri attivi per token, è stato esaminato su un cluster di 512 GPU B300, raggiungendo un valore massimo osservato di 858 TFLOP/s per GPU. In questa valutazione è stato utilizzato un instradamento casuale dei token, finalizzato a misurare la capacità del sistema distribuito e non la qualità di un modello linguistico completamente addestrato. Ulteriori esperimenti con DeepEP v2, un sistema di comunicazione per gli esperti distribuiti, hanno raggiunto una configurazione da 2.380 miliardi di parametri totali. Quest’ultimo risultato deriva però da un test di capacità di breve durata, non da un ciclo integrale e continuativo di addestramento; pertanto dimostra la possibilità di distribuire un modello di quelle dimensioni, senza attestare tempi, costi e stabilità di un addestramento completo.
La documentazione di Olmo-core 3 descrive anche alcune difficoltà osservate durante lo sviluppo. Ai2 ha rilevato che determinate metriche destinate a favorire una distribuzione equilibrata dei token possono migliorare senza che il carico computazionale risulti realmente più uniforme, un fenomeno denominato token gerrymandering. Sono stati inoltre registrati casi nei quali la sovrapposizione delle comunicazioni e delle operazioni di calcolo attraverso flussi GPU distinti peggiorava il tempo complessivo di elaborazione, nonostante l’apparente maggiore parallelismo. Le prove hanno evidenziato anche differenze nei tempi di esecuzione delle operazioni matriciali al variare dei dati numerici, pur mantenendo costanti le dimensioni delle matrici. Questi risultati accompagnano il rilascio del codice e del rapporto tecnico e delimitano le condizioni nelle quali sono state misurate le prestazioni. Olmo-core 3 costituisce la base software prevista per la successiva generazione dei modelli MoE di Ai2, ma i benchmark del framework riguardano l’efficienza dell’infrastruttura di addestramento e non dimostrano, da soli, una maggiore accuratezza o capacità di ragionamento dei modelli che verranno sviluppati con essa.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)