
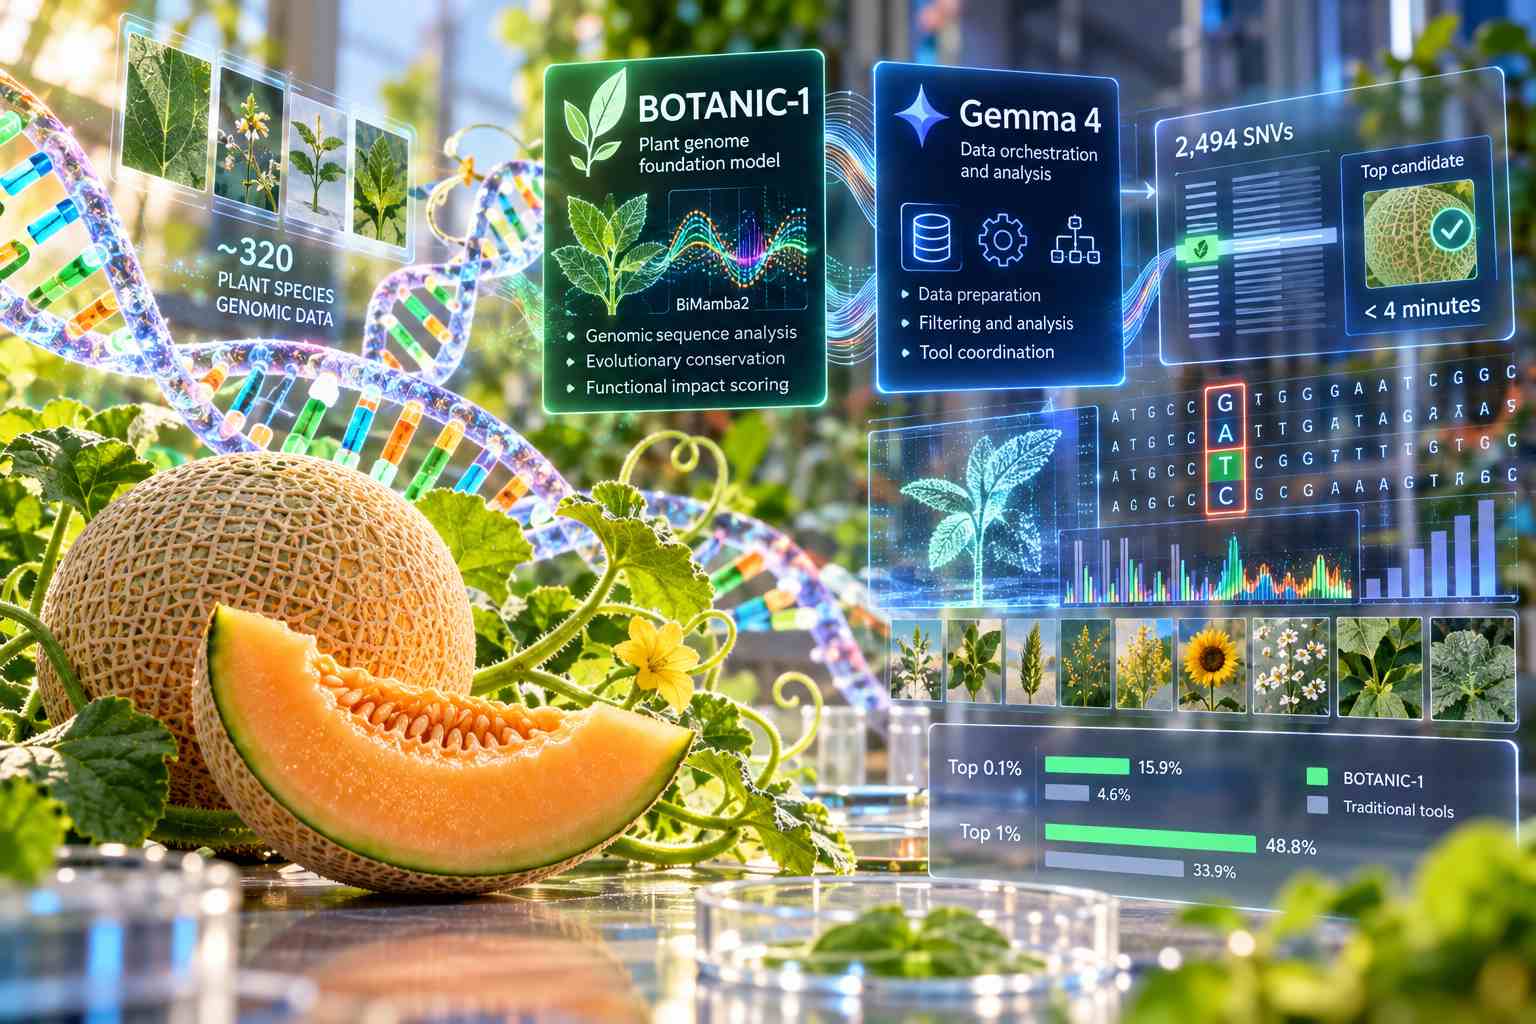
Living Models ha presentato un sistema di analisi genomica che combina BOTANIC-1, un modello di intelligenza artificiale specializzato nelle sequenze di DNA vegetale, con Gemma 4 di Google, utilizzato per organizzare i dati ed eseguire le procedure di analisi. L’approccio è stato sperimentato sull’identificazione di una variante genetica associata alla resa produttiva del melone, ottenendo l’individuazione del candidato corretto in meno di quattro minuti a partire da 2.494 varianti a singolo nucleotide selezionate. La soluzione attribuisce ai due modelli compiti differenti: Gemma 4 gestisce la preparazione dei dati genomici, l’applicazione dei filtri e il coordinamento degli strumenti, mentre BOTANIC-1 valuta l’importanza biologica delle mutazioni sulla base delle caratteristiche evolutive apprese durante l’addestramento. Questa organizzazione permette di applicare un sistema linguistico generale alle operazioni software senza affidargli direttamente tutte le valutazioni relative al funzionamento dei geni vegetali.
BOTANIC-1 è stato addestrato utilizzando dati genomici provenienti da circa 320 specie vegetali e impiega un’architettura bidirezionale BiMamba2, derivata dalla famiglia Mamba-2. A differenza delle architetture Transformer basate sull’attenzione, il modello utilizza un sistema di elaborazione delle sequenze che permette di trattare contesti genomici estesi senza dipendere da rappresentazioni posizionali esplicite dello stesso tipo. L’elaborazione bidirezionale consente di considerare le informazioni presenti prima e dopo la posizione genetica analizzata, un requisito importante per interpretare il ruolo di una singola base all’interno di una regione di DNA. Il modello valuta inoltre il grado di conservazione evolutiva delle sequenze: quando una posizione genetica mantiene caratteristiche analoghe in specie differenti, una sua alterazione può rappresentare un candidato meritevole di approfondimento biologico. BOTANIC-1 utilizza queste informazioni per assegnare punteggi alle varianti, stimando quali cambiamenti possano interferire maggiormente con le funzioni delle sequenze.
La sperimentazione sulla resa produttiva del melone ha affrontato un problema frequente negli studi di associazione genetica. Le analisi tradizionali possono individuare regioni cromosomiche correlate a una caratteristica osservabile, come la quantità di frutti prodotti, ma le varianti presenti nella stessa regione vengono spesso ereditate insieme. Questa associazione, nota come linkage disequilibrium, rende difficile distinguere le mutazioni direttamente coinvolte nel fenomeno biologico da quelle che risultano statisticamente correlate perché si trovano nelle vicinanze. Il gruppo di ricerca aveva già delimitato una regione comprendente diversi candidati, ma l’analisi convenzionale non era riuscita a identificare con certezza la variante responsabile. Utilizzando Gemma 4 con strumenti bioinformatici tradizionali, il sistema era riuscito a ridurre il numero delle varianti candidate a due, senza però distinguere correttamente quella rilevante dall’altra.
L’integrazione di BOTANIC-1 ha modificato il risultato. Dopo aver escluso le varianti appartenenti a categorie differenti, comprese inserzioni e delezioni, i ricercatori hanno sottoposto al modello genomico 2.494 single nucleotide variants, corrispondenti a mutazioni nelle quali cambia una singola base del DNA. BOTANIC-1 ha attribuito a ciascuna variante un punteggio relativo alla probabilità di un impatto funzionale, collocando la mutazione ricercata alla prima posizione della graduatoria in meno di quattro minuti. La procedura non equivale alla dimostrazione sperimentale che una variante provochi necessariamente un determinato cambiamento nella pianta: il risultato riguarda la capacità del modello di individuare, fra numerosi candidati, quello già identificato attraverso le informazioni disponibili nella sperimentazione. La verifica degli effetti agronomici continua a richiedere studi genetici e biologici sul campo o in laboratorio.
I ricercatori hanno inoltre confrontato BOTANIC-1 con strumenti bioinformatici tradizionali su un insieme di oltre 500 varianti vegetali per le quali erano disponibili verifiche sperimentali. Nel 15,9% dei casi, il modello ha collocato la variante causale entro lo 0,1% dei candidati con punteggio più elevato, rispetto al 4,6% registrato dal sistema di confronto. Considerando una soglia meno restrittiva, corrispondente all’1% superiore della graduatoria, BOTANIC-1 ha raggiunto il 48,8% dei casi contro il 33,9% dell’approccio tradizionale. Queste misurazioni descrivono la capacità di ordinare correttamente le varianti già note, non la percentuale complessiva di nuove scoperte genetiche confermate. La differenza è importante perché un modello può essere efficace nell’individuare candidati prioritari pur senza sostituire le successive procedure di validazione biologica.
Il sistema utilizza Gemma 4 E4B come componente incaricato dell’orchestrazione delle operazioni e BOTANIC-1 come componente specialistica per l’interpretazione delle sequenze genetiche. L’architettura può essere eseguita anche su infrastrutture locali, senza trasferire obbligatoriamente i dati genomici verso servizi cloud esterni. Questa possibilità consente ai laboratori di mantenere il controllo dei propri dataset e di gestire direttamente le procedure di elaborazione. BOTANIC-1 è distribuito attraverso Hugging Face con condizioni di accesso che prevedono l’accettazione automatizzata della licenza per gli utilizzi di ricerca, mentre l’impiego commerciale è soggetto a restrizioni.
L’approccio è destinato soprattutto alla selezione dei candidati genetici da sottoporre a successivi esperimenti. Nello sviluppo varietale, la conferma degli effetti di una mutazione può richiedere coltivazioni estese, l’osservazione di numerosi individui e verifiche distribuite su più generazioni. Un sistema capace di ridurre rapidamente il numero dei candidati permette ai ricercatori di concentrare le risorse sulle varianti che presentano le maggiori probabilità di influire sulle caratteristiche agronomiche. Le applicazioni prospettate comprendono l’identificazione di mutazioni associate alla produttività, alla tolleranza alla siccità e ad altre caratteristiche rilevanti per la selezione delle colture, mentre i risultati sperimentali pubblicati riguardano specificamente la capacità di classificazione delle varianti genomiche esaminate.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)