
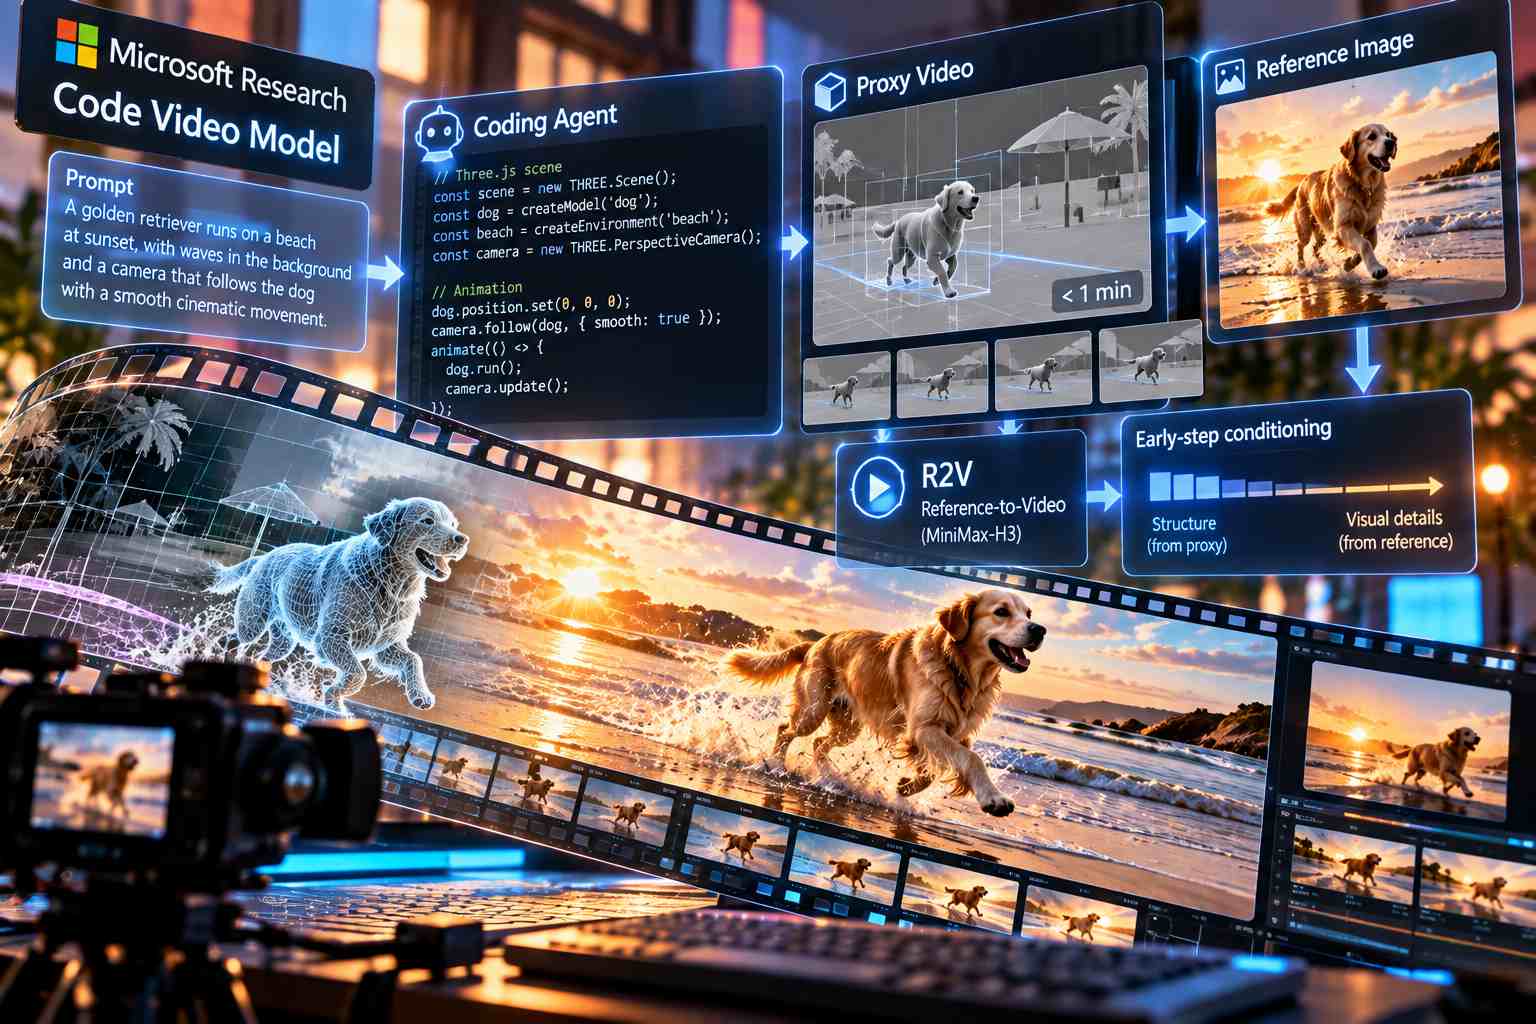
Microsoft Research ha presentato nell’ottobre 2026 Code Video Model, un sistema sperimentale di generazione video che utilizza programmi eseguibili per definire la composizione delle scene, i movimenti degli oggetti e le traiettorie delle telecamere prima della produzione delle immagini definitive. Il progetto introduce un’architettura nella quale un agente di programmazione converte le istruzioni in linguaggio naturale in codice capace di descrivere e riprodurre il comportamento degli elementi presenti nella scena. A differenza dei tradizionali modelli text-to-video, che devono dedurre autonomamente dal prompt le relazioni spaziali, i movimenti e le trasformazioni temporali, Code Video Model trasferisce una parte di queste operazioni a un ambiente di esecuzione programmabile. Il sistema produce inizialmente una rappresentazione semplificata del video, denominata proxy video, utilizzata per verificare la correttezza della composizione e dei movimenti. Questa rappresentazione viene successivamente combinata con immagini di riferimento per guidare un modello generativo preaddestrato nella realizzazione del filmato finale.
L’architettura si sviluppa attraverso una pipeline che separa la progettazione geometrica e temporale dalla generazione dell’aspetto visivo. Nella prima fase, l’utente descrive la scena desiderata attraverso un prompt, specificando eventualmente le caratteristiche dei soggetti, le azioni, la disposizione degli oggetti e il comportamento della telecamera. Un agente di coding, basato nelle implementazioni pubblicate su GPT-6, traduce la descrizione in un programma Three.js, la libreria JavaScript destinata alla realizzazione di scene tridimensionali. Il codice definisce oggetti, coordinate, trasformazioni geometriche, sequenze temporali e percorsi di ripresa, consentendo di rappresentare esplicitamente le condizioni che devono essere rispettate durante l’animazione. Quando il comportamento degli elementi richiede regole fisiche, queste possono essere incorporate mediante equazioni e procedure di simulazione. L’esecuzione del programma genera una sequenza video semplificata che conserva le informazioni spaziali e cinematiche fondamentali, pur senza riprodurre necessariamente materiali, illuminazione, superfici e dettagli fotorealistici.
Il proxy video costituisce uno degli elementi centrali del metodo, poiché rende possibile verificare il risultato strutturale prima di impegnare le risorse necessarie alla generazione definitiva. Secondo i ricercatori, la sua produzione richiede meno di un minuto nelle condizioni sperimentali descritte, permettendo di controllare rapidamente posizione e dimensioni relative degli oggetti, direzione dei movimenti, successione delle azioni e percorso della telecamera. Se la scena non corrisponde alle istruzioni, l’agente può intervenire direttamente sul programma, modificando parametri, coordinate, velocità o intervalli temporali e producendo una nuova anteprima. La correzione avviene quindi attraverso l’aggiornamento di istruzioni eseguibili anziché mediante una nuova descrizione testuale che il modello video deve interpretare nuovamente. Questo meccanismo consente di conservare le parti già corrette di una scena e modificare selettivamente quelle che richiedono un intervento, compresa la posizione di un singolo oggetto o la traiettoria di una ripresa.
Dopo la costruzione del proxy video, il sistema prepara un’immagine di riferimento che definisce le caratteristiche visive da trasferire al filmato finale. La pipeline può utilizzare un fotogramma estratto dalla scena generata oppure ricorrere a un sistema di generazione di immagini per stabilire un aspetto differente, mantenendo il prompt come indicazione delle caratteristiche desiderate. L’implementazione pubblicata comprende strumenti per produrre immagini di riferimento a partire da una ricostruzione Three.js e una modalità guidata dal testo capace di generare immagini con risoluzione di 1536 × 864 pixel. Il video proxy, l’immagine di riferimento e il prompt originale vengono quindi forniti a un modello Reference-to-Video, indicato come R2V, che utilizza queste informazioni per sintetizzare la sequenza finale. Negli esperimenti presentati, il modello impiegato è MiniMax-H3 nella configurazione dedicata alla generazione condizionata da riferimenti visivi.
L’impiego diretto del proxy video durante l’intero processo generativo potrebbe produrre risultati eccessivamente vincolati alla rappresentazione semplificata, con immagini prive della ricchezza visiva desiderata. Per affrontare questo limite, i ricercatori hanno sviluppato una tecnica denominata early-step conditioning, che applica il condizionamento strutturale soltanto durante le fasi iniziali del campionamento. In questa configurazione, il modello generativo utilizza inizialmente le informazioni geometriche e temporali del proxy per stabilire la disposizione degli elementi e il movimento complessivo della scena. Nelle fasi successive, il vincolo derivante dal proxy viene rimosso, lasciando maggiore libertà al modello di ricostruire materiali, illuminazione, dettagli delle superfici e caratteristiche stilistiche sulla base dell’immagine di riferimento e della conoscenza acquisita durante il preaddestramento. La separazione temporale fra i due tipi di condizionamento permette di mantenere la coerenza delle azioni programmate senza trasferire automaticamente nel risultato definitivo la semplicità grafica dell’anteprima.
La tecnica è progettata per funzionare senza addestramenti aggiuntivi del modello video e senza richiedere la realizzazione di un modulo di controllo specializzato. MiniMax-H3 viene utilizzato mantenendo invariati i parametri del checkpoint preaddestrato, mentre il controllo del risultato è affidato alla costruzione degli input e alla gestione delle fasi di campionamento. L’implementazione pubblicata consente di definire il numero di passaggi iniziali durante i quali mantenere attivo il condizionamento strutturale, offrendo un parametro attraverso il quale regolare l’equilibrio tra fedeltà al movimento programmato e qualità visiva. La pipeline contiene inoltre strumenti per generare coppie di video originali e modificati, conservando codice della scena, proxy, immagine di riferimento e prompt per entrambe le versioni. Questo permette di confrontare l’effetto di modifiche locali e di verificare se il modello generativo riesce a mantenere invariati gli elementi non interessati dalla revisione.
Per misurare le prestazioni, il gruppo di ricerca ha introdotto CodeVideoBench, un benchmark composto da 22 casi distribuiti su otto categorie applicative. Le prove comprendono ambienti di gioco, composizione e modifica delle scene, simulazioni di movimento basate su regole fisiche, effetti cinematografici bullet time e attività di ricostruzione tridimensionale e quadridimensionale. Ogni caso include materiali necessari a riprodurre la procedura, fra cui il programma Three.js, il video proxy, l’immagine di riferimento e il prompt. Le valutazioni prendono in considerazione la fedeltà strutturale, la coerenza stilistica e la qualità visiva, utilizzando modelli multimodali come sistemi di giudizio. Il benchmark consente quindi di esaminare separatamente il rispetto della configurazione programmata e le caratteristiche estetiche del filmato finale, due aspetti che nei tradizionali sistemi di generazione video possono risultare difficili da distinguere.
Nelle prove comunicate dai ricercatori, Code Video Model combinato con MiniMax-H3 ha ottenuto punteggi di 85,2, 82,1 e 85,8 secondo tre differenti sistemi di valutazione, identificati come Qwen3.8-27B, GPT-5.6 e GPT-6. Il sistema VACE, risultato il migliore fra i modelli di confronto basati su addestramento specializzato, ha registrato rispettivamente 74,3, 73,1 e 80,6 punti nelle stesse condizioni. I risultati indicano un miglioramento nelle valutazioni condotte con il benchmark proposto, ma non costituiscono una dimostrazione di superiorità universale rispetto a tutte le tecniche di controllo video. Le prestazioni dipendono dai casi selezionati, dal modello generativo utilizzato, dalla qualità dei programmi prodotti dall’agente e dai criteri applicati dai sistemi di valutazione automatica. Gli esperimenti pubblicati comprendono anche esempi di percorsi di telecamera in ambienti interni, spostamento di oggetti, navigazione robotica e scene con movimenti coordinati.
Le applicazioni previste si estendono oltre la produzione di brevi sequenze cinematografiche. La possibilità di rappresentare il movimento attraverso codice permette di costruire scene nelle quali traiettorie, tempi e condizioni fisiche risultano esplicitamente definiti, rendendo il sistema utilizzabile come base sperimentale per la simulazione robotica, la generazione di dati sintetici e la progettazione di ambienti destinati all’addestramento di modelli del mondo fisico. Nel caso della robotica, per esempio, una scena programmata può descrivere il percorso di un agente, la posizione degli ostacoli e le interazioni con l’ambiente, mentre il modello video aggiunge una rappresentazione visiva più dettagliata. La stessa impostazione può essere applicata alla ricostruzione di scene 3D e 4D, dove la quarta dimensione rappresenta l’evoluzione temporale della geometria. La coerenza fisica rimane comunque legata alla correttezza del programma e della simulazione sottostante: l’utilizzo del codice non garantisce automaticamente che ogni comportamento rappresentato sia realistico o compatibile con le leggi fisiche.
Il gruppo di ricerca ha distribuito pubblicamente il codice sorgente di Code Video Model attraverso GitHub e i materiali del benchmark CodeVideoBench tramite Hugging Face. Il repository comprende configurazioni, esempi, script di inferenza e valutazione e procedure per scaricare il checkpoint MiniMax-H3 utilizzato negli esperimenti. Le istruzioni tecniche prevedono un ambiente Ubuntu 22.04, Python 3.10, PyTorch 2.7.1 e driver NVIDIA compatibili con CUDA 12.6, oltre alle dipendenze necessarie all’esecuzione di Three.js e alla generazione delle immagini di riferimento. Fra gli esempi disponibili figurano scene dedicate a un’automobile sportiva, alla salita su un carro armato, all’esplorazione di un loft e alla navigazione di un robot. La disponibilità pubblica dei componenti consente agli sviluppatori di riprodurre la pipeline, modificare il codice delle scene e condurre ulteriori confronti, mantenendo distinta la progettazione programmabile del movimento dalla sintesi visiva realizzata dal modello generativo.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)