
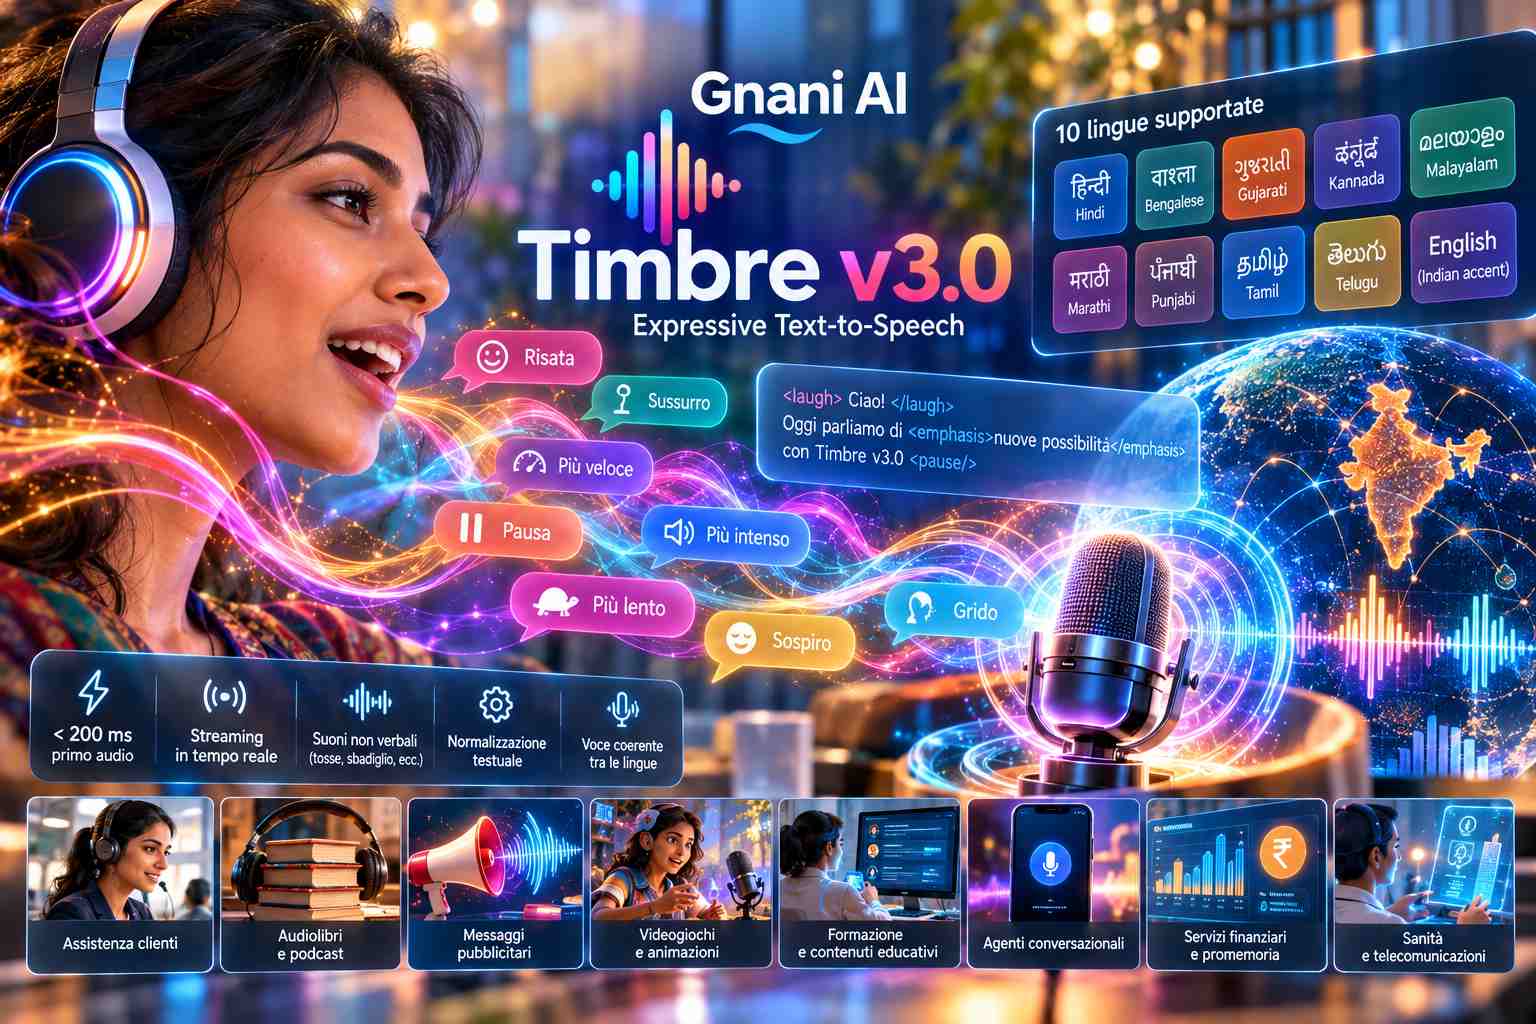
Gnani AI, società con sede a Bengaluru specializzata nelle tecnologie vocali, ha presentato Timbre v3.0, una nuova versione del proprio modello text-to-speech progettata per generare parlato sintetico con un controllo dettagliato dell’espressività. Il sistema permette agli sviluppatori e ai creatori di contenuti di definire non soltanto le parole da pronunciare, ma anche le modalità della loro interpretazione, intervenendo su pause, velocità, intensità, risate, sussurri e altre caratteristiche acustiche della voce. Il modello supporta dieci lingue: hindi, bengalese, gujarati, kannada, malayalam, marathi, punjabi, tamil, telugu e inglese con accento indiano. Questa copertura linguistica è stata sviluppata per consentire la produzione di contenuti vocali e la realizzazione di agenti conversazionali destinati al mercato indiano, dove la varietà delle lingue e delle abitudini espressive richiede sistemi capaci di adattare la pronuncia e l’intonazione a contesti differenti. Tra le applicazioni previste figurano assistenti vocali per il servizio clienti, audiolibri, podcast, messaggi pubblicitari, videogiochi, animazioni, contenuti formativi e narrazioni destinate ai video.
Il principale meccanismo di controllo introdotto da Timbre v3.0 si basa sull’utilizzo di audio tag incorporati nel testo. Questi marcatori consentono di specificare come una determinata frase o porzione della narrazione debba essere pronunciata, includendo istruzioni per ridere, ridacchiare, sospirare, sussurrare, gridare, rallentare, accelerare oppure introdurre pause ed espressioni di entusiasmo. Il modello è inoltre in grado di generare suoni non verbali, come colpi di tosse, inspirazioni nasali, sbadigli ed espirazioni, che possono essere inseriti all’interno di dialoghi e narrazioni per rappresentare comportamenti vocali differenti dalla lettura tradizionale. Gli audio tag sono utilizzabili in tutte le lingue supportate, permettendo di applicare il medesimo sistema di controllo espressivo a contenuti multilingue. Quando il testo non contiene istruzioni esplicite, Timbre v3.0 determina autonomamente alcune caratteristiche della pronuncia analizzando significato, tono e punteggiatura delle frasi. Gli sviluppatori possono quindi scegliere tra una regolazione diretta della voce e una generazione nella quale ritmo e interpretazione vengono determinati dal modello.
Dal punto di vista delle prestazioni, Gnani AI dichiara un tempo inferiore a 200 millisecondi per la produzione del primo segmento audio, un valore che permette di impiegare il sistema in conversazioni vocali nelle quali il ritardo tra richiesta e risposta deve rimanere contenuto. Il modello supporta la riproduzione in streaming, consentendo di iniziare l’ascolto prima che l’intera risposta sia stata sintetizzata, e gestisce anche generazioni vocali di lunga durata per audiolibri, narrazioni e risposte articolate. Una caratteristica importante riguarda la conservazione dell’identità timbrica della voce durante il passaggio tra lingue differenti, in modo che un’organizzazione possa utilizzare una voce riconoscibile nelle comunicazioni rivolte a utenti di aree linguistiche diverse. Il sistema integra inoltre funzionalità di normalizzazione testuale che convertono numeri, date, importi monetari, simboli e abbreviazioni in espressioni pronunciate correttamente. Questa capacità interessa in particolare i contesti finanziari, nei quali importi, scadenze, tassi d’interesse e riferimenti numerici devono essere comunicati in maniera comprensibile e coerente.
Gnani AI ha individuato numerose applicazioni aziendali per Timbre v3.0, comprese le comunicazioni relative ai pagamenti, i solleciti di riscossione, le procedure know-your-customer, l’attivazione dei nuovi clienti, il rinnovo delle polizze assicurative, la gestione dei sinistri, i promemoria degli appuntamenti e l’assistenza telefonica nei settori finanziario, sanitario e delle telecomunicazioni. La tecnologia può essere utilizzata anche per trasformare contenuti scritti in articoli audio, realizzare guide vocali all’interno delle applicazioni e rendere accessibili informazioni digitali nella lingua preferita dall’utente. Secondo l’azienda, la tecnologia Timbre alimenta già oltre 100.000 ore di chiamate vocali. La nuova versione estende queste capacità attraverso una maggiore controllabilità dell’interpretazione e una gestione più flessibile del ritmo, con l’obiettivo di consentire alle applicazioni di distinguere tra comunicazioni informative, conversazioni di assistenza e contenuti narrativi utilizzando un unico modello multilingue.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)