
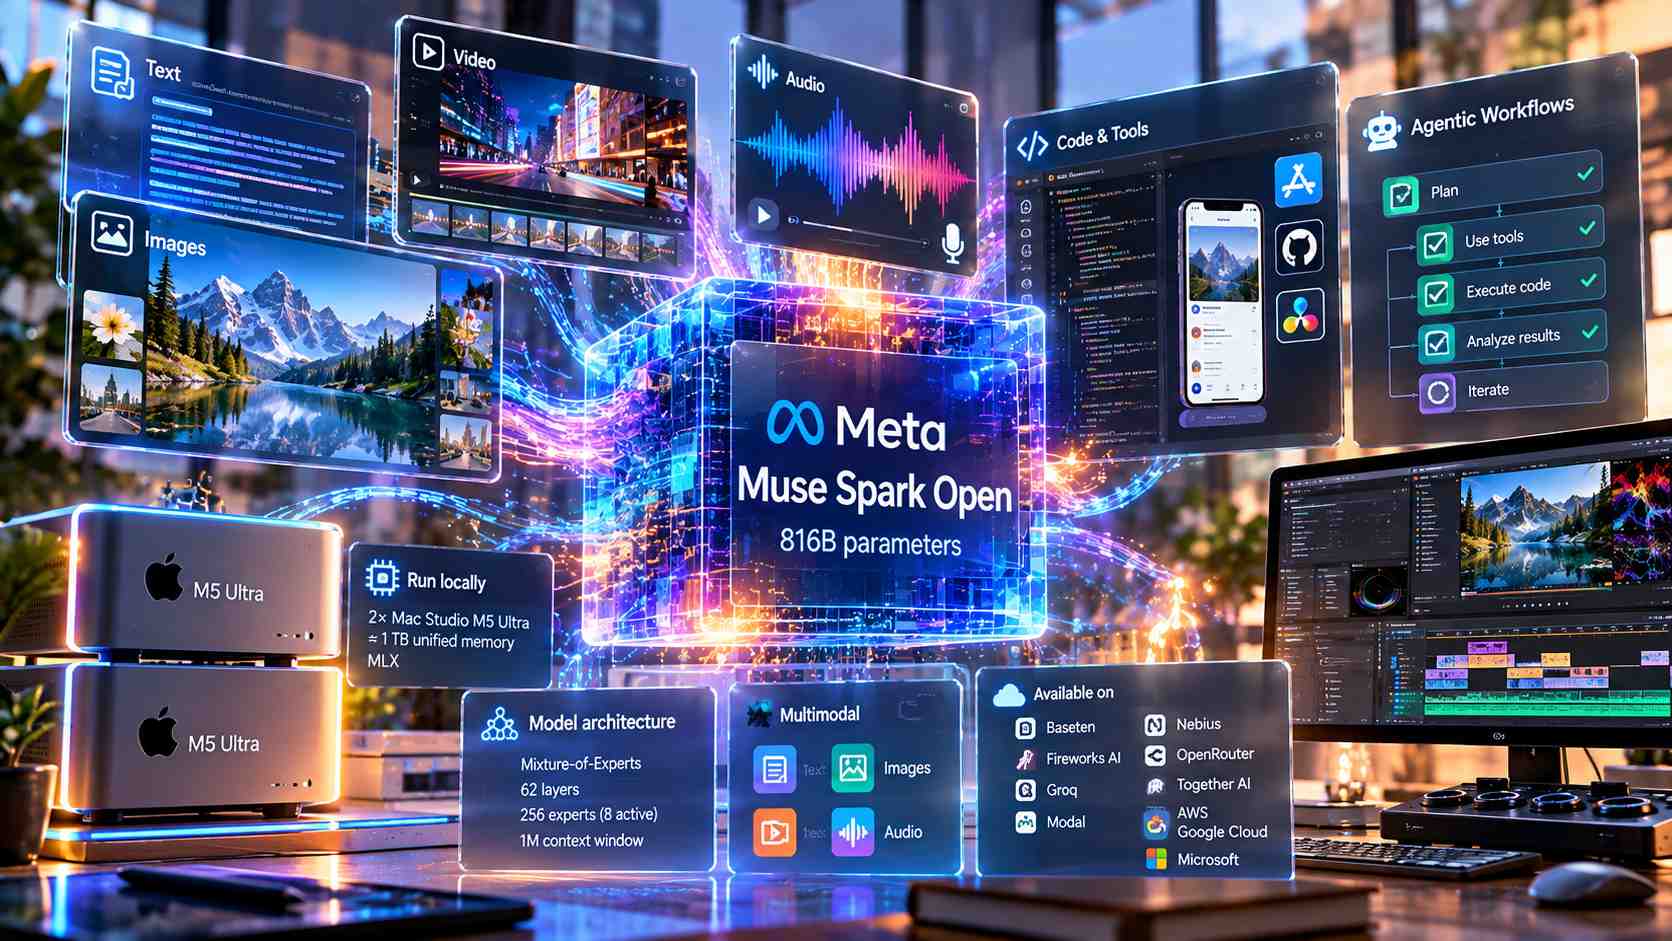
Meta annuncia la disponibilità pubblica dei pesi di Muse Spark Open, un modello di intelligenza artificiale multimodale da 816 miliardi di parametri complessivi, progettato per attività di programmazione, ragionamento complesso, utilizzo di strumenti e procedure agentiche di lunga durata. Il sistema è stato sviluppato da Meta Superintelligence Labs e utilizza un’architettura Mixture-of-Experts, nella quale vengono attivati circa 42 miliardi di parametri per ciascun token elaborato, consentendo di distribuire le capacità del modello su un insieme molto ampio di componenti specializzati. La finestra di contesto raggiunge un milione di token, mentre gli input supportati comprendono testo, immagini, video e audio, con risposte generate in formato testuale. Meta presenta Muse Spark Open come il proprio modello a pesi aperti più avanzato e lo colloca tra i sistemi statunitensi più capaci distribuiti con questa modalità, rendendolo disponibile attraverso infrastrutture cloud, servizi API e configurazioni locali dotate di risorse hardware particolarmente elevate. Il rilascio comprende checkpoint in BF16 e NVFP4, documentazione tecnica e una licenza che consente l’utilizzo, la modifica e la distribuzione dei pesi, nel rispetto delle condizioni commerciali e operative previste.
L’architettura principale è costituita da un Transformer Mixture-of-Experts con 62 livelli, dimensione nascosta pari a 8.192 e 256 esperti, dei quali otto vengono selezionati per ciascun token attraverso un meccanismo di instradamento top-k. Il sistema di attenzione utilizza gated attention con normalizzazione QK-norm e una configurazione grouped-query composta da 128 teste di interrogazione e 16 teste key-value, ciascuna con dimensione pari a 64. Il vocabolario comprende 202.048 token e utilizza matrici distinte per gli embedding di ingresso e di uscita. La componente multimodale è affidata a un Perception Encoder da 1,8 miliardi di parametri, articolato in 50 livelli, con dimensione nascosta di 1.536, 16 teste di attenzione e una dimensione delle patch visive pari a 14 × 14. L’encoder produce rappresentazioni con dimensione di uscita pari a 4.096 e impiega un meccanismo di attenzione sparsa con fattore quattro, nel quale ogni quarto livello e quello finale utilizzano l’attenzione completa. Questa struttura permette di combinare informazioni provenienti da modalità differenti all’interno delle elaborazioni del modello linguistico, mantenendo il supporto a sequenze di input particolarmente estese.
L’addestramento di Muse Spark Open ha utilizzato dati testuali, immagini, registrazioni audio e contenuti video provenienti da fonti pubbliche, raccolte sul web, fornitori terzi, prodotti e servizi Meta e materiale generato sinteticamente. Il corpus comprende contenuti in oltre cento lingue ed è stato sottoposto a procedure di pulizia, normalizzazione, deduplicazione e filtraggio. Il modello dispone di un parametro denominato reasoning_effort che permette di configurare l’intensità del ragionamento attraverso quattro livelli, low, medium, high e xhigh, con quest’ultimo impostato come valore predefinito. L’impiego di valori differenti determina un errore di configurazione, mentre Meta raccomanda di utilizzare high oppure xhigh per problemi complessi, attività di programmazione e procedure agentiche. Per la generazione ordinaria, le indicazioni tecniche prevedono temperature pari a 1,0, top_p pari a 1,0 e il parametro top_k disattivato, secondo le configurazioni utilizzate durante le valutazioni pubblicate.
La distribuzione commerciale comprende l’accesso tramite API attraverso Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter e Together AI. I pesi possono essere scaricati attraverso Hugging Face e sono disponibili anche negli ambienti Amazon SageMaker AI, Google Cloud Model Garden e Microsoft Foundry Models. Le tecnologie di inferenza supportate comprendono SGLang, vLLM, TensorRT-LLM, Hugging Face Transformers, Apple MLX, llama.cpp e Unsloth, con ottimizzazioni destinate ai processori e agli acceleratori AMD, Apple, Intel e NVIDIA. Gli sviluppatori possono inoltre eseguire ulteriori procedure di addestramento utilizzando TorchTitan, il framework PyTorch dedicato alla gestione distribuita dei grandi modelli. Le risorse hardware richieste rimangono considerevoli: Meta indica almeno 700 GB di memoria video per utilizzare la variante NVFP4 e circa 2 TB per la versione BF16, valori che richiedono normalmente infrastrutture multi-GPU o sistemi dotati di memoria unificata di dimensioni molto elevate.
Una delle configurazioni locali dimostrate da Meta utilizza due Mac Studio equipaggiati con processori Apple M5 Ultra, collegati per eseguire il modello attraverso l’ultima versione del framework MLX. Ogni sistema può disporre di un massimo di 512 GB di memoria unificata, accessibile alla GPU integrata, mentre la larghezza di banda dichiarata del processore raggiunge 1,2 TB al secondo. La combinazione dei due computer permette di ottenere complessivamente circa un terabyte di memoria unificata, sufficiente per conservare i pesi della configurazione quantizzata e distribuire le operazioni di inferenza. Meta ha presentato questa configurazione come una delle prime dimostrazioni di un modello appartenente a tale categoria dimensionale eseguito su hardware desktop. Il sistema recupera direttamente i pesi da Hugging Face e utilizza le capacità di MLX per gestire l’elaborazione sui due computer, consentendo di eseguire attività agentiche senza dipendere necessariamente da servizi di inferenza remoti.
Le prove operative condotte con Muse Code, alimentato da Muse Spark Open, hanno compreso interventi su Ice Cubes, un client Mastodon open source per iOS. L’agente ha eseguito modifiche al codice, corretto problemi, introdotto funzionalità e completato la compilazione dell’applicazione. Una seconda dimostrazione ha riguardato l’utilizzo di DaVinci Resolve, attraverso il quale il sistema ha analizzato le riprese fotogramma per fotogramma, selezionato i momenti considerati più significativi e modificato l’inquadratura per produrre ritagli verticali. Meta ha inoltre integrato kernel GPU personalizzati sviluppati con Helion all’interno di SGLang, dotati di procedure automatiche di ottimizzazione in funzione dell’hardware utilizzato. Le misurazioni aziendali indicano miglioramenti delle prestazioni dei singoli kernel compresi tra 1,03 e 3,95 volte su GPU NVIDIA e AMD, con un incremento del 3% delle prestazioni complessive di inferenza sulla piattaforma AMD MI350. La differenza tra l’accelerazione di specifiche operazioni e il miglioramento dell’intero processo deriva dalla presenza di ulteriori componenti, trasferimenti e operazioni che contribuiscono al tempo totale di esecuzione.
Meta ha pubblicato un insieme di benchmark nel quale Muse Spark Open è stato valutato con reasoning_effort impostato su xhigh, confrontandolo con modelli come Inkling, Nemotron 3 Ultra, Beam, Mistral Large 4, Qwen3.8-2.4T-A95B, GLM 5.3 e Kimi K3. Nell’Artificial Analysis Intelligence Index, il modello ha ottenuto 39 punti, rispetto ai 45 registrati da GLM 5.3, ai 44 di Kimi K3 e ai 40 di Qwen3.8-2.4T-A95B. Le valutazioni dedicate alle attività agentiche hanno invece evidenziato risultati particolarmente elevati: Muse Spark Open ha raggiunto 61,8 punti su JobBench e 89,2 su MCP-Atlas, collocandosi al primo posto tra i sistemi inclusi nella tabella comparativa pubblicata da Meta per questi due test. Nei benchmark dedicati alla conoscenza e al ragionamento, il modello ha ottenuto 26,1 su HLE-Diamond senza strumenti esterni, 25 su AA Omniscience e 89,0 su GPQA Diamond, dove Qwen3.8-2.4T-A95B e Kimi K3 raggiungono entrambi 93,5 punti.
Nelle prove di programmazione, Muse Spark Open ha registrato 76,4 punti su Terminal-Bench 2.1, rispetto agli 85,0 di Kimi K3 e agli 83,9 di GLM 5.3. I risultati comprendono inoltre 60 punti su DeepSWE 1.1 e 58 su SWE-Atlas-QnA, benchmark nei quali Kimi K3 ha ottenuto rispettivamente 68 e 66. Le valutazioni multimodali con utilizzo di strumenti riportano 50,0 su ZeroBench, 73,6 su SimpleVQA, 80,2 su BabyVision e 61,5 su VideoMMEv2. Nelle ultime due prove, Kimi K3 ha registrato rispettivamente 85,7 e 65,4 punti. Il quadro delle misurazioni evidenzia prestazioni differenti a seconda del dominio considerato, con risultati particolarmente competitivi nelle procedure agentiche e punteggi inferiori rispetto ad alcuni modelli concorrenti nei benchmark di programmazione e ragionamento specialistico. Le cifre derivano dalla documentazione tecnica pubblicata da Meta e descrivono le condizioni di esecuzione adottate durante i test, senza necessariamente rappresentare il comportamento del sistema in ogni configurazione di distribuzione.
Il rilascio dei pesi è stato accompagnato da una fase aggiuntiva di post-addestramento destinata alla sicurezza e da valutazioni condotte secondo il Meta Superintelligence Scaling Framework. I controlli hanno riguardato sicurezza dei contenuti, rischi derivanti dall’utilizzo agentico, protezione della privacy e capacità potenzialmente pericolose. Nel benchmark interno dedicato alla sicurezza informatica, Muse Spark Open ha rifiutato il 99,2% dei tentativi di jailbreak, mentre la percentuale aggregata nei test comprendenti il sottoinsieme cyber di PolyGuard, RedCode e CyberBench 2024 ha raggiunto il 94,8%. Nelle stesse configurazioni, Kimi K3 ha registrato rispettivamente 75,5% e 70,2%. Le valutazioni delle richieste dannose in ambito biologico hanno mostrato percentuali di rifiuto superiori al 98% su SecureBio BioTIER, mentre un benchmark interno di chimica a singolo turno ha superato il 99%. Nei test agentici multi-turno, le percentuali di rifiuto sono state superiori al 97% per richieste biologiche dannose e al 98% per quelle chimiche.
Le ulteriori valutazioni di sicurezza comprendono un risultato del 98,1% nel benchmark MASK, dedicato alla misurazione dell’onestà del modello, e un tasso di comportamento improprio pari allo 0% nel benchmark Agentic Misalignment. Su StrongREJECT v2 il sistema ha ottenuto 0,5 punti, secondo una scala nella quale valori inferiori indicano risultati migliori. Meta precisa che queste misurazioni riguardano il checkpoint distribuito e le configurazioni utilizzate durante i test, mentre eventuali modifiche successive, comprese quantizzazioni, procedure di fine-tuning e integrazioni in sistemi agentici esterni, possono alterarne le caratteristiche di sicurezza. L’azienda raccomanda pertanto di affiancare al modello ulteriori controlli applicativi, limitazioni degli strumenti e meccanismi di supervisione adeguati alle attività per le quali viene impiegato.
Muse Spark Open è distribuito attraverso la Muse Model License, datata 15 ottobre 2026, che permette gratuitamente utilizzo, copia, modifica, fine-tuning, produzione di opere derivate, distillazione e redistribuzione, nel rispetto delle condizioni previste. I prodotti e servizi che utilizzano direttamente il modello o suoi derivati devono mostrare la dicitura “Built with Muse Spark Open” nell’interfaccia utente oppure nella documentazione, sul sito web o nelle impostazioni. È inoltre prevista una condizione specifica per gli operatori che offrono modelli di intelligenza artificiale come servizio: quando i ricavi lordi aggregati dell’azienda e delle società affiliate superano 20 milioni di dollari nell’arco di dodici mesi consecutivi, è necessario informare Meta e concludere un accordo scritto separato prima di utilizzare il modello in tale attività. La limitazione non riguarda l’utilizzo interno, la ricerca o altre applicazioni commerciali che non consistano nell’offerta di un servizio di modelli AI, né l’impiego del software come componente di un prodotto proprietario. Meta non rivendica inoltre diritti di proprietà sui contenuti generati dal modello.
La politica di utilizzo allegata alla licenza esclude l’impiego da parte di persone di età inferiore a 18 anni e vieta applicazioni legate ad attività illegali, produzione di malware, sviluppo di armi, funzionamento di infrastrutture critiche e inganno intenzionale, comprese frodi, disinformazione e impersonificazione. La documentazione segnala inoltre la possibilità di risposte inesatte, distorte o inappropriate, errori nei ragionamenti articolati in più passaggi e prestazioni inferiori nelle lingue meno rappresentate durante l’addestramento. Le versioni quantizzate possono presentare piccole differenze qualitative rispetto ai checkpoint a precisione superiore, mentre l’interpretazione di video molto brevi o a bassa risoluzione può risultare meno affidabile. Meta ha annunciato la successiva disponibilità di un rapporto completo di valutazione, che dovrebbe fornire ulteriori dettagli sulle procedure sperimentali e sulle caratteristiche del checkpoint rilasciato.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)