
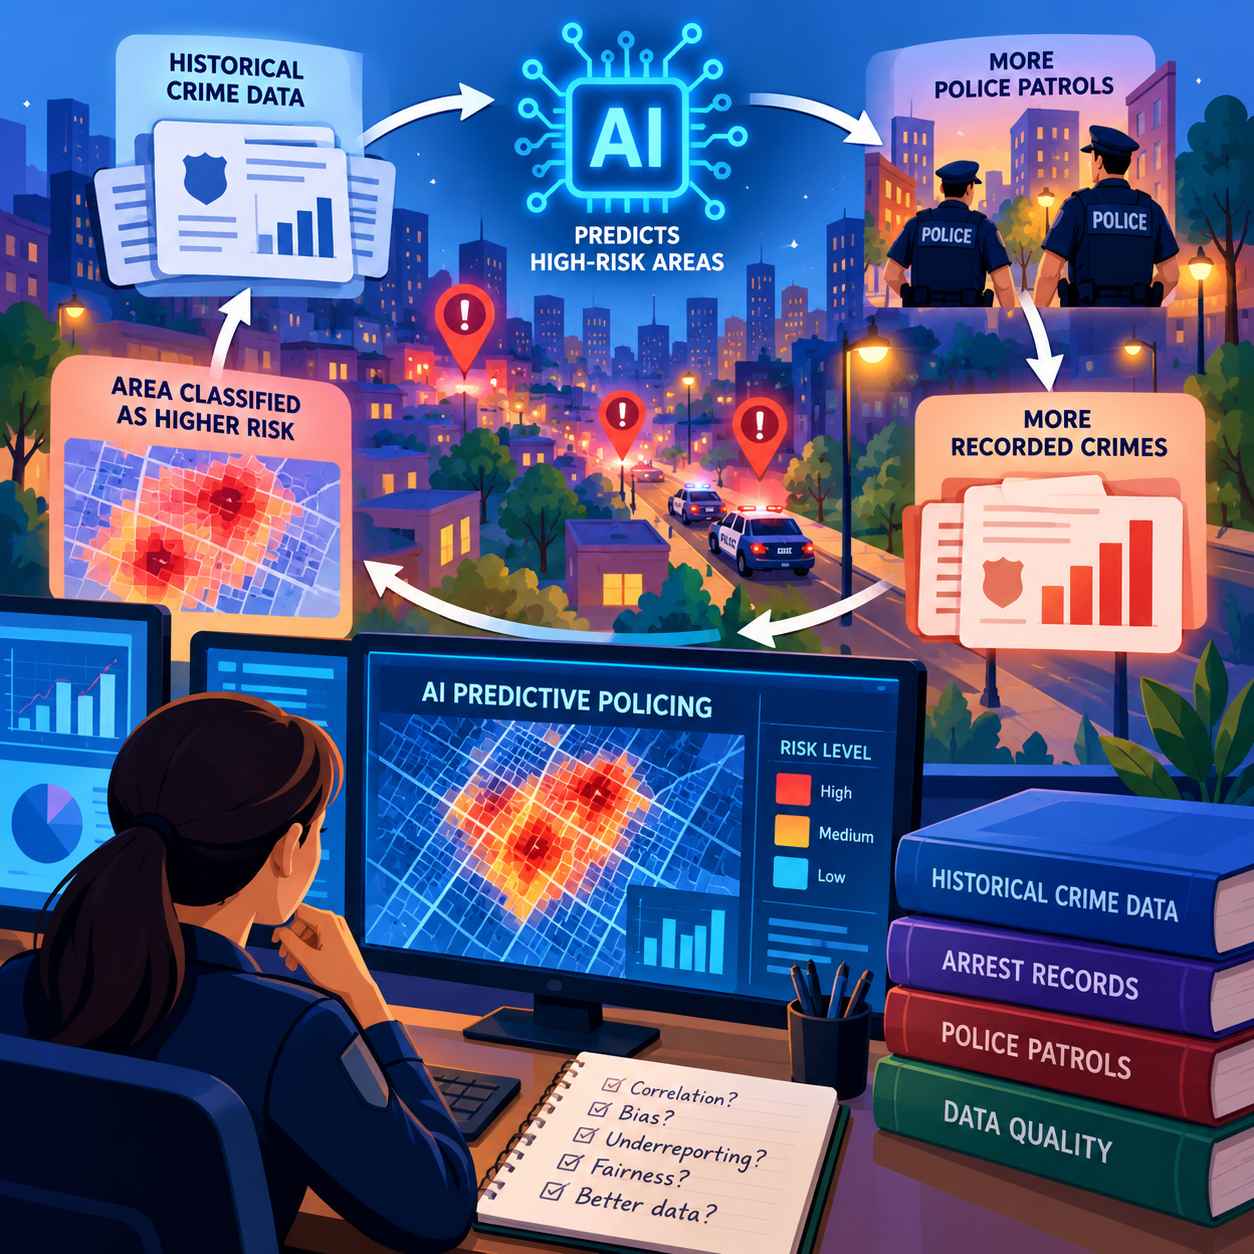
L’utilizzo dell’intelligenza artificiale nei sistemi di polizia predittiva presenta criticità legate alla natura dei dati utilizzati per stimare la probabilità che vengano commessi reati in determinate aree geografiche. Il problema è stato approfondito da Adrian Dredge, studente britannico sedicenne vincitore del premio Young Science Writer of the Year 2026 assegnato dalla Association of British Science Writers. I sistemi di previsione utilizzano generalmente informazioni storiche sui reati registrati dalle forze dell’ordine per individuare concentrazioni territoriali e orientare le attività di sorveglianza. Tali registrazioni, però, non rappresentano necessariamente una misura completa e indipendente dei fenomeni criminali. Il numero di violazioni individuate in una determinata zona dipende anche dall’intensità dei controlli eseguiti, dalle risorse disponibili e dalle precedenti decisioni operative della polizia. Un quartiere sottoposto a pattugliamenti frequenti può produrre statistiche elevate anche per infrazioni di modesta gravità, mentre attività analoghe commesse in aree meno sorvegliate possono rimanere assenti dalle registrazioni ufficiali.
Quando queste informazioni vengono utilizzate per addestrare un algoritmo predittivo, il sistema può confondere l’intensità dell’attività investigativa con la frequenza effettiva dei reati. Le zone caratterizzate da un maggior numero di segnalazioni vengono classificate come più rischiose e ricevono ulteriori pattugliamenti. L’aumento dei controlli genera nuove registrazioni, che vengono successivamente utilizzate per aggiornare il modello e confermare la precedente classificazione territoriale. Si forma così un ciclo di retroazione nel quale la previsione influenza il fenomeno osservato e contribuisce a produrre nuovi dati coerenti con la previsione stessa. La sociologa Sarah Brayne della Stanford University ha esaminato questo meccanismo, evidenziando come i dati utilizzati dalle autorità possano incorporare differenze sistematiche nelle modalità di osservazione e registrazione dei comportamenti. I reati commessi in luoghi pubblici risultano, per esempio, più facilmente osservabili, mentre una presenza sproporzionata di controlli in quartieri abitati da minoranze può riflettersi direttamente nei database impiegati per sviluppare i sistemi predittivi.
Un ulteriore problema riguarda la qualità e la provenienza delle informazioni storiche. Una ricerca pubblicata nel 2019 da studiosi della New York University e di altre istituzioni ha esaminato il fenomeno dei cosiddetti dirty data, dati contaminati da pratiche di polizia scorrette, discriminatorie o illegali, comprese registrazioni alterate e arresti ingiustificati. Analizzando tredici giurisdizioni statunitensi, i ricercatori hanno individuato in nove casi periodi nei quali dati riconducibili a pratiche problematiche avrebbero potuto essere impiegati per l’addestramento di sistemi predittivi. La semplice disponibilità di grandi quantità di osservazioni non assicura quindi che il dataset rappresenti fedelmente il fenomeno che si intende prevedere. Un modello può raggiungere buoni risultati nel riprodurre le statistiche storiche e contemporaneamente perpetuare le distorsioni contenute nei processi che le hanno generate. La questione coinvolge la distinzione fra reati effettivamente commessi, reati denunciati, violazioni individuate attraverso i controlli e attività amministrative di registrazione: variabili correlate, ma non equivalenti, che richiedono valutazioni separate quando vengono utilizzate per orientare le decisioni operative delle forze dell’ordine.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI).