
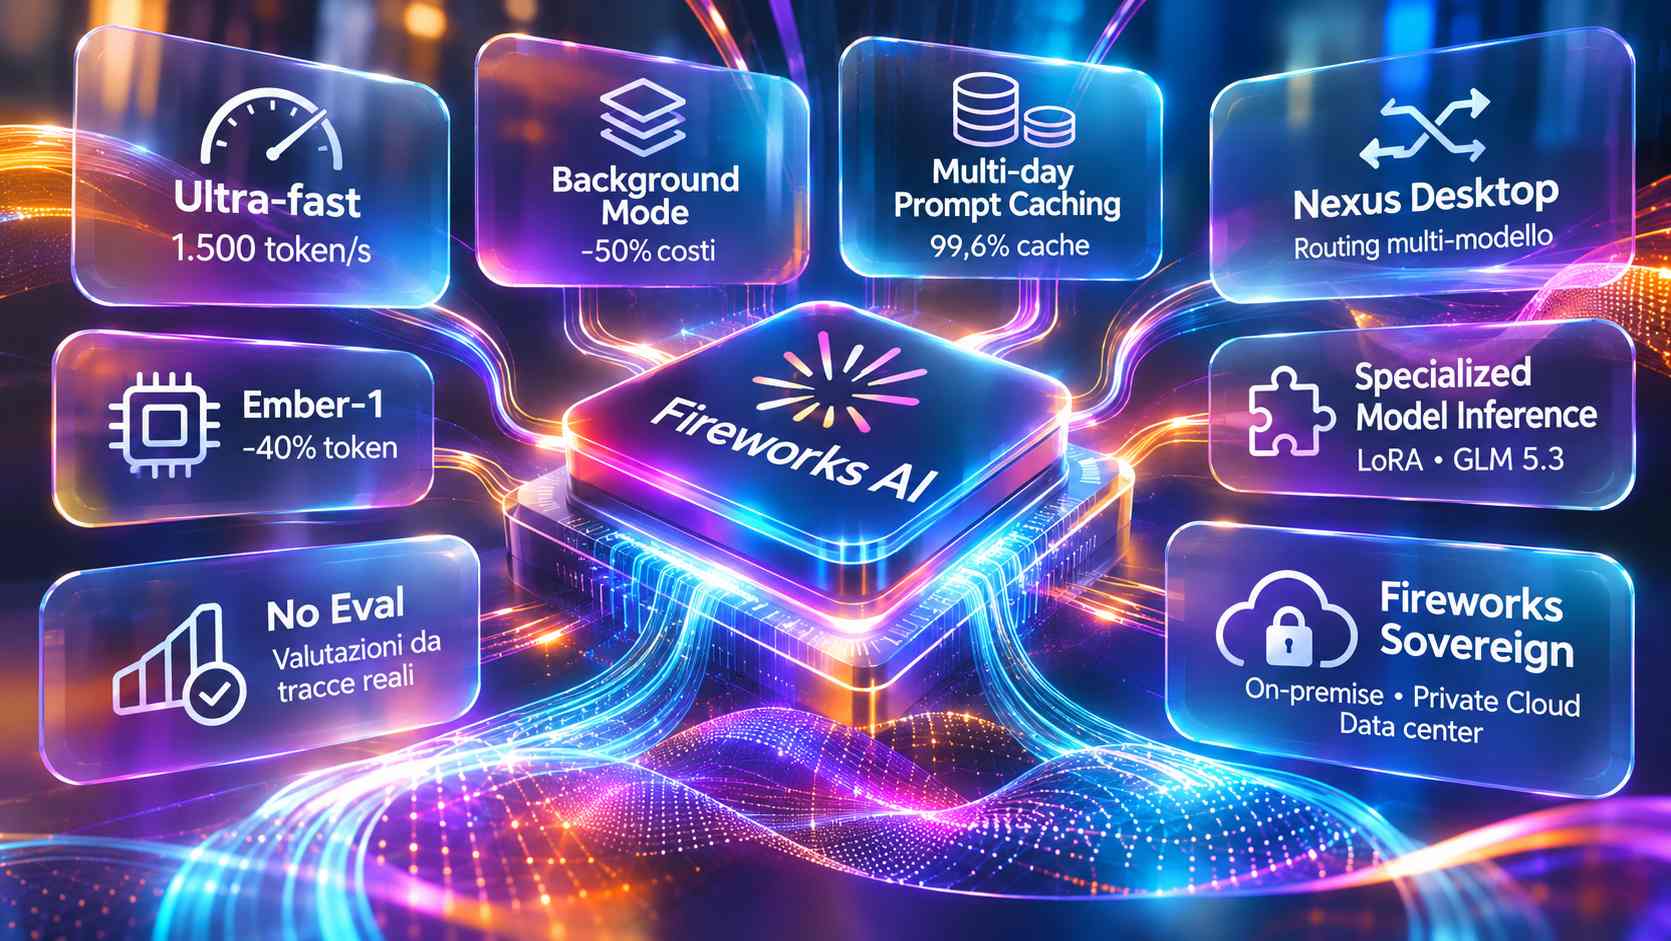
Fireworks AI ha presentato il 3 novembre 2026, durante la prima conferenza annuale Forge, una serie di aggiornamenti della propria piattaforma di inferenza destinati all’esecuzione di agenti AI, alla distribuzione di modelli specializzati e alla gestione delle infrastrutture aziendali. Tra le novità figura Ultra-fast, una modalità di inferenza disponibile in anteprima pubblica su GPU NVIDIA Blackwell, per la quale la società dichiara velocità fino a 1.500 token al secondo utilizzando DeepSeek V4.1 Flash. La soluzione è stata progettata per gli agenti che eseguono catene di operazioni successive, nei quali il tempo richiesto da ogni chiamata al modello contribuisce alla durata complessiva della procedura. In una valutazione interna composta da trenta turni consecutivi, Fireworks ha riportato una riduzione del tempo di completamento da circa un minuto a otto secondi. La piattaforma distingue inoltre i carichi sensibili alla latenza dalle attività differibili, introducendo modalità di esecuzione e tariffazione differenti in base alle esigenze operative.
Per i processi che possono essere eseguiti senza una risposta immediata, Background Mode permette di svolgere attività quali generazione di dati di valutazione e ricerche automatizzate con una tariffa ridotta del 50% rispetto all’esecuzione ordinaria. Multi-day Prompt Caching è destinato invece a ridurre il costo delle richieste che riutilizzano ripetutamente grandi quantità di contesto. L’importanza economica di questa componente emerge da una valutazione pubblicata da Fireworks su DeepSeek V4.1 Flash, nella quale il 99,6% dei token in ingresso era recuperato dalla cache e le relative tariffe rappresentavano comunque il 60% del costo complessivo. La società ha inoltre reso generalmente disponibili limiti di utilizzo serverless più elevati ed Elastic Burst, una funzionalità che consente di superare temporaneamente le soglie ordinarie di traffico sfruttando la capacità infrastrutturale disponibile, senza richiedere modifiche al codice o alla struttura tariffaria. La strategia comprende anche Ember-1, introdotto precedentemente come Research Preview, che nelle valutazioni del fornitore utilizza circa il 40% di token in meno rispetto a Kimi K3 a qualità comparabile ed è disponibile su infrastrutture serverless e dedicate.
Fireworks ha ampliato anche Nexus, il proprio sistema di instradamento delle richieste tra modelli aperti e proprietari, introducendo Nexus Desktop accanto all’interfaccia a riga di comando già disponibile. La tecnologia seleziona i modelli in base alle attività, alle preferenze operative e alle opportunità di riutilizzo della cache, centralizzando contemporaneamente il controllo dei consumi. Le integrazioni comprendono strumenti di programmazione e collaborazione quali Codex, Claude Code, Cursor, Visual Studio Code e OpenCode, con limitazioni specifiche per alcune connessioni desktop. Nexus Desktop è inizialmente disponibile per macOS su processori Apple silicon e Intel, mentre il supporto completo per Linux e Windows è previsto successivamente. I piani Nexus Pro partono da 8 dollari mensili, quelli Teams da 10 dollari per postazione al mese, mentre le configurazioni Enterprise aggiungono single sign-on, budget condivisi, governance e controlli di accesso.
Un altro aggiornamento riguarda No Eval, attualmente in anteprima privata, che utilizza le tracce dei sistemi in produzione e i segnali provenienti dalle applicazioni per costruire valutazioni specifiche delle attività svolte. Specialized Model Inference, disponibile in anteprima pubblica, permette invece di eseguire adattatori LoRA nel pool serverless condiviso di Fireworks, inizialmente sul modello GLM 5.3 Flash. La soluzione supporta adattatori con rango massimo 64 e fino a tre adattatori caricati per account sul modello iniziale, senza imporre costi di mantenimento durante l’inattività. Le tariffe indicate sono di 0,15 dollari per milione di token in ingresso, 0,03 dollari per quelli recuperati dalla cache e 0,50 dollari per milione di token in uscita. Il caricamento richiede meno di cinque minuti, mentre la prima richiesta può impiegare fino a un minuto. Gli adattatori condividono le GPU con altri clienti e, durante l’anteprima, non sono previste garanzie specifiche sulla latenza.
Fireworks Sovereign rappresenta infine l’estensione della piattaforma agli ambienti infrastrutturali controllati direttamente dai clienti ed è attualmente disponibile in anteprima privata. Il sistema permette di eseguire inferenza e addestramento in cloud aziendali, neocloud e data center privati, mantenendo dati e carichi computazionali entro i confini stabiliti dall’organizzazione. Fireworks gestisce la qualificazione dei cluster, la distribuzione dei modelli, gli aggiornamenti, il monitoraggio e l’ottimizzazione delle prestazioni, mentre il cliente mantiene il controllo delle architetture di rete, delle politiche di sicurezza, degli ingressi, del bilanciamento del traffico e delle connessioni esterne autorizzate. La società dichiara di gestire oltre 25.000 GPU negli ambienti dei clienti e segnala, per Sovereign, incrementi di throughput compresi tra il 20% e il 50% a parità di hardware, con circa 2,3 volte i token elaborati per dollaro di infrastruttura. È prevista anche una modalità ibrida che trasferisce temporaneamente i carichi ammissibili verso Fireworks Cloud, nelle regioni autorizzate dal cliente, quando la capacità locale è insufficiente, riportandoli successivamente sulle GPU aziendali. I nuovi prodotti estendono così l’offerta dalla semplice esecuzione dei modelli alla gestione coordinata di costi, specializzazione, valutazione e controllo infrastrutturale.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)