
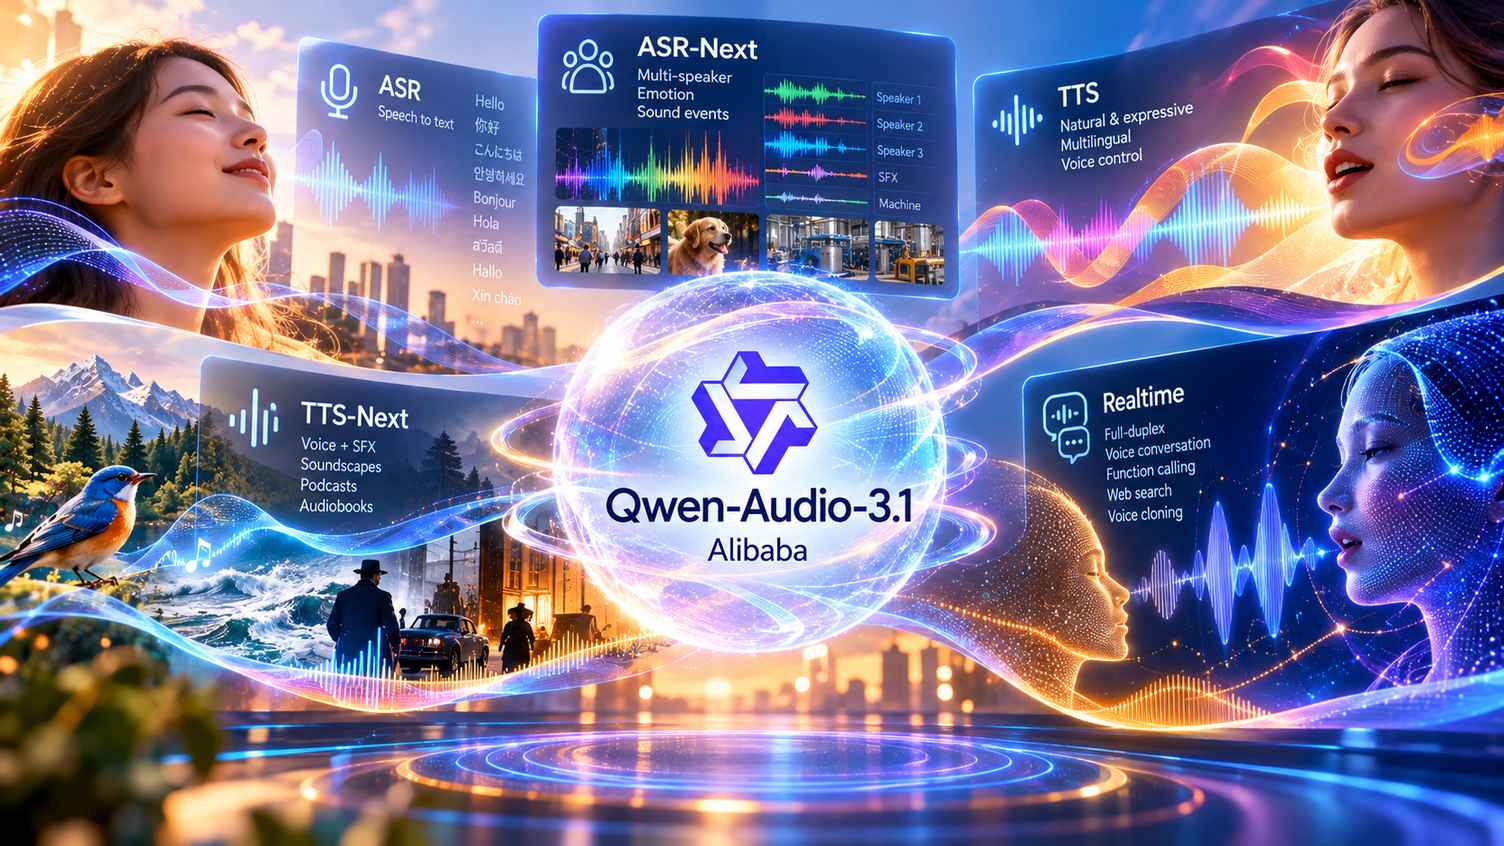
Alibaba ha presentato Qwen-Audio-3.1, una nuova famiglia composta da cinque modelli dedicati all’elaborazione e alla generazione audio, con l’obiettivo di coprire in un unico stack riconoscimento vocale, sintesi, comprensione del contenuto sonoro, generazione di effetti e conversazioni vocali in tempo reale. La gamma comprende Qwen-Audio-3.1-ASR, Qwen-Audio-3.1-ASR-Next, Qwen-Audio-3.1-TTS, Qwen-Audio-3.1-TTS-Next e Qwen-Audio-3.1-Realtime. Alibaba intende integrare questi modelli anche nel proprio ecosistema hardware e software, comprese applicazioni per occhiali AI, il robot desktop Eva e servizi agentici come Qwen Work e Quark. La novità più importante rispetto alle precedenti generazioni è l’estensione oltre la semplice trasformazione tra voce e testo: la nuova architettura viene proposta come piattaforma di comprensione e generazione audio più generale, capace di analizzare simultaneamente linguaggio parlato, identità e stato emotivo dei parlanti, rumori ambientali e suoni meccanici, oppure di creare in un solo passaggio voce, effetti sonori e ambiente acustico. Questa impostazione porta Qwen-Audio verso applicazioni che comprendono non soltanto trascrizione e assistenti vocali, ma anche produzione di podcast, audiolibri, videogiochi, video e contenuti audiovisivi nei quali il parlato deve essere integrato con un paesaggio sonoro completo.
Qwen-Audio-3.1-ASR è il modello dedicato al riconoscimento automatico del parlato e supporta 30 lingue oltre a 16 varietà regionali del cinese. Il sistema può eliminare automaticamente esitazioni, interiezioni e ripetizioni superflue durante la trascrizione, producendo un testo più pulito rispetto alla semplice conversione letterale dell’audio, e Alibaba dichiara una latenza fino a 160 millisecondi per la comparsa del primo carattere nelle configurazioni streaming. La variante ASR-Next amplia ulteriormente il compito di riconoscimento, perché non si limita alla trascrizione ma analizza il contenuto acustico nel suo complesso: distingue più interlocutori, associa timestamp alle singole parti della conversazione, rileva stati emotivi, identifica rumori ambientali e suoni prodotti da macchinari e può localizzare temporalmente eventi specifici all’interno della registrazione. Il modello può inoltre rispondere a domande relative al contenuto dell’audio, trasformando quindi la registrazione in una sorgente interrogabile invece che in un semplice flusso da convertire in testo. Questo tipo di funzione consente, per esempio, di individuare quando compare un determinato rumore, distinguere chi ha pronunciato una frase o estrarre informazioni da registrazioni lunghe senza dover prima effettuare manualmente segmentazione e analisi. Le API realtime di Alibaba utilizzano connessioni WebSocket e supportano flussi audio continui, con eventi server dedicati all’avvio, alla produzione dei risultati, alla conclusione e alla gestione degli errori.
Qwen-Audio-3.1-TTS introduce invece una sintesi vocale multilingue con supporto a 16 lingue e 20 dialetti o varietà regionali cinesi. Il sistema è stato progettato per mantenere una stessa identità vocale quando si passa da una lingua all’altra, evitando che il timbro cambi sensibilmente durante una sintesi multilingue, e permette di modificare attraverso istruzioni in linguaggio naturale caratteristiche come emozione, velocità e stile espressivo. Alibaba indica inoltre 86 tag vocali utilizzabili per controllare dettagli come risate, respiri, tosse e altre componenti paralinguistiche, rendendo il modello più adatto a contenuti nei quali la resa espressiva è importante quanto la pronuncia delle parole. Secondo i dati riportati al momento della presentazione, Qwen-Audio-3.1-TTS ha raggiunto la prima posizione nella classifica TTS di Artificial Analysis. TTS-Next amplia ulteriormente questa impostazione introducendo una vera generazione audio unificata: invece di produrre esclusivamente parlato, può combinare in un unico output voce, dialoghi fra più interlocutori, effetti sonori, suoni ambientali e soundscape completi. La documentazione ufficiale descrive il modello come un sistema AudioGen che accetta testo, timestamp e audio di riferimento e può generare podcast, scene cinematografiche, contenuti ambientali ed effetti audio in un singolo passaggio. Supporta file WAV, MP3 e PCM, fino a tre clip audio di riferimento e può generare contenuti della durata massima di quattro minuti nel caso dei podcast e di due minuti negli altri scenari previsti.
Qwen-Audio-3.1-Realtime è invece dedicato alla conversazione vocale diretta e utilizza un’architettura full-duplex, nella quale il sistema può ricevere e produrre audio contemporaneamente senza dover alternare rigidamente turni separati fra utente e assistente. Questa caratteristica permette al modello di reagire alle interruzioni dell’utente durante la risposta e di modificare la propria produzione senza attendere che l’intero output sia terminato. Alibaba ha aggiunto anche un sistema di rilevamento semantico dei turni che combina segnali acustici e comprensione del significato della frase, evitando per esempio di interpretare automaticamente un’esitazione come “uh” o “hmm” come la fine di un intervento. Nelle conversazioni con più persone, il modello può valutare il contesto per decidere quando intervenire e adattare la velocità della propria voce allo stato emotivo rilevato nell’interlocutore. Qwen-Audio-3.1-Realtime supporta inoltre function calling, ricerca Web e clonazione della voce, anche se la documentazione specifica che ricerca online e chiamata di funzioni non possono essere abilitate contemporaneamente nella stessa sessione. La variante Realtime Plus dispone di una finestra di contesto di 262.144 token, con input fino a 245.760 token e output massimo di 16.384, mentre la memoria conversazionale audio può conservare fino a 50 turni e circa 300 secondi complessivi di registrazione prima che le parti più vecchie vengano eliminate. La comunicazione può avvenire attraverso WebSocket, WebRTC oppure AOQ, il protocollo di Alibaba indicato per scenari che richiedono latenza stabile, resistenza alle reti deboli e soppressione integrata di eco e rumore.
Il lancio della famiglia 3.1 è accompagnato anche da una forte riduzione dei prezzi delle API, con tagli dichiarati fino al 70% per la sintesi vocale, all’85% per i modelli realtime e fino al 95% per il riconoscimento vocale. Per Qwen-Audio-3.1-ASR Alibaba indica in Cina un costo di ingresso che può scendere fino a circa 0,8 yuan per milione di token, mentre per Qwen-Audio-3.1-Realtime-Plus la documentazione internazionale riporta, nella regione Singapore, 0,8 dollari per milione di token per l’input testuale, 6,4 dollari per l’audio in ingresso, 6,4 dollari per l’output testuale e 24 dollari per l’audio generato; nella regione Beijing i prezzi risultano leggermente inferiori. Per TTS-Next, il listino della regione cinese indica invece 0,848 dollari per milione di token in ingresso e 1,696 dollari per milione di token in uscita. La riduzione dei costi è parte integrante del posizionamento della nuova gamma, perché l’obiettivo dichiarato è rendere più economica l’integrazione di agenti vocali in servizi B2B, call center, dispositivi intelligenti e applicazioni consumer, soprattutto nei casi in cui l’audio viene elaborato in modo continuativo e la spesa per inferenza diventa una componente rilevante del costo operativo. Alcune condizioni commerciali e disponibilità differiscono comunque tra regione cinese e API internazionali, per cui i prezzi effettivi dipendono dal modello e dall’area nella quale viene utilizzato il servizio.
Con Qwen-Audio-3.1 Alibaba sta quindi unificando in una stessa famiglia attività che in precedenza richiedevano servizi separati: trascrizione, diarizzazione, riconoscimento degli eventi sonori, interpretazione semantica dell’audio, sintesi vocale espressiva, generazione di paesaggi sonori e conversazione realtime. La distinzione fra i cinque modelli consente comunque di utilizzare sistemi specializzati quando non è necessaria l’intera pipeline, mentre TTS-Next e Realtime rappresentano i due estremi più avanzati della gamma: il primo punta alla creazione completa di contenuti sonori, il secondo all’interazione continua con agenti vocali capaci di comprendere interruzioni, contesto, emozioni e strumenti esterni. L’integrazione prevista con dispositivi e servizi Qwen indica inoltre che Alibaba non considera questa tecnologia esclusivamente come API cloud, ma come uno stack destinato a diventare la componente audio di assistenti, agenti e hardware AI all’interno del proprio ecosistema.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)