
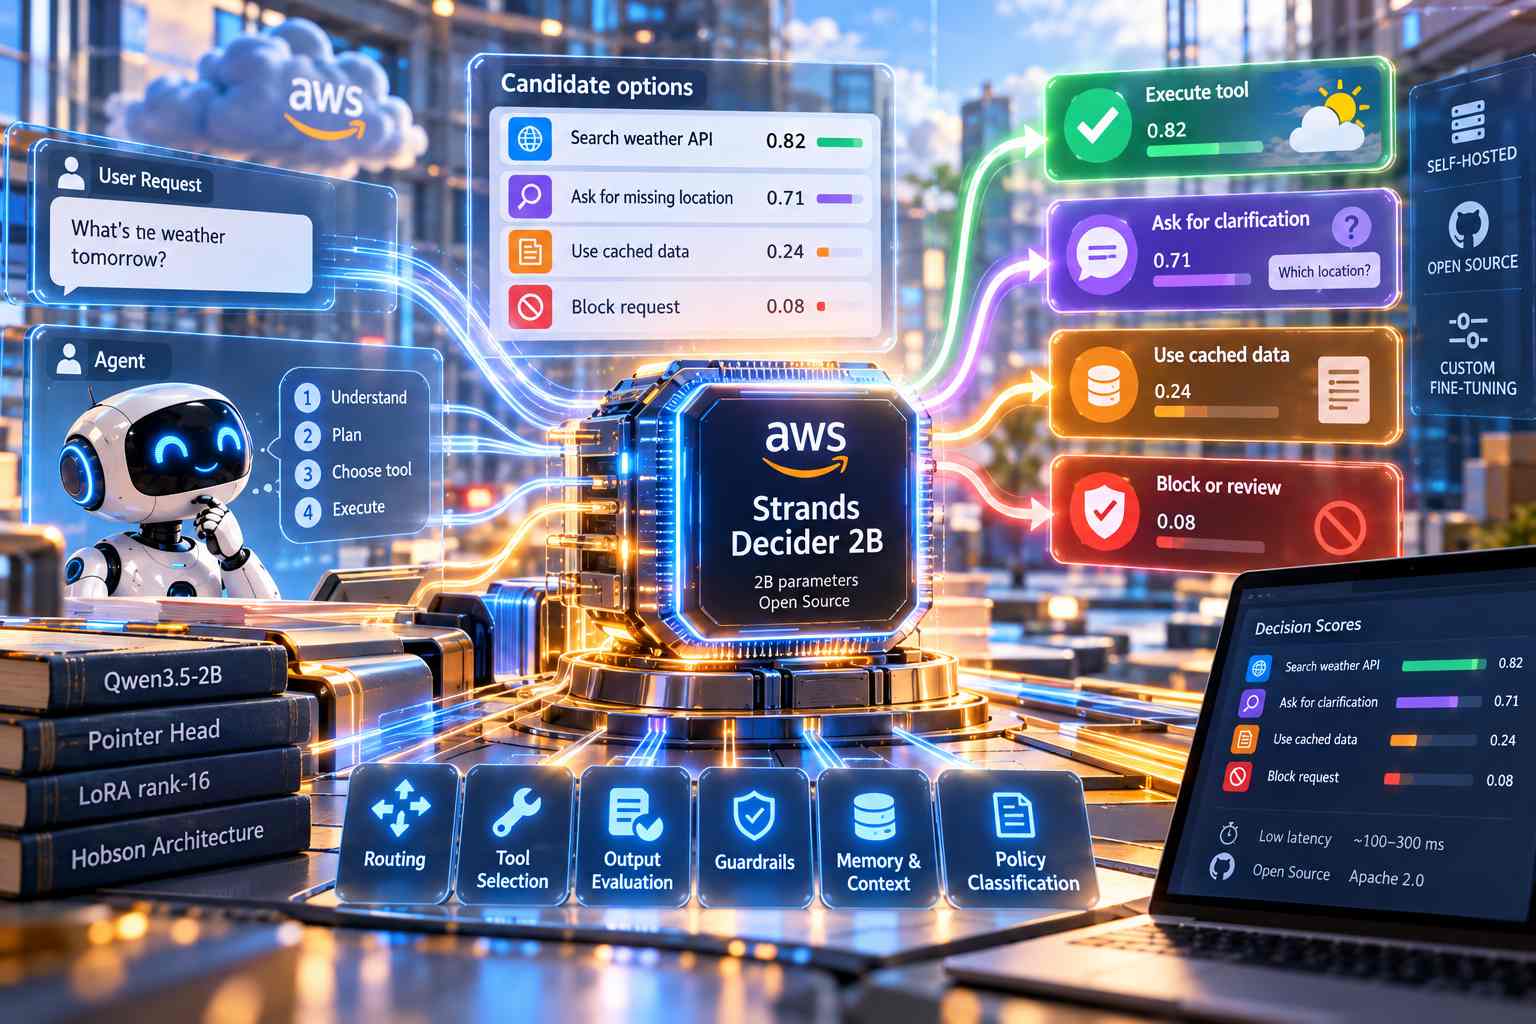
Amazon Web Services ha rilasciato Strands Decider 2B, un modello decisionale open source da circa 2 miliardi di parametri sviluppato nell’ambito di Strands Labs e pensato per essere inserito nei workflow degli agenti AI come livello rapido di valutazione prima dell’esecuzione di un’azione. A differenza di un normale modello linguistico generativo, non produce testo libero ma riceve un insieme definito di alternative e assegna direttamente un punteggio o una probabilità alle opzioni disponibili, per esempio decidendo se eseguire uno strumento, quale percorso scegliere, come classificare una richiesta o se una determinata azione debba essere bloccata o sottoposta a verifica. Il modello può quindi essere utilizzato per routing, selezione degli strumenti, valutazione degli output, guardrail, gestione della memoria e del contesto o classificazione delle policy, lasciando ai modelli generativi più grandi le operazioni che richiedono scrittura, coding o ragionamento complesso. Strands Decider 2B può essere scaricato e utilizzato gratuitamente con licenza Apache 2.0, mentre codice, pesi, dati di training e script sono stati pubblicati per consentire anche l’esecuzione locale, l’ispezione del processo di addestramento e ulteriori fine-tuning.
La base è Qwen3.5-2B, modificato rimuovendo la tradizionale LM head utilizzata per prevedere il token successivo e sostituendola con una pointer head di poco superiore al milione di parametri che assegna un punteggio alle risposte proposte. Il corpo del modello viene adattato attraverso un LoRA rank-16 e l’intera decisione viene prodotta con un singolo forward pass, senza dover generare sequenzialmente una risposta testuale. AWS definisce internamente questa architettura “Hobson” e il checkpoint pubblicato deriva da numerose iterazioni successive: la versione resa disponibile è v19, mentre l’intero percorso di sviluppo e le modifiche introdotte nelle varie revisioni sono documentati nel repository. La scelta della taglia da 2 miliardi di parametri è stata fatta per mantenere il modello sufficientemente piccolo da poter essere eseguito e sperimentato anche su hardware locale, ma abbastanza grande da gestire attività decisionali non banali.
Sul fronte della latenza, AWS indica tempi nell’ordine delle decine o centinaia di millisecondi, variabili soprattutto in funzione della lunghezza dell’input. Nei test su una NVIDIA RTX 3090, una precedente revisione del modello ha registrato circa 106 millisecondi di latenza mediana e 296 millisecondi al 95° percentile su 230 richieste, includendo anche il round trip HTTP; il primo avvio, escluso dalle statistiche perché legato al warm-up, aveva richiesto 7,7 secondi. Su un MacBook con chip M3, le attività più piccole hanno invece mostrato una latenza mediana di circa 150-153 millisecondi. Per accuracy e calibrazione AWS utilizza il set pubblico di JevBench e il Brier score, che misura l’affidabilità delle probabilità prodotte: la v19 si colloca intorno al 72% di accuratezza con un Brier score di circa 0,35 e AWS la posiziona tra i modelli pubblici competitivi della stessa fascia dimensionale. I risultati non costituiscono però un confronto diretto con Jev, che non compare nei grafici pubblicati, e non dimostrano quindi una superiorità generale in termini di accuratezza o velocità.
L’integrazione mostrata da AWS utilizza il sistema di intervention del framework Strands. In un esempio, un agente riceve una richiesta meteo priva della località e tenta di chiamare comunque lo strumento scegliendo autonomamente una città; prima dell’esecuzione, Strands Decider analizza conversazione e tool call e valuta se i parametri siano realmente fondati sulle informazioni fornite dall’utente e se sia prematuro procedere. In base al risultato, il sistema può consentire l’azione, negarla, chiedere una conferma umana oppure restituire feedback all’agente affinché richieda prima la località corretta. Le soglie e le domande utilizzate in questo esempio sono state definite manualmente e AWS sta ancora sviluppando librerie specifiche per integrare in modo più diretto questo tipo di modello: Decider fornisce quindi una valutazione probabilistica, mentre rimane all’applicazione stabilire quale comportamento associare al risultato.
Strands Decider 2B si inserisce in una nuova categoria di piccoli modelli specializzati che comprende anche Jev di TypeSafe AI, Mapika, Laya, Kev e altri progetti progettati per evitare il costo e la latenza di un LLM generativo quando il problema richiede soltanto una scelta tra opzioni note. Rispetto a Jev, disponibile come servizio API a 0,042 dollari per milione di token di input, la differenza più evidente è il modello di distribuzione: Strands Decider non dispone attualmente di un’API AWS ospitata e deve essere eseguito su infrastruttura propria o cloud, per cui il download è gratuito ma i costi effettivi di calcolo dipendono dall’hardware utilizzato. La pubblicazione completa di pesi, dati e training recipe permette però di mantenerne l’inferenza all’interno dell’infrastruttura aziendale, modificarlo e adattarlo a policy o casi d’uso specifici, rendendo l’apertura e la possibilità di self-hosting gli elementi centrali della proposta tecnica.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)