
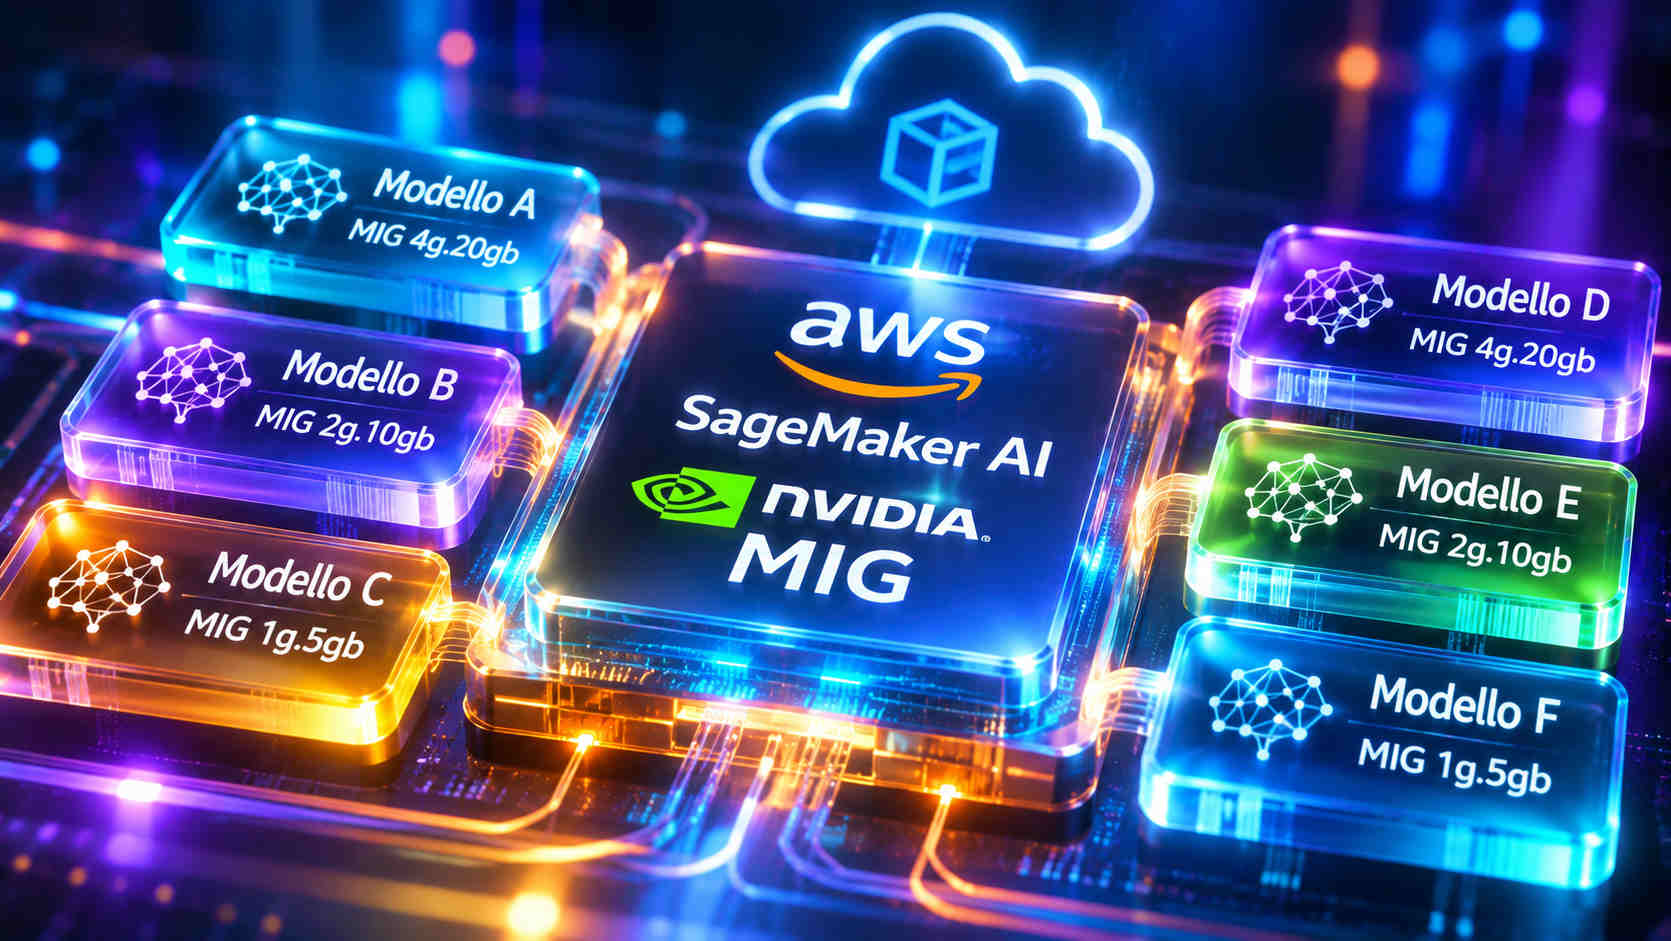
Amazon Web Services ha annunciato il 6 novembre 2026 il supporto della tecnologia NVIDIA Multi-Instance GPU, o MIG, negli endpoint di inferenza in tempo reale di Amazon SageMaker AI, consentendo di eseguire più modelli di intelligenza artificiale sulla stessa GPU attraverso partizioni hardware isolate. La funzionalità permette di assegnare a ciascun modello una porzione definita delle risorse di calcolo e della memoria dell’acceleratore, evitando che ogni distribuzione debba necessariamente occupare una GPU completa. Il sistema si rivolge agli ambienti che gestiscono numerosi modelli con esigenze computazionali differenti, nei quali l’assegnazione esclusiva di un acceleratore può lasciare inutilizzata una parte significativa della capacità disponibile. Ogni partizione MIG dispone di risorse dedicate, con isolamento garantito a livello hardware, e mantiene il modello residente in memoria. Questa configurazione evita anche i ritardi dovuti al caricamento iniziale dei modelli che possono verificarsi negli endpoint multimodello tradizionali, dove più modelli condividono il dispositivo e vengono caricati in funzione delle richieste.
Il supporto è limitato agli endpoint in tempo reale che utilizzano gli inference components di SageMaker, ossia componenti attraverso i quali è possibile distribuire più modelli sul medesimo endpoint e specificare le risorse computazionali loro assegnate. Non sono supportati il partizionamento degli endpoint a modello singolo, gli endpoint serverless, i pool di istanze eterogenee e i carichi asincroni, poiché l’invocazione asincrona non permette di indirizzare direttamente uno specifico inference component. Salesforce ha collaborato alla definizione dei requisiti e alla validazione iniziale dell’implementazione. Richard Chang, software engineering architect dell’azienda, ha indicato tra gli obiettivi il consolidamento sicuro dei carichi, il miglioramento dell’utilizzo delle GPU e la riduzione dei costi di inferenza, mantenendo prestazioni prevedibili e isolamento tra modelli. Salesforce intende verificare ulteriormente questi vantaggi utilizzando carichi rappresentativi della propria produzione, senza che le aspettative iniziali costituiscano già risultati operativi misurati.
La configurazione è gestita attraverso due campi opzionali delle API SageMaker. AcceleratorPartitionLayouts definisce la suddivisione delle GPU associate a una production variant, mentre AcceleratorPartitionType specifica il profilo di partizione richiesto da un inference component. Non vengono introdotte nuove operazioni API, nuove tipologie di risorse o ulteriori autorizzazioni AWS Identity and Access Management; le configurazioni esistenti continuano a funzionare senza modifiche quando i due campi non vengono utilizzati. Il layout selezionato viene applicato uniformemente a tutte le GPU di tutte le istanze appartenenti alla variante. In un esempio di AWS, ciascuna delle otto GPU A100 di un’istanza ml.p4d.24xlarge viene suddivisa in tre partizioni con profili mig-4g.20gb, mig-2g.10gb e mig-1g.5gb, ottenendo complessivamente 24 partizioni nell’endpoint. Ogni replica di un inference component occupa una partizione del profilo richiesto e le chiamate InvokeEndpoint continuano a indirizzare il modello attraverso il nome del componente, senza richiedere identificatori specifici delle partizioni.
Il partizionamento aggiunge, secondo le prove AWS, circa 17 secondi alla fase di provisioning degli acceleratori. L’isolamento riguarda memoria e risorse di calcolo della GPU, ma non si estende automaticamente all’intero sistema: CPU, memoria dell’host, archiviazione, rete e instradamento delle richieste rimangono condivisi tra i modelli distribuiti sulla stessa istanza. Un inference component che richiede un profilo non presente nel layout configurato viene rifiutato, senza ricevere automaticamente una GPU completa. La modifica del layout su un endpoint già operativo richiede la creazione di un nuovo endpoint e la migrazione del traffico, mentre lo spostamento di un componente verso un profilo differente comporta la creazione di un nuovo componente. Le partizioni non possono inoltre estendersi su GPU differenti: i modelli che richiedono un acceleratore completo oppure più acceleratori devono continuare a utilizzare dispositivi non partizionati.
AWS ha accompagnato il rilascio con una valutazione prestazionale che confronta una partizione mig-3g.40gb di una NVIDIA H100 con una GPU A100 completa da 40 GB, utilizzando Llama-3.1-8B-Instruct su endpoint SageMaker di produzione. La prova ha mantenuto identici il numero di repliche, i container, i tokenizer e le configurazioni client, impiegando genai-bench per simulare cinque tipologie di traffico con livelli di concorrenza compresi tra 2 e 512 richieste. La partizione H100 utilizzata comprende tre delle sette quote di streaming multiprocessor e quattro delle otto unità di memoria disponibili secondo il sistema MIG. Nei punti di carico in cui il vantaggio economico risultava maggiore, AWS ha registrato una produzione di token in uscita al secondo superiore del 53-89% rispetto all’A100 completa. La latenza tra token consecutivi è risultata inferiore dell’8,9-42,1%, mentre il tempo necessario per produrre il primo token è diminuito del 5,6-47,5%. Ai livelli massimi di concorrenza, con carichi da 6.000 e 8.000 token, l’A100 non ha rispettato la scadenza di servizio per una quota compresa tra un terzo e metà delle richieste, mentre la partizione H100 non ha registrato richieste fuori tempo nelle condizioni sperimentali indicate.
L’analisi economica riporta una riduzione del costo per milione di token generati compresa tra il 18% e il 34%, ma soltanto oltre determinate soglie di utilizzo. Per prompt da 100 token, il punto di pareggio viene raggiunto a una concorrenza di 64 richieste, mentre per prompt da 8.000 token la soglia scende a quattro richieste concorrenti. Al di sotto di questi valori, l’utilizzo di una A100 completa rimane economicamente più conveniente nelle configurazioni confrontate. Le famiglie di istanze supportate comprendono P4d con NVIDIA A100 da 40 GB e un massimo di sette partizioni per GPU, P5 con H100 da 80 GB e sette partizioni, G7 con RTX PRO 4500 Blackwell da 32 GB e due partizioni, e G7e con RTX PRO 6000 Blackwell Server Edition da 96 GB e quattro partizioni. La disponibilità geografica comprende Virginia settentrionale, Ohio, Oregon, Singapore, Tokyo, Francoforte e Irlanda, subordinatamente alle quote e alla disponibilità delle istanze nelle singole regioni.
La fatturazione continua a riguardare l’intera istanza GPU, indipendentemente dal numero di partizioni effettivamente utilizzate. Il vantaggio economico deriva quindi dalla possibilità di distribuire più carichi sulle risorse acquistate, non da una riduzione automatica del prezzo orario dell’istanza. Gli endpoint partizionati e i relativi inference components non pubblicano inoltre su CloudWatch le metriche di utilizzo di GPU, CPU e memoria, mentre restano disponibili le metriche relative alle invocazioni e alle latenze. Per il profilo mig-1g.10gb sulle istanze P4d è richiesto almeno il driver NVIDIA R525 e AWS indica la necessità di utilizzare una AMI di inferenza aggiornata, poiché l’immagine predefinita non soddisfa questo requisito. L’effettivo miglioramento dei costi e delle prestazioni dipende pertanto dalla distribuzione dei carichi, dalla dimensione dei modelli, dalla concorrenza e dalla capacità di sfruttare le partizioni assegnate.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)