
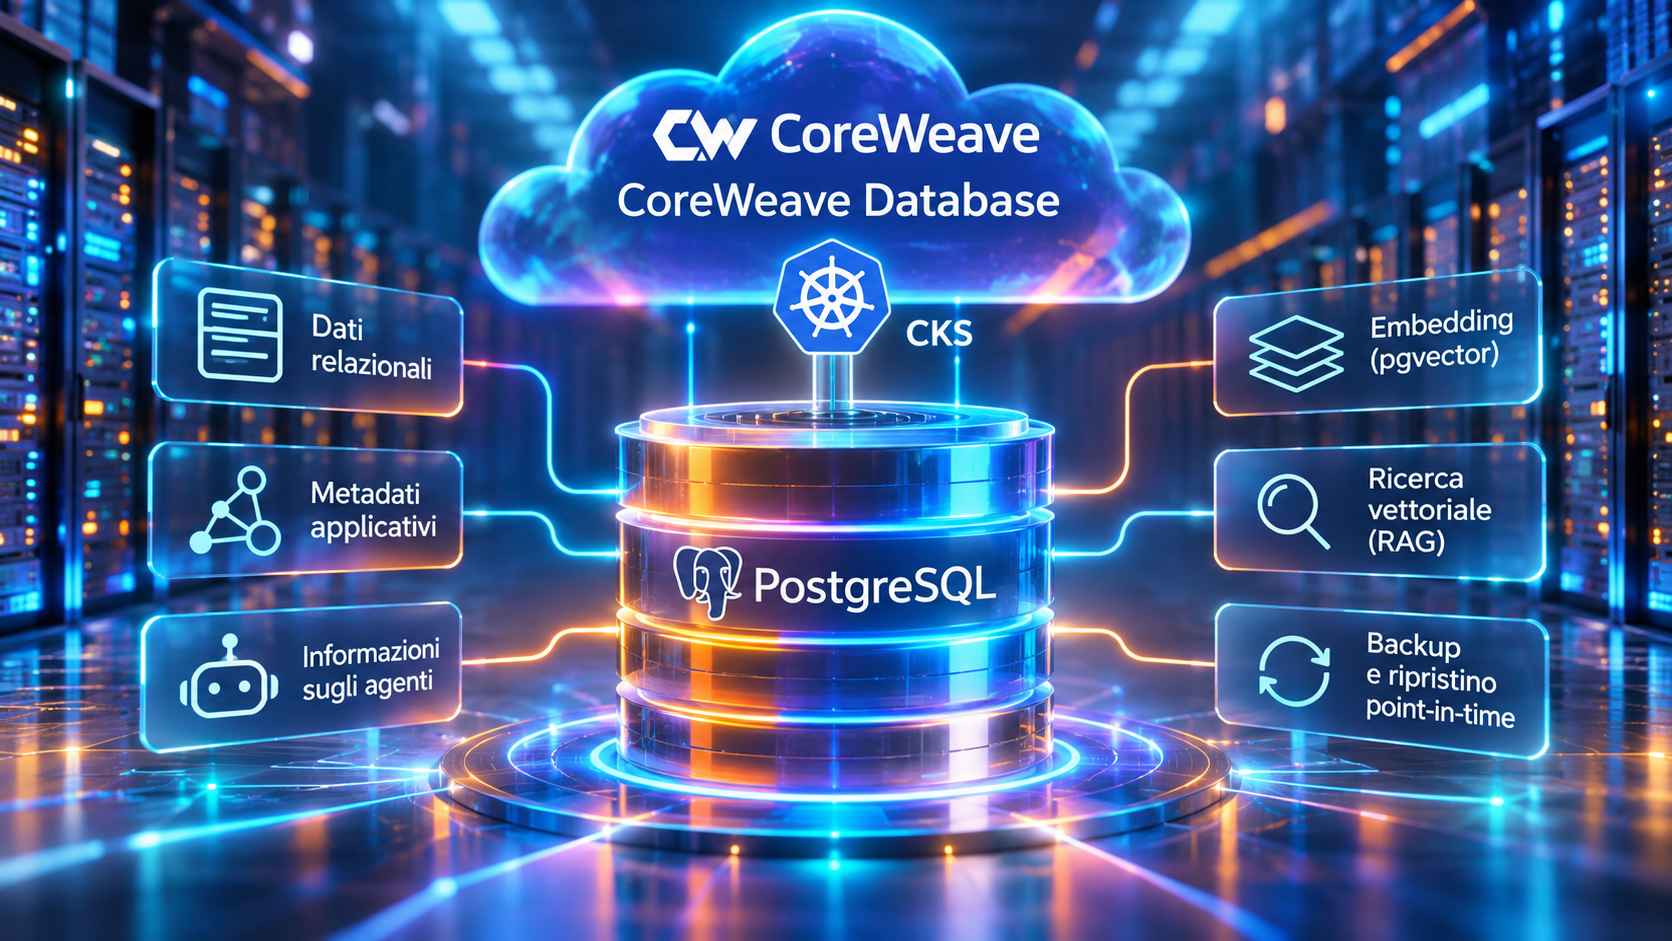
CoreWeave ha annunciato l’11 novembre 2026 la disponibilità generale di CoreWeave Database, un servizio PostgreSQL completamente gestito che opera direttamente all’interno dei cluster CoreWeave Kubernetes Service, denominati CKS. La soluzione è progettata per mantenere database relazionali, metadati applicativi, informazioni sugli agenti ed embedding nello stesso ambiente infrastrutturale utilizzato per addestramento e inferenza dei modelli AI. Le istanze PostgreSQL vengono eseguite su nodi CPU appartenenti al cluster del cliente e le applicazioni vi accedono tramite un servizio Kubernetes interno, evitando la necessità di collegamenti verso database collocati su altri cloud. Questa architettura elimina il passaggio di rete esterno per le connessioni locali e riduce la necessità di amministrare infrastrutture separate, configurare percorsi di trasferimento dei dati e mantenere differenti ambienti di sicurezza. CoreWeave ha introdotto il servizio per rispondere alle esigenze delle applicazioni AI che, oltre agli acceleratori GPU, utilizzano continuamente stati persistenti, archivi di informazioni e dati vettoriali.
L’infrastruttura distribuisce l’istanza PostgreSQL primaria e le repliche di lettura su host differenti, utilizzando CoreWeave Distributed File Storage per conservare i dati attivi. La gestione dei nodi primari, delle repliche e del failover automatico si basa su CloudNativePG, operatore Kubernetes open source specializzato in PostgreSQL. CoreWeave aggiunge monitoraggio, manutenzione e gestione operativa. I backup continui sono abilitati per impostazione predefinita e il recupero point-in-time consente di ripristinare il database a un momento compreso nella finestra di conservazione disponibile. Sono supportati anche backup pianificati e richiesti manualmente, oltre al ripristino di una copia completa in un cluster separato, utilizzabile per verifiche senza sostituire il database originale. L’accesso ai database rimane privato all’interno del cluster, con cifratura dei dati a riposo e durante il trasferimento, gestione dei certificati TLS, aggiornamenti di sicurezza, ruoli PostgreSQL, policy di rete Kubernetes e registrazione delle attività.
Il servizio include il supporto a pgvector, estensione che consente di memorizzare embedding ed eseguire ricerche vettoriali direttamente all’interno di PostgreSQL. Le applicazioni possono quindi utilizzare lo stesso database per informazioni relazionali e recupero semantico dei contenuti nei sistemi RAG, senza dover necessariamente predisporre un archivio vettoriale indipendente. La compatibilità PostgreSQL permette di migrare database provenienti da altri cloud o installazioni autogestite con gli strumenti nativi della piattaforma, mantenendo il controllo su schemi, utenti, interrogazioni e dati. La gestione è disponibile attraverso CoreWeave Cloud Console, kubectl, strumenti GitOps come Argo CD e Flux oppure controller personalizzati basati sulle API Kubernetes. La risorsa CWDBCluster definisce topologia, capacità di calcolo, storage, accesso e ripristino, mentre CWDBBackup consente di creare backup su richiesta. Tra i primi utilizzatori figura Advaita Bio, che ha trasferito il proprio database di letteratura biomedica da un altro cloud a CoreWeave, collocandolo accanto alle applicazioni che lo interrogano.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)