
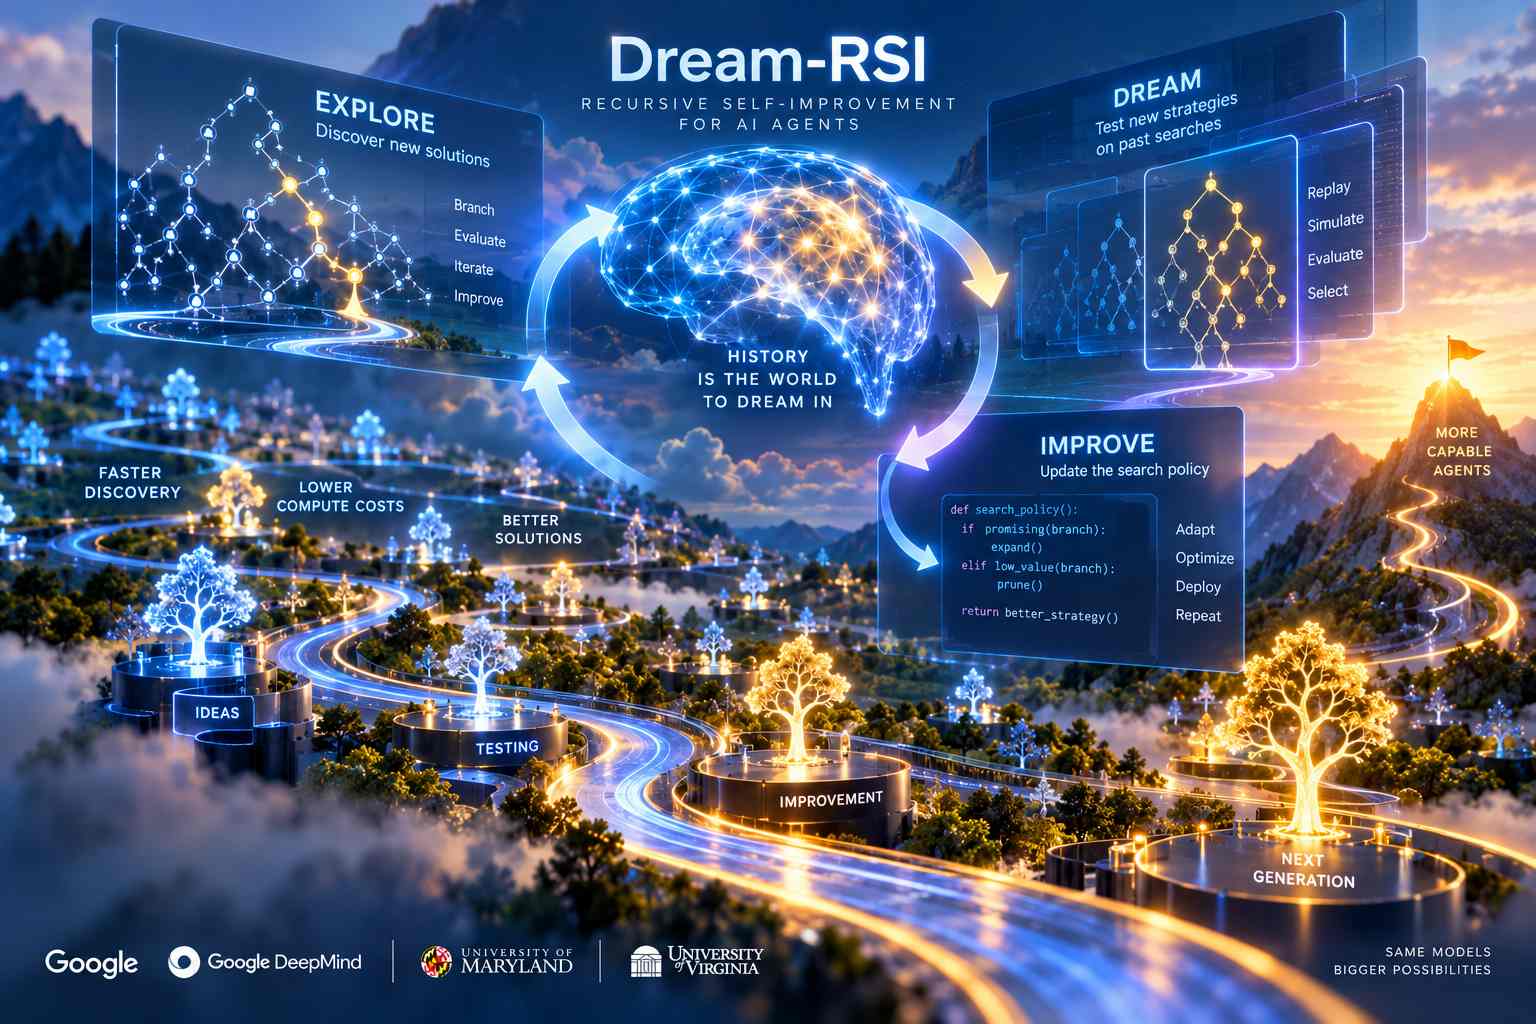
Un gruppo di 17 ricercatori di Google, Google DeepMind, University of Maryland e University of Virginia ha presentato Dream-RSI, un framework per migliorare ricorsivamente il modo in cui gli agenti AI esplorano spazi di ricerca complessi senza modificare il modello di base. Il sistema interviene sul livello di orchestrazione che decide quando aprire nuovi rami di ricerca, quante alternative esplorare in parallelo e quando interrompere una direzione poco promettente. Invece di ripetere ogni volta costose esecuzioni dell’agente per verificare se una nuova strategia di esplorazione sia migliore della precedente, Dream-RSI riutilizza le ricerche già effettuate come ambiente di simulazione. Nei test descritti dagli autori il metodo ha mantenuto o migliorato la qualità delle soluzioni riducendo sensibilmente il costo della scoperta e, nel confronto con SimpleTES su un problema di ottimizzazione Lasso, ha richiesto fino a 162 volte meno chiamate al discovery agent.
Il problema affrontato da Dream-RSI riguarda soprattutto i processi di discovery nei quali un agente deve proporre, modificare e valutare migliaia di possibili soluzioni prima di trovarne una migliore. Le strategie di esplorazione tradizionali sono spesso definite manualmente e rimangono sostanzialmente fisse anche quando aumenta la quantità di esperienza accumulata: possono quindi continuare a investire compute in direzioni che in passato si sono già dimostrate poco produttive. Ottimizzare la stessa strategia durante l’esecuzione non elimina necessariamente il problema, perché ogni nuova policy deve essere provata attraverso rollout reali lunghi e costosi, producendo un feedback meta-level ritardato. Il principio di Dream-RSI è che questo feedback sia in gran parte già disponibile nella cronologia delle esecuzioni precedenti e che quindi non sia necessario pagare nuovamente per ottenerlo.
Ogni sessione di esplorazione viene perciò registrata sotto forma di historical discovery tree, un albero che conserva le decisioni prese dall’agente e gli esiti ottenuti nei diversi rami. Una volta completata una ricerca, l’albero non viene trattato semplicemente come testo da inserire in un prompt o come dataset per un successivo fine-tuning, ma viene trasformato in un replay simulator. Una nuova policy di esplorazione può percorrere lo stesso albero in un ordine differente e verificare quali risultati avrebbe ottenuto scegliendo rami, livelli di parallelismo e condizioni di arresto diversi, senza eseguire nuovamente il discovery agent né l’evaluator. Gli autori precisano che non si tratta di un world model appreso che tenta di prevedere cosa accadrebbe in una situazione mai vista: il simulatore restituisce gli esiti effettivamente registrati nella parte dello spazio di ricerca già visitata e non genera nuovi risultati per rami che non erano stati esplorati. È proprio questa caratteristica a permettere migliaia di valutazioni off-policy a costo molto inferiore rispetto a nuovi rollout online.
Il ciclo Dream-RSI è articolato in tre passaggi. Nella fase Online Explore la policy corrente orchestra il coding agent, che costruisce un nuovo discovery tree e registra tutte le relative tracce. Nella seconda fase l’albero viene aggiunto a un repository di replay simulator riutilizzabili. Durante il Dreaming-based Policy Improvement un agente modifica invece il codice della policy di esplorazione, produce più varianti e le valuta ripercorrendo le cronologie già disponibili; la versione che ottiene il risultato migliore viene quindi distribuita nel round successivo e torna online a generare un nuovo albero. Ogni nuova iterazione aumenta così la quantità di esperienza sulla quale potranno essere testate le policy future. La policy già in uso viene mantenuta tra i candidati durante la selezione, per cui sul replay storico la nuova versione selezionata non può ottenere un punteggio inferiore a quella precedente, anche se questo non costituisce una garanzia che migliori allo stesso modo su problemi futuri non ancora osservati.
Il termine recursive self-improvement viene quindi utilizzato in un senso specifico. Dream-RSI non modifica i pesi del coding agent attraverso gradient descent, non effettua fine-tuning del modello e non sostituisce autonomamente il modello sottostante con una versione più capace. Rimangono fissi anche evaluator e strumenti; ciò che cambia ricorsivamente è il programma che governa la ricerca. La nuova policy produce nuove esplorazioni online, queste generano nuovi alberi e gli alberi appena accumulati diventano a loro volta l’ambiente nel quale sviluppare la policy successiva. Gli autori descrivono questo meccanismo con l’espressione “history is the world to dream in”: la cronologia delle scoperte costituisce il mondo nel quale il sistema può provare molte strategie alternative prima di scegliere quale portare nuovamente nell’ambiente reale.
La valutazione comprende otto task distribuiti tra algorithm engineering, ottimizzazione matematica e progettazione di kernel GPU. Per l’algorithm engineering i ricercatori hanno utilizzato un problema relativo al percorso di regolarizzazione Lasso, nel quale un coding agent deve produrre implementazioni più efficienti di un algoritmo di ottimizzazione e valutarle su sei dataset. Con Gemini 3.1 Pro, Dream-RSI ha ridotto il tempo medio di esecuzione delle soluzioni ottenute da 3.587,1 a 2.931,0 millisecondi rispetto a Recursive Fixed Exploration e ha ridotto le chiamate del discovery agent da 550 a 317, corrispondenti a circa 1,74 volte meno compute dedicato alla scoperta. Il confronto con SimpleTES è più ampio: quest’ultimo utilizzava gpt-oss-120b e richiedeva 51.200 generazioni, mentre Dream-RSI ne impiegava 317, da cui deriva la riduzione fino a 162 volte citata dagli autori. Con Gemini 3.7 Flash, il runtime medio è passato invece da 2.516,7 a 2.350,6 millisecondi e le chiamate da 3.200 a 1.879.
I test sono stati estesi alla programmazione di kernel GPU, un dominio nel quale l’agente deve ottimizzare contemporaneamente accessi alla memoria, parallelizzazione, correttezza numerica e comportamento specifico dell’hardware. Sul task ConvDiv Dream-RSI ha modificato dinamicamente la quantità di compute utilizzata durante i round: il numero di tentativi valutati è sceso inizialmente da circa 110 a 50 e successivamente è risalito verso 90 quando i miglioramenti hanno cominciato a stabilizzarsi, mostrando che la policy appresa non applica lo stesso budget in ogni fase della ricerca. Nei benchmark VGG16 e LayerNorm il sistema ha raggiunto prestazioni comparabili utilizzando rispettivamente 2,43 e 1,79 volte meno generazioni rispetto alla baseline a esplorazione fissa, mentre su ConvDiv e ConvMax ha ottenuto rispettivamente prestazioni 2,09 e 1,44 volte superiori mantenendo un budget comparabile.
Nel terzo gruppo di test, dedicato all’ottimizzazione matematica, Dream-RSI è stato applicato a problemi nei quali il sistema deve scoprire programmi o configurazioni con punteggi progressivamente migliori. I ricercatori riportano risparmi di budget superiori a 50 volte rispetto a SimpleTES in alcuni confronti e risultati uguali o superiori alla baseline selezionata in due dei tre task esaminati. Complessivamente, il framework non mostra quindi un vantaggio uniforme della stessa entità in ogni dominio, ma i test indicano che la possibilità di riutilizzare gratuitamente le traiettorie già pagate può migliorare sensibilmente il rapporto tra qualità delle soluzioni e quantità di compute necessaria alla loro scoperta.
Uno dei vincoli più importanti deriva proprio dal funzionamento del replay simulator. Dream-RSI può valutare una nuova policy soltanto sulle parti dello spazio che sono state realmente esplorate in precedenza: se una politica avrebbe scelto un ramo mai visitato, il sistema non possiede un risultato da restituire e non può inventarlo. Anche il miglioramento garantito dalla selezione della policy vale quindi sul patrimonio storico disponibile e non implica che la stessa policy ottenga necessariamente risultati superiori su nuovi task o distribuzioni differenti. Per ridurre il rischio di adattamento eccessivo a una singola cronologia, Dream-RSI accumula più simulatori a ogni round e valuta le policy sull’insieme crescente delle esperienze precedenti; vengono inoltre applicate regole di prefix-only observability che impediscono alla policy di utilizzare informazioni future dell’albero e limitazioni che vietano di codificare direttamente identificativi dei nodi vincenti o punteggi target conosciuti in anticipo.
Il framework viene presentato come un livello di orchestrazione leggero e programmabile che può essere applicato senza modificare il coding agent sottostante. Questo consente di separare il miglioramento della strategia di esplorazione dall’addestramento del modello e rende potenzialmente riutilizzabili gli stessi meccanismi con agenti differenti. La pagina ufficiale del progetto riporta al momento il paper, una demo interattiva del ciclo di esplorazione e dreaming e un repository GitHub, mentre il rilascio completo del codice e degli script di riproduzione risulta ancora in preparazione. L’elemento centrale di Dream-RSI rimane quindi il riutilizzo sistematico delle esperienze di discovery già accumulate: anziché trattare i fallimenti delle ricerche precedenti come compute consumato e ormai perso, il framework li conserva insieme ai successi e li trasforma in un ambiente nel quale sviluppare a basso costo la strategia che guiderà la ricerca successiva.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)