
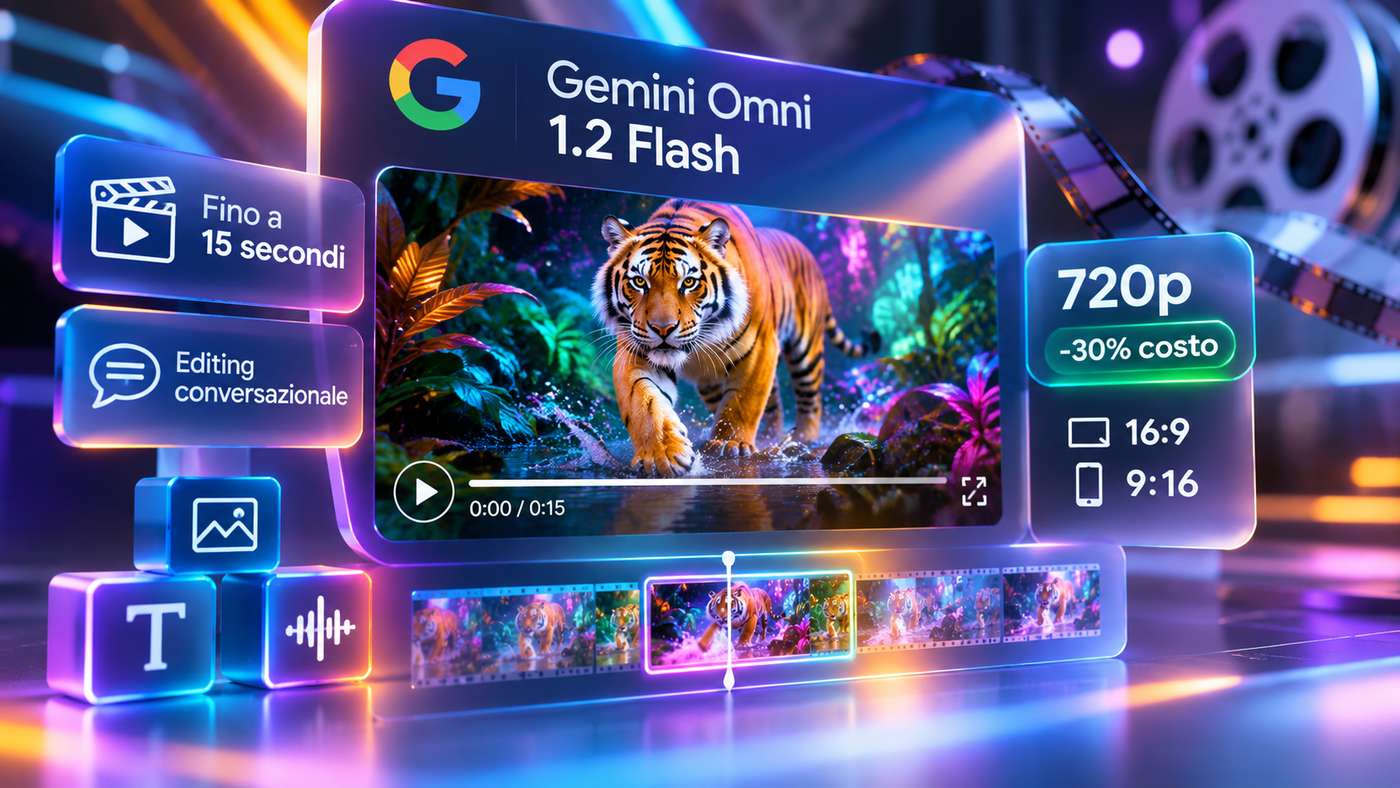
Google ha annunciato Gemini Omni 1.2 Flash, un aggiornamento del proprio modello per la generazione e la modifica di contenuti video con audio sincronizzato, introducendo sequenze native fino a 15 secondi, funzionalità di editing conversazionale su più interazioni e una riduzione del 30% del costo di generazione alla risoluzione di 720p. La nuova versione estende il limite precedente di 10 secondi previsto da Omni 1.1 Flash, consentendo di produrre in una sola generazione sequenze più articolate, presentazioni di prodotti, dimostrazioni e contenuti pubblicitari destinati alle piattaforme digitali. Il sistema elabora istruzioni testuali, immagini e video di riferimento e genera contenuti audiovisivi nei quali le componenti visive e sonore vengono prodotte in modo coordinato. Attraverso le API sono supportate durate espresse in secondi interi da 3 a 15, con una durata predefinita di 10 secondi. La risoluzione standard è 720p, con formato orizzontale 16:9 e supporto al formato verticale 9:16. I flussi di lavoro possono utilizzare risoluzioni iniziali di 360p o 720p per le prove e applicare successivamente un aumento della risoluzione a 1080p o 4K ai risultati selezionati.
La principale novità operativa è rappresentata dalla possibilità di modificare un video attraverso richieste successive formulate in linguaggio naturale, senza dover ricostruire integralmente il contenuto a ogni intervento. Gli utenti possono chiedere di sostituire un prodotto presente nella scena, cambiare lo sfondo, modificare l’illuminazione, trasformare le condizioni meteorologiche oppure variare il rapporto d’aspetto, conservando gli elementi non coinvolti dalle istruzioni. La continuità viene gestita attraverso un identificatore associato all’interazione precedente, che consente al sistema di recuperare il contesto della generazione senza richiedere un nuovo caricamento del video a ogni modifica. Ogni richiesta può comprendere fino a sei immagini di riferimento, con un massimo di tre immagini per ciascun personaggio e supporto a due personaggi distinti. Questa organizzazione permette di utilizzare riferimenti multipli per mantenere caratteristiche riconoscibili di persone, oggetti e ambientazioni durante revisioni successive, separando le modifiche richieste dagli elementi che devono rimanere invariati.
Gemini Omni 1.2 Flash distingue la generazione nativa dall’estensione di sequenze già esistenti. La funzione di estensione può aggiungere da 3 a 10 secondi per singola operazione, utilizzando gli ultimi 10 secondi del video precedente come contesto per produrre il segmento successivo, fino a una durata complessiva di 30 secondi. Il sistema non permette invece di aggiungere nuove immagini all’inizio della sequenza o di inserire materiale in una posizione intermedia del video. La generazione basata sull’interpolazione fra un fotogramma iniziale e uno finale rimane limitata a durate comprese fra 3 e 10 secondi. Queste restrizioni delimitano le possibilità di montaggio offerte direttamente dal modello: l’estensione interviene sulla parte conclusiva del contenuto, mentre le operazioni di modifica conversazionale agiscono sugli elementi della sequenza già generata. L’obiettivo dichiarato è rendere più efficiente un processo creativo nel quale sia necessario intervenire ripetutamente su prodotti, personaggi, ambientazioni o caratteristiche visive senza ripartire ogni volta da una generazione completamente nuova.
La struttura tariffaria della Gemini API prevede un costo di 12 dollari per milione di token video in uscita, con una contabilizzazione di 5.792 token per secondo di video a 720p. Il prezzo indicativo è quindi di circa 0,07 dollari al secondo, corrispondenti a 0,70 dollari per una sequenza di 10 secondi e a circa 1,04 dollari per una generazione di 15 secondi. Gli input testuali, visivi e video vengono fatturati a 1,50 dollari per milione di token. Il modello non è disponibile nel livello gratuito delle API. Google ha previsto un periodo di transizione di quattro settimane durante il quale Gemini Omni 1.1 Flash continuerà a essere utilizzabile. Dal 3 dicembre 2026 le richieste API indirizzate alla versione precedente saranno automaticamente reindirizzate alla 1.2, senza richiedere modifiche al codice delle integrazioni esistenti e applicando le nuove tariffe ridotte. Questa modalità permette agli sviluppatori di mantenere temporaneamente la compatibilità con le implementazioni precedenti, pur introducendo una data definita per la migrazione automatica.
Google attribuisce alla nuova versione miglioramenti nella stabilità visiva dei personaggi, nella conservazione dei volti, degli abiti, dei colori dei marchi e dei caratteri tipografici presenti sulle confezioni dei prodotti. Le modifiche comprendono anche una maggiore continuità dei movimenti di camera, una riduzione delle trasformazioni indesiderate fra fotogrammi, una sincronizzazione labiale più precisa e una resa più naturale del dialogo, con una migliore separazione delle condizioni vocali nei contenuti con più interlocutori. Nelle valutazioni comparative diffuse da Google DeepMind, Omni 1.2 ha ottenuto una preferenza del 62% per la coerenza visiva rispetto al 38% della versione 1.1 nei test text-to-video. Nelle prove basate su più immagini di riferimento, la nuova versione ha raggiunto il 63% di preferenze per la conservazione dell’identità visiva, contro il 37% della precedente. Si tratta di risultati comparativi riferiti alle procedure di valutazione adottate da Google e non di una garanzia di stabilità in ogni situazione. Rimangono infatti difficoltà nella rappresentazione di azioni sportive molto rapide, nella gestione di cambiamenti improvvisi e nella simulazione di fenomeni fisici complessi.
La versione attuale delle API supporta pienamente l’inglese, mentre le altre lingue non risultano ancora sottoposte a valutazione completa. Non sono inoltre supportati, nelle API standard, la modifica diretta delle voci, il caricamento di file audio come input e l’impiego ordinario di riferimenti audio. I tempi di generazione possono variare in funzione della durata richiesta, della risoluzione e del carico delle infrastrutture. Il sistema applica inoltre filtri di sicurezza alle istruzioni e ai contenuti generati. Ogni video prodotto attraverso le API incorpora un watermark invisibile SynthID, che può essere rilevato mediante strumenti software dedicati alla verifica della provenienza dei contenuti. L’accesso alla nuova versione è previsto attraverso Google AI Studio per la prototipazione e la Gemini API a pagamento per l’impiego applicativo. La distribuzione comprende anche Flow, con strumenti di direzione delle scene e modifica iterativa, Google Vids, che introduce sequenze più lunghe senza costi aggiuntivi per gli utenti con account Google o abbonamento Workspace, l’app Gemini per gli abbonati Google AI Ultra e gli strumenti di creazione delle campagne Google Ads.
Google Cloud rende disponibile Gemini Omni 1.2 Flash anche attraverso console e API aziendali, con infrastrutture e controlli di sicurezza dedicati, accordi sul livello di servizio e Provisioned Throughput per la gestione della capacità riservata. L’utilizzo dei riferimenti audio in specifiche configurazioni cloud rimane subordinato all’inserimento in apposite liste di autorizzazione. Fra le applicazioni commerciali già indicate figura Photoroom, che utilizza il modello nei prodotti Video Ad Maker e Product Animator. L’amministratore delegato Matt Rouif ha individuato nell’estensione della durata dei video una delle richieste più frequenti degli utenti e ha collegato la disponibilità generale, accompagnata da garanzie di servizio, alla possibilità di utilizzare il sistema stabilmente nei processi produttivi rivolti ai venditori e alle organizzazioni aziendali. L’aggiornamento introduce quindi modifiche concrete sia nei limiti tecnici di generazione sia nel processo di revisione dei video, consentendo di intervenire su contenuti esistenti e di riservare le elaborazioni ad alta risoluzione alle versioni effettivamente destinate alla pubblicazione.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)