
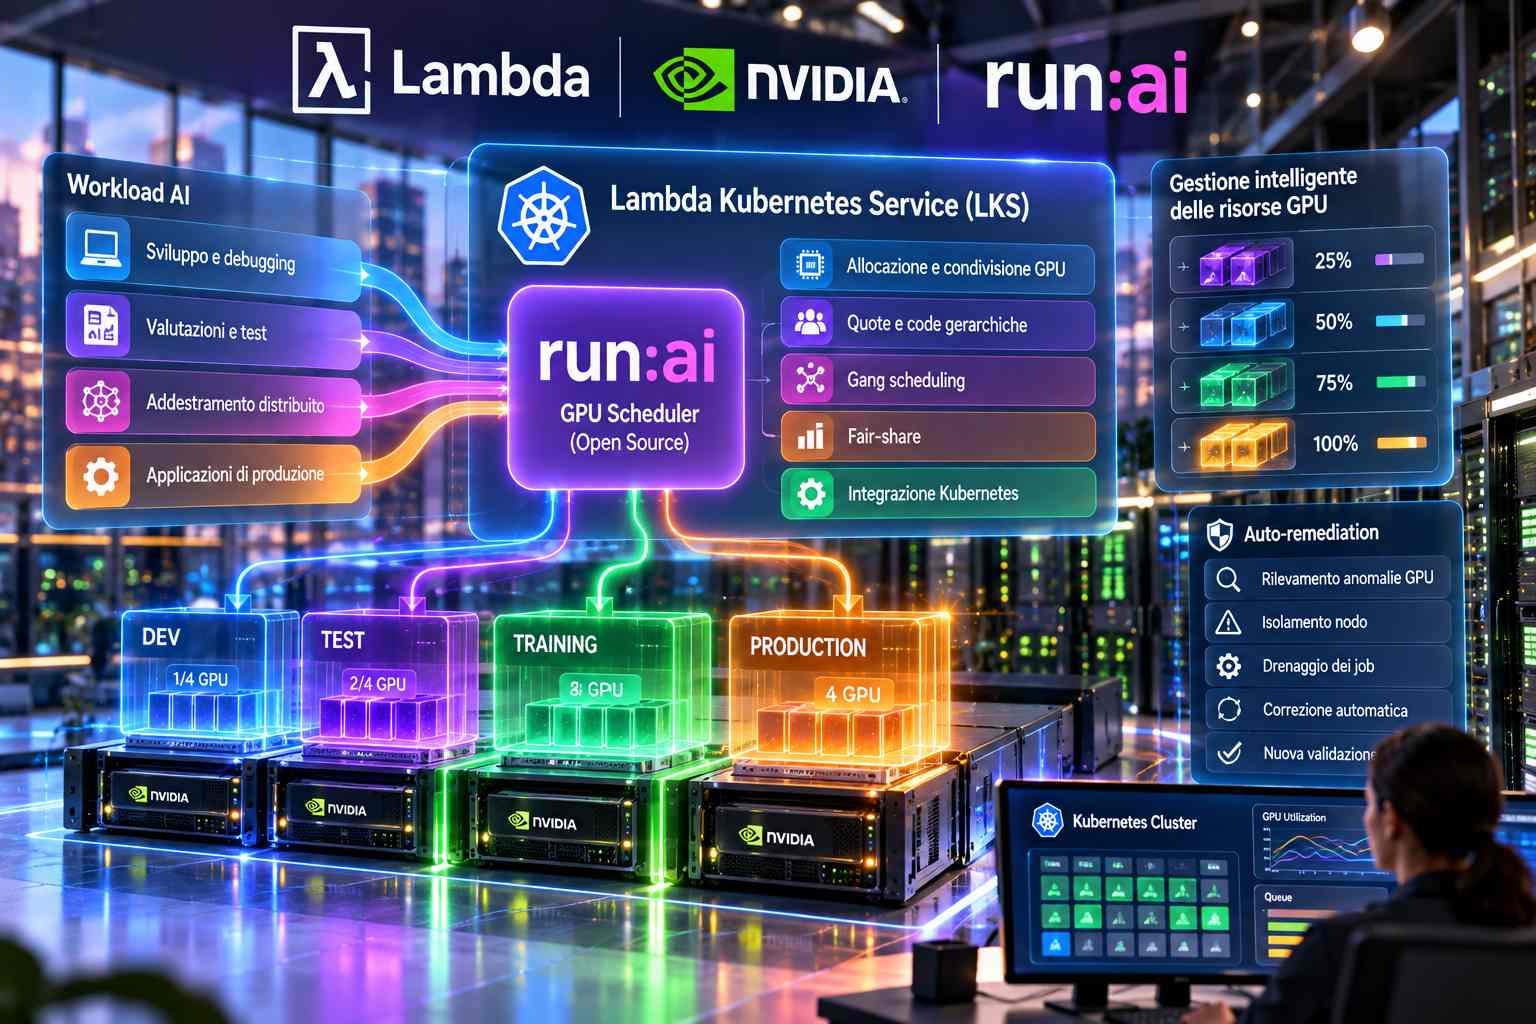
Lambda ha annunciato una collaborazione con NVIDIA per integrare lo scheduler GPU open source Run:ai come componente gestito di Lambda Kubernetes Service (LKS), la propria piattaforma Kubernetes dedicata ai carichi di lavoro di intelligenza artificiale. L’iniziativa prevede di rendere Run:ai un’opzione direttamente disponibile e amministrata all’interno del servizio, senza richiedere ai clienti di occuparsi autonomamente dell’installazione, dell’integrazione e della manutenzione dello scheduler. Lambda supporta Run:ai sulla propria infrastruttura dal 2022 e intende sfruttare il rilascio open source del software per offrire funzionalità più avanzate di allocazione, condivisione e gestione delle risorse GPU. Il progetto rientra nella realizzazione di una libreria di scheduler gestiti, comprendente anche soluzioni basate su Kubernetes e Slurm, che saranno distribuiti come componenti verificati rispetto alle configurazioni hardware della piattaforma.
La tecnologia coinvolta deriva da KAI Scheduler, lo scheduler nativo Kubernetes originariamente sviluppato all’interno della piattaforma Run:ai e pubblicato da NVIDIA il 1° aprile 2025 con licenza Apache 2.0. Il sistema introduce funzionalità che superano la normale assegnazione delle GPU ai pod Kubernetes, attraverso la condivisione degli acceleratori, l’applicazione di quote per gruppi di lavoro, la pianificazione gerarchica delle code e il gang scheduling per l’esecuzione coordinata di processi distribuiti. In questo modo, applicazioni con necessità differenti possono condividere l’infrastruttura senza riservare permanentemente GPU intere a operazioni che utilizzano soltanto una parte della capacità disponibile. Le attività di debugging possono richiedere una frazione di GPU, le valutazioni possono distribuire numerosi job indipendenti, mentre l’addestramento distribuito necessita dell’assegnazione contemporanea di più acceleratori. Lo scheduler calcola continuamente la ripartizione equa delle risorse attraverso meccanismi di fair-share, adeguando quote e disponibilità rispetto ai carichi effettivi e alle priorità stabilite.
Uno degli elementi tecnici principali riguarda il frazionamento delle GPU, che consente di assegnare a workload differenti porzioni della memoria di uno stesso acceleratore, mantenendo separati gli spazi di indirizzamento virtuale e applicando limiti alla memoria utilizzabile. La condivisione della capacità di calcolo avviene normalmente mediante time-slicing NVIDIA. Il sistema supporta anche frazioni distribuite su più GPU appartenenti allo stesso nodo: un modello che richiede otto GPU con 40 GB di memoria su ciascuna può ricevere otto allocazioni da 40 GB, lasciando eventualmente disponibile la memoria residua per altre applicazioni. Il frazionamento non può tuttavia essere utilizzato sullo stesso nodo contemporaneamente alla modalità Multi-Instance GPU (MIG). Sul piano della pianificazione, il gang scheduling garantisce che i pod appartenenti a un singolo workload distribuito vengano programmati tutti insieme oppure rimangano in attesa, evitando allocazioni parziali incapaci di avviare correttamente l’elaborazione. Il sistema crea code associate a progetti e dipartimenti all’interno dei diversi pool di nodi, distingue le risorse garantite da quelle temporaneamente disponibili e permette di recuperare capacità mediante preemption dei workload che superano la propria quota.
Il ciclo operativo dello scheduler parte da una rappresentazione dello stato corrente del cluster Kubernetes, calcola la quota spettante a ciascuna coda e applica operazioni di allocazione, consolidamento, recupero e preemption. Le quote garantite delimitano l’esecuzione dei workload non interrompibili, mentre le risorse utilizzate oltre quota possono essere assegnate a processi interrompibili e successivamente recuperate quando altri gruppi ne hanno diritto. Gli amministratori possono inoltre stabilire strategie di collocazione bin-pack, per concentrare i workload sulle risorse disponibili, oppure spread, per distribuirli fra più nodi. Un componente denominato podgrouper collega automaticamente i workload provenienti da framework come Kubeflow, Ray, Argo e Training Operator ai relativi gruppi di pianificazione.
Lambda affianca a questa gestione delle risorse un sistema di auto-remediation già operativo su LKS, progettato per individuare e isolare automaticamente i nodi che presentano anomalie hardware. La piattaforma sorveglia errori XID delle GPU, problemi di comunicazione NVLink e PCIe, rimappature delle celle di memoria e degradazioni delle porte InfiniBand, registrando le anomalie come condizioni standard dei nodi Kubernetes. Quando viene rilevato un problema, il nodo viene escluso dall’assegnazione di nuovi job, i processi in esecuzione vengono trasferiti o terminati secondo le procedure di drenaggio e il sistema tenta la correzione automatica oppure richiede un intervento hardware. Il nodo torna disponibile soltanto dopo una nuova validazione. LKS comprende inoltre NVIDIA GPU Operator e NVIDIA Network Operator preinstallati, supporto alla rete InfiniBand con RDMA, archiviazione persistente condivisa e controlli continuativi sul funzionamento di GPU, rete e storage.
L’integrazione gestita di Run:ai è ancora nella fase di preparazione e non viene indicata una data di disponibilità definitiva. L’obiettivo dichiarato da Lambda è distribuire scheduler già configurati, collaudati e mantenuti aggiornati, trasferendo al fornitore la responsabilità del packaging software, della validazione sull’hardware e delle attività operative successive al rilascio. La disponibilità del codice sorgente consente inoltre alla società di esaminare, adattare e migliorare direttamente i componenti di orchestrazione impiegati nei propri servizi.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)