
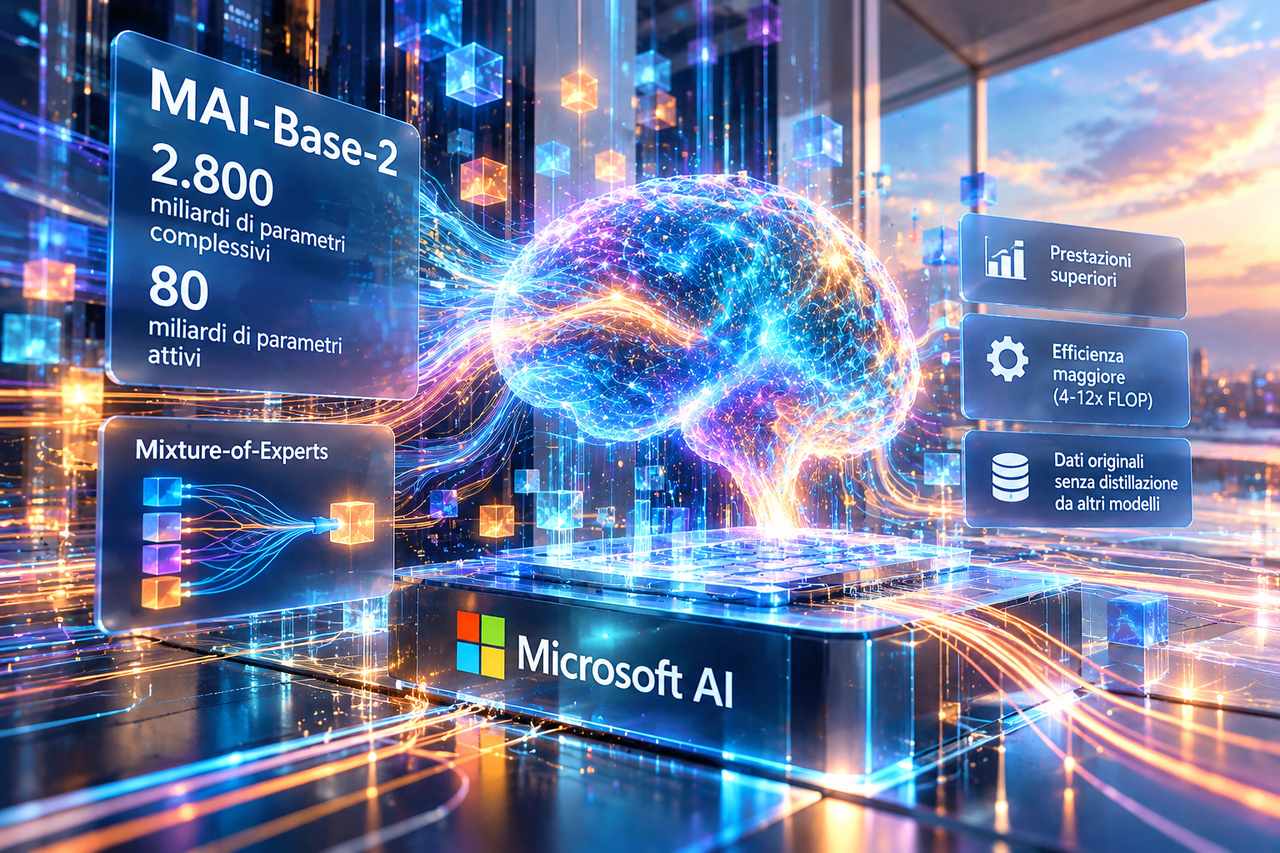
Microsoft AI ha dichiarato il completamento del preaddestramento di MAI-Base-2, un nuovo foundation model proprietario basato su un’architettura Mixture-of-Experts, con 2.800 miliardi di parametri complessivi e 80 miliardi di parametri attivati durante l’elaborazione. Il modello rappresenta un avanzamento della famiglia MAI e costituisce la base per una nuova generazione di sistemi linguistici sviluppati internamente dall’azienda. Microsoft aveva presentato nel giugno 2026 MAI-Thinking-1, un modello general-purpose specializzato nel ragionamento e ottenuto attraverso il post-training della precedente architettura MAI-Base-1. Con MAI-Base-2, l’azienda ha completato una nuova fase di preaddestramento su larga scala, dichiarando risultati superiori a quelli dei modelli open-weight utilizzati nelle proprie valutazioni interne e un’efficienza computazionale significativamente maggiore rispetto alle architetture di riferimento considerate.
La struttura Mixture-of-Experts permette di distribuire i parametri del modello tra componenti specializzate, attivandone soltanto una parte per ciascuna elaborazione. Nel caso di MAI-Base-2, gli 80 miliardi di parametri attivi rappresentano circa il 2,9% dei 2.800 miliardi complessivi, consentendo di utilizzare una capacità parametrica molto estesa senza richiamare simultaneamente tutti i pesi durante ogni operazione. Il vantaggio teorico consiste nella possibilità di combinare dimensioni complessive elevate e costo computazionale per token relativamente contenuto, attraverso meccanismi di instradamento che selezionano gli esperti pertinenti. L’efficienza effettiva dipende comunque dall’architettura di routing, dalla distribuzione dei pesi, dai sistemi di comunicazione tra acceleratori e dall’infrastruttura impiegata durante addestramento e inferenza. Microsoft non ha ancora reso disponibile un rapporto pubblico contenente tutti i dettagli implementativi della nuova architettura.
Le valutazioni interne presentate dall’azienda indicano che MAI-Base-2 supera i modelli open-weight inclusi nel confronto sui benchmark di preaddestramento riservati, utilizzati per misurare la capacità dei modelli di apprendere e rappresentare informazioni prima delle successive fasi di ottimizzazione. Microsoft attribuisce inoltre alla nuova architettura un’efficienza in termini di FLOP di preaddestramento da quattro a dodici volte superiore rispetto a DeepSeek-V4-Pro-Base, indicato come il modello base open-weight più competitivo tra quelli selezionati. Il dato riguarda il rapporto tra risorse computazionali e prestazioni raggiunte nelle specifiche valutazioni dell’azienda e non corrisponde automaticamente a un’accelerazione dell’inferenza o a una riduzione equivalente del costo di utilizzo commerciale. Microsoft ha destinato il vantaggio ottenuto alla possibilità di addestrare un modello di dimensioni maggiori, mantenendo una strategia orientata all’efficienza dei sistemi di apprendimento.
Una componente specifica del progetto riguarda la provenienza dei dati di addestramento. Microsoft dichiara di aver costruito il processo di pretraining attraverso dati originali, senza ricorrere alla distillazione delle risposte di altri modelli per la formazione del corpus. L’azienda considera il controllo della provenienza dei token una caratteristica importante per la futura distribuzione dei pesi ai clienti istituzionali, perché permette di documentare con maggiore precisione le origini delle informazioni utilizzate nella costruzione del modello. Questo approccio rientra nel programma di sviluppo di una pipeline proprietaria completa, dalla selezione dei dati al preaddestramento, dal post-training alla distribuzione attraverso infrastrutture Microsoft. La disponibilità dei pesi è prevista per partner selezionati attraverso Microsoft Foundry, secondo condizioni di accesso e autorizzazione ancora da dettagliare.
MAI-Base-2 si trova attualmente nella fase di post-training, necessaria per adattare il foundation model alle attività di generazione, ragionamento e interazione richieste dai prodotti finali. Non è stata comunicata una data definitiva per il rilascio pubblico del modello addestrato, né sono stati pubblicati risultati completi relativi alle prestazioni conversazionali dopo l’ottimizzazione. Il progetto si inserisce nello sviluppo della capacità Microsoft di progettare e gestire internamente modelli di frontiera, mantenendo contemporaneamente la possibilità di distribuire modelli di fornitori esterni attraverso Azure e Foundry. L’azienda intende utilizzare il controllo congiunto di architettura, addestramento e infrastruttura per ottimizzare prestazioni e costi, inizialmente nei propri prodotti e successivamente nei servizi destinati ai clienti. Le cifre presentate riguardano pertanto un modello base il cui preaddestramento è stato completato, mentre le capacità applicative definitive dipenderanno dalle successive procedure di post-training e validazione.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)