
Mistral Large 4 Preview ha ottenuto 38 punti nell’Artificial Analysis Intelligence Index 4.3.2, risultato che lo colloca, secondo la società di benchmarking, come il modello con il livello di intelligenza generale più elevato sviluppato al di fuori di Stati Uniti e Cina. Il punteggio è identico a quello attribuito a GPT-6 Luna nella configurazione max e appena inferiore ai 39 punti di DeepSeek V4.1 Flash max. Artificial Analysis interpreta quindi il risultato come un ritorno della Francia al vertice dei modelli sviluppati al di fuori delle due principali aree oggi dominanti nella ricerca frontier, davanti fra gli altri ai sistemi provenienti dalla Corea del Sud e dagli Emirati Arabi Uniti. Nella classifica complessiva il modello occupa il 64° posto su 225 sistemi considerati nella stessa classe, mentre la mediana della categoria è pari a 26 punti. Mistral Large 4 Preview viene classificato come reasoning model, accetta testo e immagini come input, produce testo come output ed è attualmente servito attraverso due provider API.
L’Intelligence Index 4.3.2 non deriva da un singolo benchmark, ma combina dieci diverse valutazioni: AA-Briefcase v1.1, GDPval-AA v2.1, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity’s Last Exam, GDP.pdf, CritPt, AA-Omniscience e AA-LCR v1.1. Artificial Analysis aggrega i risultati attraverso quattro macroaree con pesi differenti: il 30% del punteggio proviene dalle capacità agentiche, il 20% dal coding, il 20% dal reasoning scientifico e il restante 30% da capacità generali. La società stima per il risultato aggregato un intervallo di confidenza al 95% inferiore a ±1%. Il benchmark rimane prevalentemente testuale e in lingua inglese, mentre prestazioni sulle immagini, capacità vocali e comportamento multilingue vengono valutati separatamente e non confluiscono direttamente nel numero 38 attribuito al modello.
Oltre all’indice generale, Mistral Large 4 Preview ha ottenuto 50 punti nell’Artificial Analysis Cyber Index. Il valore è identico a quello di GLM-5.3-Flash, inferiore ai 56 punti di MiMo-V2.6-Pro ma superiore a diversi modelli, fra cui Kimi K3 e DeepSeek V4.1 Flash max. Il dato più elevato della suite cyber emerge da CyberGym-E2E-AA, dove Large 4 Preview raggiunge l’82%, superando il 79% di MiMo-V2.6-Pro e il 78% di GPT-6 Luna max. Artificial Analysis sostiene che, una volta pubblicati i pesi del modello, Large 4 dovrebbe collocarsi fra i primi tre sistemi open-weight presenti nella propria graduatoria dedicata alla cybersecurity. Al momento, tuttavia, il modello non può ancora essere classificato come open-weight perché i pesi non sono stati distribuiti.
Il risultato deve essere letto insieme a un profilo di costo sensibilmente diverso da quello di altri modelli open-weight o destinati a diventarlo con punteggi comparabili. Artificial Analysis stima che l’esecuzione dell’Intelligence Index su Mistral Large 4 Preview costi circa 1,13 dollari per task utilizzando il prezzo standard dell’API, pari a 1,36 dollari per milione di token in input e 4,18 dollari per milione di token in output, mentre l’input recuperato dalla cache costa 0,14 dollari per milione di token. Per le prime due settimane dopo il lancio Mistral applica uno sconto del 50%, riducendo il costo dell’input a 0,68 dollari per milione di token e quello dell’output a 2,09 dollari, con un costo stimato del benchmark di circa 0,57 dollari per task. Anche con la promozione, il valore rimane superiore ai circa 0,25 dollari di GLM-5.3-Flash e ai 0,27 dollari di DeepSeek V4.1 Flash max. A listino pieno Artificial Analysis considera quindi Large 4 Preview oltre quattro volte più costoso per task rispetto a modelli open-weight con livello di intelligenza comparabile.
Il comportamento durante il benchmark mostra inoltre un utilizzo particolarmente elevato di token. Nell’intera esecuzione dell’Intelligence Index il modello ha prodotto complessivamente circa 200 milioni di token di output, contro una mediana della classe di 81 milioni. Tramite l’API di Mistral, Artificial Analysis ha misurato una velocità di generazione di 116,1 token al secondo, superiore alla mediana di 86,1 token al secondo, e un time-to-first-token di 1,46 secondi rispetto ai 3,81 secondi mediani della categoria. Large 4 combina quindi un costo e un consumo totale superiori alla media con una velocità di output relativamente elevata e una latenza iniziale inferiore a quella registrata mediamente sugli altri sistemi esaminati.
Un’altra area valutata in modo specifico è il reasoning su documenti professionali attraverso GDP.pdf. Mistral Large 4 Preview raggiunge il 19%, lo stesso risultato di MiMo-V2.6-Pro e tre punti percentuali sotto Kimi K3, che arriva al 22%. Il dato rappresenta tuttavia un miglioramento di 18 punti rispetto a Mistral Large 3. Artificial Analysis collega una parte di questo progresso anche a un cambiamento dell’API: Large 4 può ricevere fino a 100 immagini all’interno della stessa richiesta, mentre i precedenti modelli Mistral erano limitati a otto, caratteristica particolarmente significativa nei benchmark documentali nei quali un singolo documento può essere rappresentato attraverso numerose pagine trasformate in immagini.
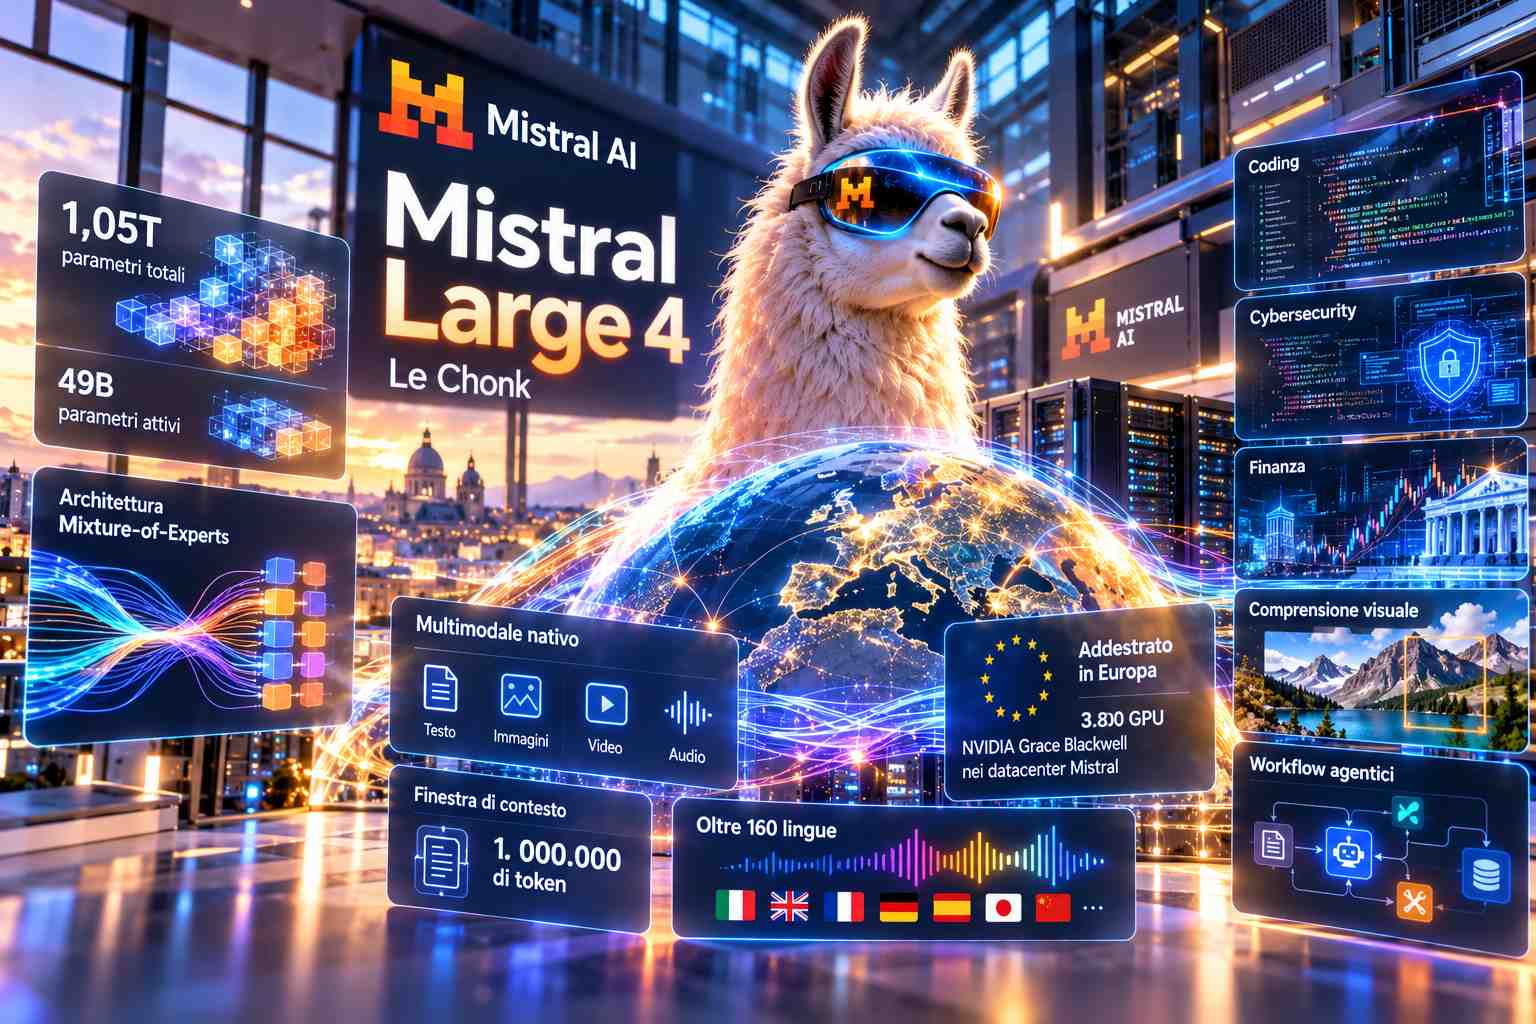
Dal punto di vista architetturale, Mistral Large 4 dispone di una finestra di contesto da 512.000 token e conta complessivamente un trilione di parametri, dei quali 49 miliardi vengono attivati durante l’inferenza. La versione disponibile dal 6 ottobre è ancora una Research Public Preview tramite l’API Mistral. La società ha annunciato che i pesi verranno pubblicati entro la fine di ottobre 2026; fino a quel momento Artificial Analysis lo classifica tecnicamente come modello proprietario. Il modello è noto anche con il soprannome Le Chonk ed è stato addestrato da zero come sistema nativamente multimodale utilizzando 3.800 GPU NVIDIA Grace Blackwell installate nei datacenter europei di Mistral.
Il dataset di training comprende contenuti in oltre 160 lingue e include tutte le lingue ufficiali dell’Unione Europea, coerentemente con il posizionamento di Mistral come sviluppatore europeo di modelli generalisti su larga scala. La società sostiene che Large 4 superi nettamente qualsiasi modello open-weight sviluppato negli Stati Uniti o in Europa e ha scelto di distribuire inizialmente il sistema come preview API prima di rendere disponibili i pesi. Il modello pubblicato il 6 ottobre non rappresenta inoltre necessariamente la configurazione finale: Mistral ha specificato che il processo di reinforcement learning associato alla preview era ancora in corso al momento del lancio, lasciando quindi aperta la possibilità che la release open-weight di fine mese presenti prestazioni differenti da quelle misurate sulla prima versione pubblica.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)