
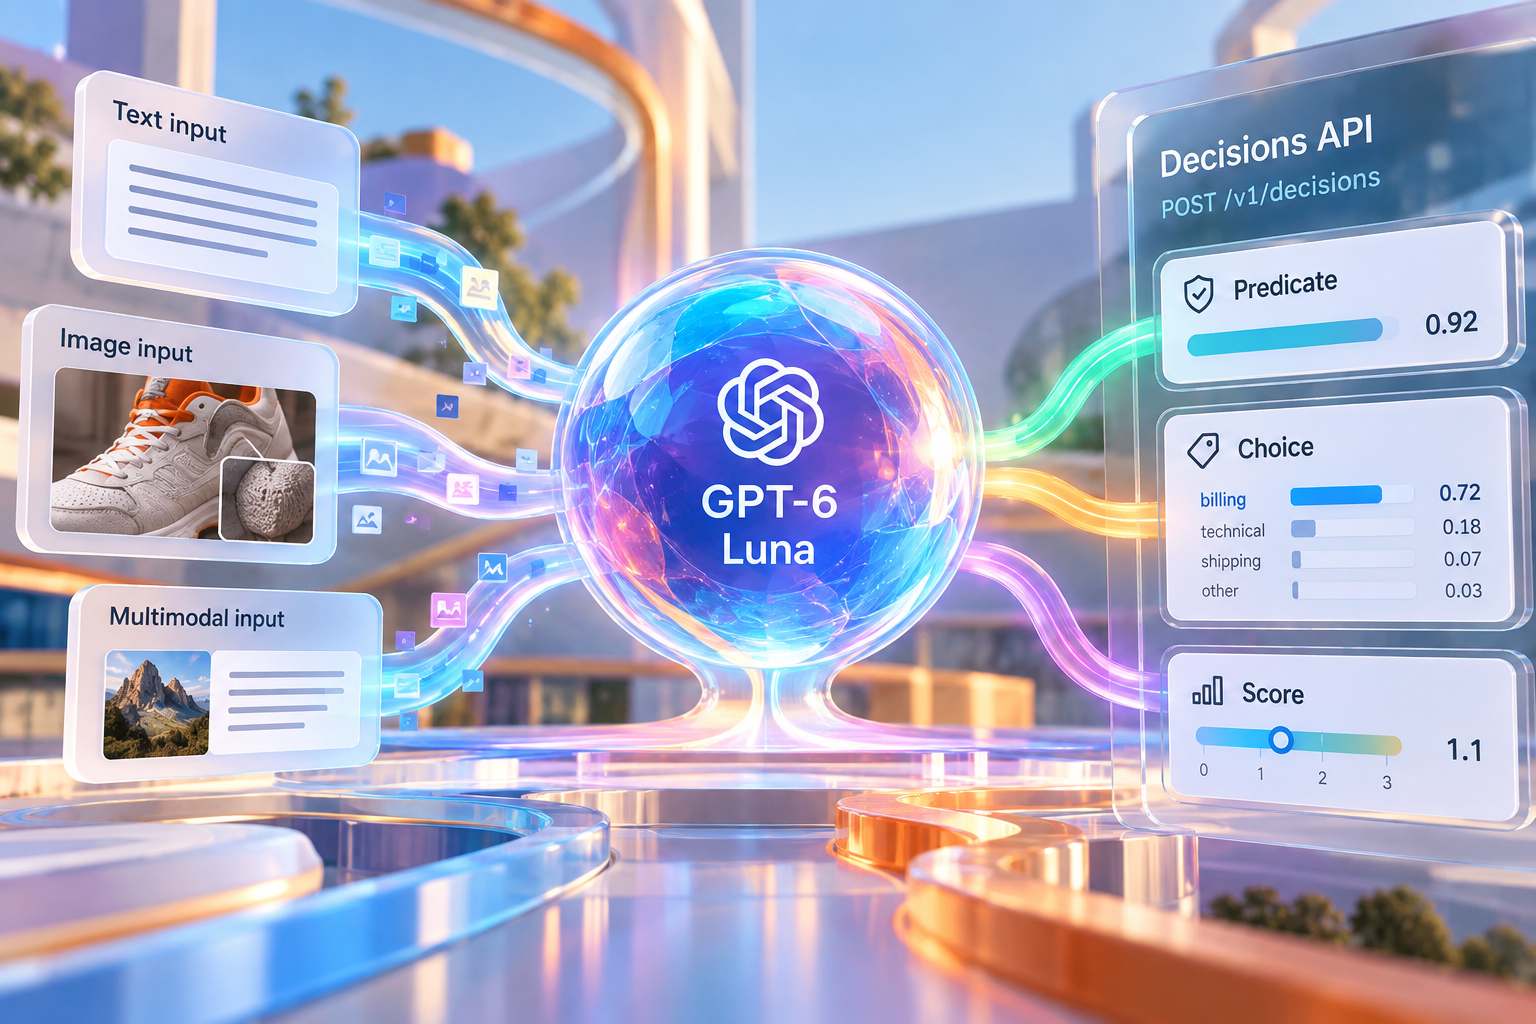
OpenAI ha reso disponibile in public beta la Decisions API, una nuova interfaccia progettata specificamente per utilizzare il reasoning di GPT-6 Luna in compiti nei quali un’applicazione non richiede una risposta testuale libera, ma deve ottenere una decisione strutturata e tipizzata a partire da testo, immagini o dalla combinazione dei due. L’API utilizza un endpoint dedicato, POST /v1/decisions, e OpenAI afferma che per questo genere di valutazioni è in grado di restituire risultati circa dieci volte più velocemente rispetto alla Responses API. Prima di integrarla nel proprio codice gli sviluppatori possono provarla direttamente nel Playground, definendo gli input e le domande che il modello deve valutare. La public beta segue la presentazione iniziale avvenuta durante DevDay 2026, quando la Decisions API era disponibile soltanto come limited preview. In quella occasione OpenAI l’aveva descritta come un modo per applicare il reasoning di Luna a un insieme di domande definite dall’utente, ciascuna associata a un numero finito di possibili risposte, così da trasformare il risultato del modello in un elemento immediatamente utilizzabile nella logica di un’applicazione. L’endpoint utilizza attualmente soltanto GPT-6 Luna. Il modello era stato presentato il 22 settembre 2026 insieme a GPT-6 Sol e, come Sol, accetta testo e immagini come input e può essere utilizzato nelle Responses API e Chat Completions. Nel caso della Decisions API, tuttavia, il compito non consiste nel produrre una normale risposta generativa: Luna valuta le evidenze ricevute rispetto a una serie di criteri prestabiliti e restituisce probabilità, categorie oppure punteggi. Gli scenari indicati comprendono classificazione dei contenuti, instradamento di richieste, analisi di immagini e scelta della successiva azione all’interno di un agente, ma la struttura dell’endpoint consente più in generale di inserire reasoning probabilistico in processi applicativi che richiedono un risultato interpretabile dal software senza dover successivamente analizzare testo generato liberamente.
Una richiesta alla Decisions API è costruita intorno a tre componenti. Il campo model identifica il modello incaricato della valutazione, che nella beta può essere soltanto gpt-6-luna; input contiene le evidenze comuni alle diverse domande e può assumere la forma di una stringa testuale oppure di uno o più messaggi utente contenenti testo e immagini; questions definisce infine le singole valutazioni da eseguire, specificando per ciascuna un nome univoco, un tipo, le istruzioni da seguire e, quando necessario, le opzioni oppure i livelli tra i quali scegliere. La risposta restituisce un array answers e associa ogni risposta al nome della domanda corrispondente, consentendo quindi di inviare più valutazioni nella stessa chiamata e ricostruirne senza ambiguità i risultati. La prima tipologia disponibile è predicate, destinata a verificare se una determinata condizione sia vera. In questo caso il risultato non è un semplice sì o no, ma una probabilità compresa fra 0 e 1. Nella documentazione viene mostrato l’esempio di una fotografia di un prodotto che deve essere analizzata per verificare la presenza di una crepa, uno strappo o un’ammaccatura: una risposta illustrativa attribuisce alla condizione una probabilità di 0,92. Spetta poi all’applicazione decidere quale soglia utilizzare per considerare il danno sufficientemente probabile e, per esempio, inviare la fotografia a una revisione umana. La stessa struttura può essere utilizzata per stabilire se un passaggio di testo sia rilevante, se un documento soddisfi un criterio o se un contenuto presenti una determinata caratteristica osservabile. La seconda tipologia, choice, forza il modello a scegliere un’opzione all’interno di un insieme definito dallo sviluppatore. Ogni scelta può essere accompagnata da una descrizione che spiega quando debba essere utilizzata e la risposta non contiene soltanto il valore selezionato, ma anche un array con la distribuzione delle probabilità fra tutte le alternative e un campo confidence separato. Nell’esempio della documentazione, un cliente segnala un doppio addebito e la richiesta viene classificata come problema di billing anziché technical, shipping o altre categorie. OpenAI raccomanda di aggiungere un’opzione di fallback come “other” per gestire i casi che non rientrano chiaramente nelle categorie previste; l’applicazione può quindi inoltrare tali casi a una coda generica oppure sottoporli a revisione manuale invece di costringere il modello a scegliere una classificazione non appropriata. La terza modalità, score, serve invece a valutare l’input rispetto a una scala ordinata, per esempio il livello di gravità di un problema. I livelli vengono disposti dal più basso al più alto e numerati a partire da zero, mentre il punteggio finale viene calcolato come media degli indici ponderata dalle probabilità associate a ciascun livello. Il risultato può quindi assumere valori intermedi anziché coincidere necessariamente con uno dei livelli discreti definiti dallo sviluppatore. Nell’esempio fornito da OpenAI, probabilità pari a 0,1, 0,7 e 0,2 attribuite a tre livelli di severità producono un punteggio di 1,1 e una confidence pari a 0,55. In questo modo il software può conservare l’incertezza del modello e stabilire autonomamente soglie, priorità o azioni successive sulla base del valore numerico ottenuto.
Predicate, choice e score non sostituiscono gli altri meccanismi di output strutturato delle API OpenAI. Quando un’applicazione necessita di oggetti più complessi che rispettino uno schema JSON personalizzato, la documentazione continua a indicare Structured Outputs tramite Responses API; quando invece il modello deve richiedere l’esecuzione di uno strumento passando argomenti strutturati, il meccanismo appropriato rimane function calling. Decisions API viene quindi posizionata per il caso più specifico nel quale il problema consiste nel valutare evidenze rispetto a un insieme noto di criteri e restituire probabilità, categorie o punteggi già pronti per essere consumati dal software. Più domande indipendenti possono essere inserite nello stesso array questions e possono anche appartenere a tipi differenti. Una singola chiamata può quindi analizzare una fotografia per determinare se un prodotto sia danneggiato mediante una predicate e contemporaneamente classificare la categoria del prodotto tramite una choice. Se però la seconda decisione dipende logicamente dalla prima, le richieste devono essere separate: un’applicazione può prima stabilire se sia presente un danno e soltanto se la probabilità supera una determinata soglia inviare una seconda chiamata per classificarne il tipo o selezionare la procedura di riparazione. OpenAI suggerisce inoltre di scrivere le domande concentrandosi su criteri osservabili, separare problemi concettualmente distinti, assegnare significati nettamente differenti alle diverse choice e definire i livelli degli score in modo che due livelli adiacenti siano distinguibili senza ambiguità.
Particolare attenzione viene dedicata alla calibrazione. Le probabilità restituite dal modello non dovrebbero essere trasformate automaticamente in decisioni operative utilizzando soglie arbitrarie: OpenAI raccomanda di calibrarle su esempi etichettati provenienti dall’applicazione reale, valutando in particolare il costo relativo dei falsi positivi e dei falsi negativi. Un sistema di verifica del danno di un prodotto, per esempio, può preferire una soglia più bassa quando il rischio di ignorare un danno è superiore al costo di inviare qualche immagine in più alla revisione umana; un filtro che blocchi automaticamente contenuti o operazioni potrebbe invece richiedere una soglia più elevata. Gli input visivi hanno limitazioni specifiche. Le immagini devono essere inviate inline sotto forma di data URL codificati in base64: la beta non accetta immagini ospitate su URL HTTP o HTTPS esterni e non supporta riferimenti file_id. Per analizzare contemporaneamente un’immagine e informazioni testuali è possibile inserire componenti input_text e input_image nella stessa user message. Questa struttura consente per esempio di accompagnare una fotografia con indicazioni contestuali o con una descrizione del criterio che deve essere utilizzato nella valutazione.
Anche il modello tariffario è differente rispetto a una normale richiesta generativa. Una chiamata a gpt-6-luna attraverso /v1/decisions costa 0,10 dollari per milione di token in input e vengono fatturati soltanto i token di input: cache read, cache write e token di output non comportano costi aggiuntivi. Restano però applicabili gli eventuali sovrapprezzi relativi al processing regionale e i moltiplicatori previsti per input con contesti molto lunghi. Le richieste a GPT-6 Luna effettuate al di fuori dell’endpoint Decisions continuano invece a seguire il normale pricing del modello e del processing tier utilizzato. Dal punto di vista dei controlli sui dati, la Decisions API supporta Zero Data Retention e utilizzi HIPAA per i clienti che soddisfano i relativi requisiti. Sono disponibili data residency e regional processing sia negli Stati Uniti sia in Europa, dove vengono comprese l’Area Economica Europea e la Svizzera. L’endpoint può inoltre inserirsi in applicazioni vocali tramite client delegation con la Live API: un agente può ricevere una richiesta vocale, utilizzare una decisione strutturata per determinare quale azione eseguire e comunicare successivamente il risultato all’utente. OpenAI prevede di portare la Decisions API dalla public beta alla disponibilità generale nelle settimane successive al lancio.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)