
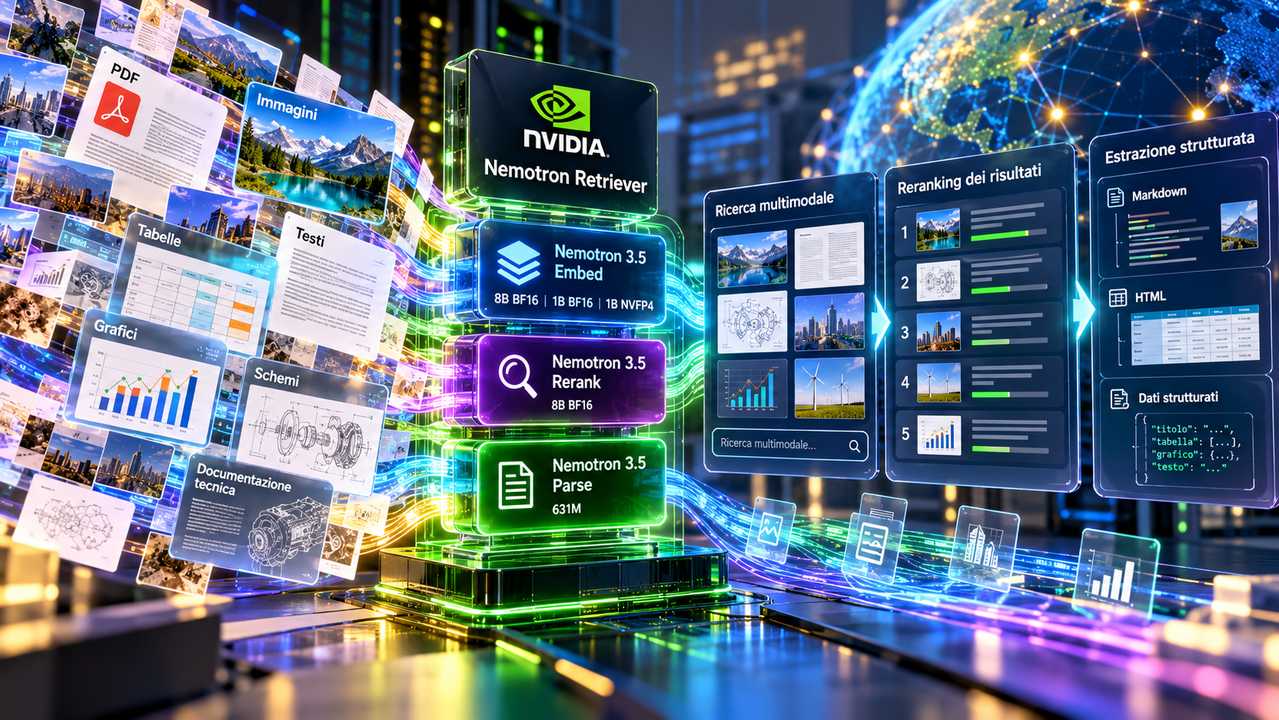
NVIDIA ha ampliato la famiglia Nemotron Retriever introducendo modelli aperti destinati alla ricerca multimodale, alla valutazione della rilevanza dei risultati e all’estrazione strutturata delle informazioni dai documenti. Il rilascio comprende Nemotron 3.5 Embed nelle versioni 8B BF16, 1B BF16 e 1B NVFP4, Nemotron 3.5 Rerank 8B BF16 e Nemotron 3.5 Parse, un modello da 631 milioni di parametri. Le nuove componenti sono destinate alle applicazioni aziendali basate su retrieval-augmented generation e agenti AI che devono individuare informazioni distribuite in testi, tabelle, grafici, immagini, schemi e documentazione tecnica. Nemotron 3.5 Embed 8B privilegia la qualità del recupero multimodale, mentre le versioni da un miliardo di parametri sono progettate per ridurre l’impronta computazionale e aumentare la capacità di indicizzazione e ricerca. La versione NVFP4 applica la quantizzazione agli encoder testuale e visivo. Nemotron 3.5 Rerank utilizza invece un’architettura cross-encoder che elabora congiuntamente la richiesta e ciascun documento candidato, assegnando un punteggio di rilevanza attraverso una testa di classificazione. I modelli sono stati valutati su ricerca testuale in 34 lingue e su dataset multimodali comprendenti MIRACL Vision e KoViDoRe.
Nei test su ViDoRe v3, BRIGHT e BrowseComp-Plus, NVIDIA ha analizzato l’effetto delle diverse configurazioni di retrieval sul comportamento degli agenti, mantenendo invariati modello linguistico, strumenti, attività, corpus e regole di esecuzione. L’integrazione di Nemotron 3.5 Rerank ha ridotto, secondo i risultati comunicati, il costo dei token di inferenza per interrogazione di circa il 14% con Embed 8B e del 13% con Embed 1B, migliorando contemporaneamente la precisione delle informazioni recuperate. Nel benchmark ViDoRe v3.1, Nemotron 3.5 Embed 8B BF16 ha raggiunto 61,17 nDCG@10, contro 52,23 del precedente Llama Nemotron Embed VL 1B, mentre la versione distillata 1B BF16 ha ottenuto 58,38, conservando il 95,4% del risultato del modello più grande. Su MIRACL Vision, la versione 8B ha raggiunto 72,6 nDCG@10, superando di 4,3 punti Qwen3-VL-Embedding-8B. Nemotron 3.5 Rerank ha registrato 60,49 nDCG@10 sui contenuti misti del benchmark di reranking ViDoRe v3.1, rispetto a 59,17 di Qwen3-VL-Reranker-8B. I risultati si riferiscono alle condizioni e alle configurazioni di benchmark dichiarate da NVIDIA.
Per l’esecuzione in produzione, NVIDIA indica che Nemotron Embed 1B NVFP4 raggiunge 128,8 documenti al secondo su GB200, contro 101,3 della versione BF16, con il 99,85% della precisione di retrieval della configurazione BF16. In un’altra prova su RTX PRO 6000 Blackwell Server Edition, NVIDIA NIM ha gestito 6.031 richieste al secondo rispetto alle 2.099 di una configurazione vLLM confrontabile. NVIDIA ha pubblicato anche un procedimento di fine-tuning multimodale basato sulla generazione sintetica delle interrogazioni, selezione di esempi negativi difficili e addestramento mediante NeMo AutoModel. In una sperimentazione su grafici e infografiche, il modello Embed 1B ha incrementato il punteggio nDCG@10 da 37,34 a 44,12 dopo un’epoca di addestramento. Nemotron 3.5 Parse completa la famiglia riconoscendo elementi, posizione e ordine di lettura dei documenti e restituendo testo, tabelle e grafici come Markdown, tabelle HTML o blocchi strutturati. NVIDIA riporta per Parse un punteggio di 75,20 su ParseBench e una velocità di 10,5 pagine al secondo su una GPU H100. L’insieme dei modelli permette di costruire pipeline nelle quali estrazione documentale, indicizzazione, recupero e riordinamento dei risultati sono gestiti da componenti specializzate e disponibili per l’integrazione commerciale.
Questo articolo è stato redatto con il supporto di strumenti di intelligenza artificiale (AI)